HiSpark Studio AI 用户指南#
前言#
本文介绍HiSpark Studio AI插件工具,如何通过该工具进行模型量化、模型转换、模型评估,以及后续应用开发等功能。
本文档主要适用于以下工程师:
技术支持工程师
AI开发工程师
在本文中可能出现下列标志,它们所代表的含义如下。
修改Hi3322的“ 量化历史显示界面 中”Accuracy字段详细说明。 |
||
HiSpark Studio AI简介#
关于HiSpark Studio AI#
HiSpark Studio AI是面向开发者提供的超轻量级AI应用开发平台,具备高集成、高专业、高易用等特征,聚焦嵌入式AI应用场景,提供模型量化、模型转换、应用开发、端侧部署、性能调优的全流程开发平台。
高集成
一站式开发平台,支持模型量化/转换/推理/部署/调试等功能。
统一的IDE界面和API接口,支持CPU/NPU等芯片AI应用开发和部署。
高专业
高效的模型量化,支持ONNX/TFLITE等AI模型。
超轻量的模型部署,支持KB级RAM嵌入式设备。
高易用
提供VS Code插件,方便安装和使用。
支持性能/精度可视化分析,方便调试。
功能介绍
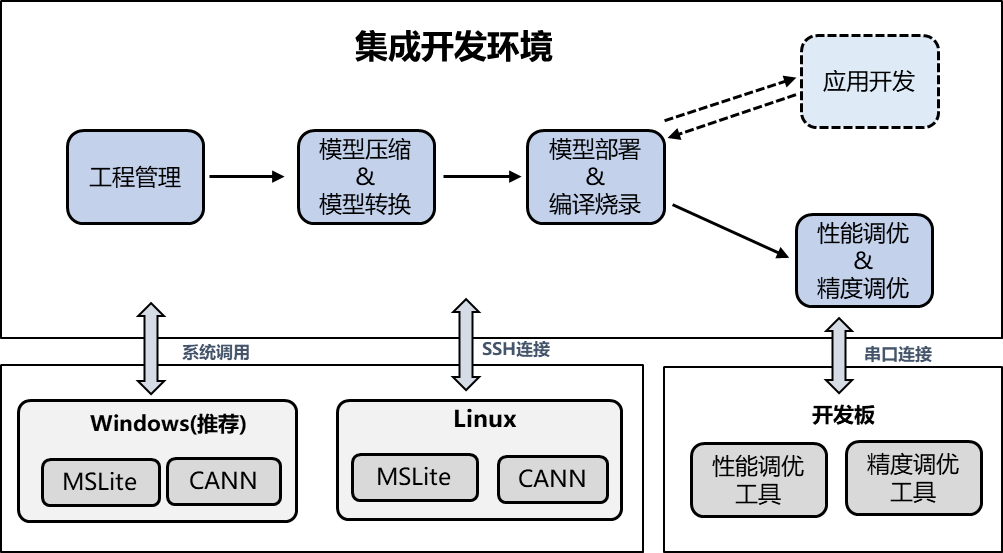
HiSpark Studio AI功能架构如图1所示。具备核心功能有:
导入ONNX/TFLITE等格式的AI模型,初始化开发环境。
通过集成的NPU/CPU工具链可以进行模型量化和转换。
导入SDK并参考Sample进行用户AI应用开发。
编译用户AI应用,烧录到嵌入式设备进行部署。
根据串口日志检测性能精度是否达成目标。
安装方案介绍#
须知:
若之前已经安装过DevEco相关的插件,请手动禁用或者卸载所有与DevEco相关的插件,否则会与HiSpark Studio插件功能冲突。
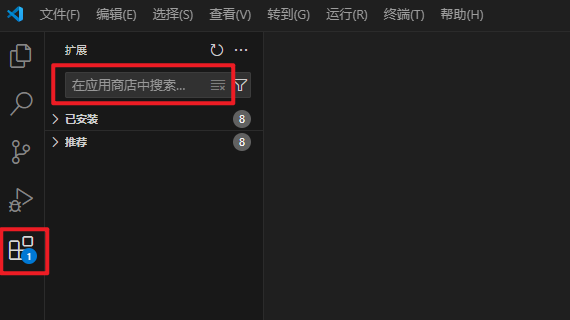
打开VS Code插件市场。
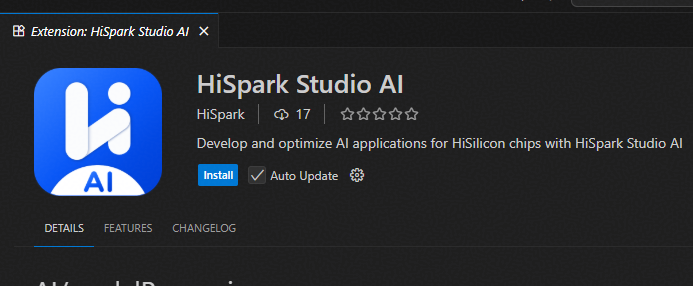
搜索并安装HiSpark Studio AI。
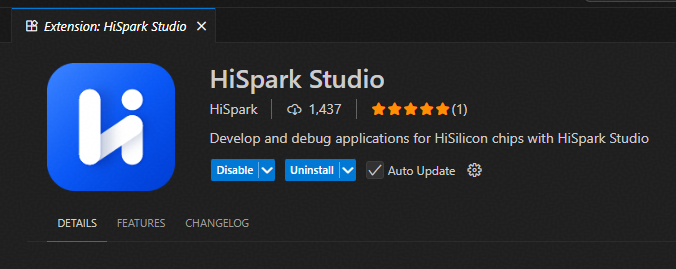
为保证功能正常运行,还需安装HiSpark Studio插件,需安装v26.4.1版本。
窗口介绍#
整体窗口介绍#
HiSpark Studio AI整体窗口如图1所示,主要包含两个部分:
侧边栏:HiSpark Studio AI功能导航栏。
工作区:HiSpark Studio AI工作区。
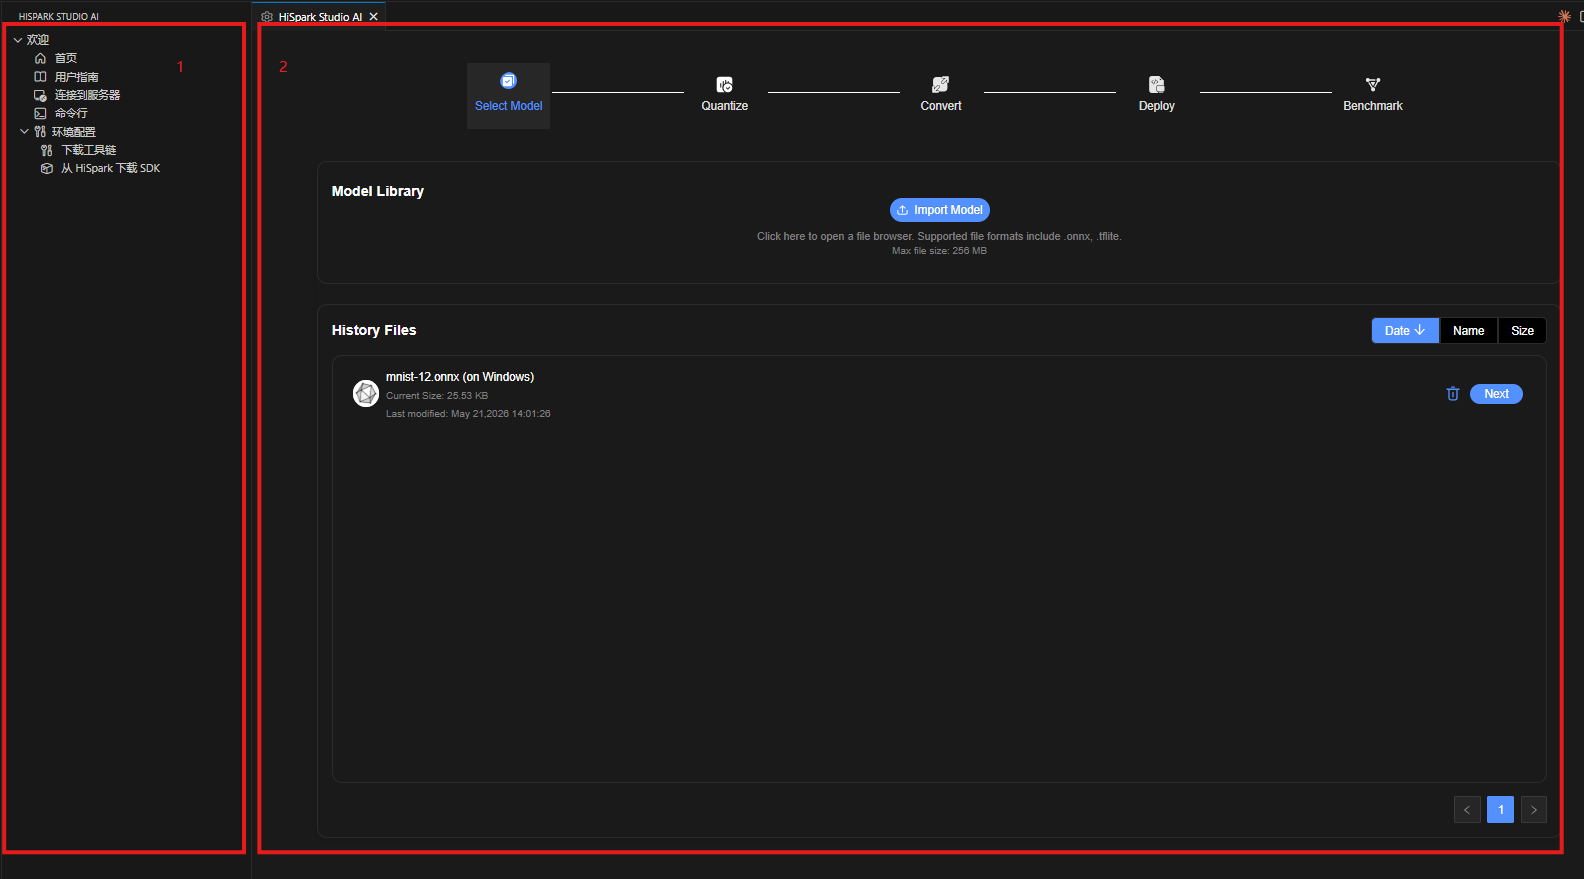
侧边栏#
侧边栏为功能导航栏,展示了HiSpark Studio AI插件提供的六个主要功能,分别为:
首页:单击进入新建/导入工程。
用户指南:单击在工作区打开用户指南,提供快速入门指南。
连接到服务器:单击连接至服务器。
命令行:单击在命令行中运行HiSpark Studio AI的量化、转换等功能。
下载工具链:单击下载运行HiSpark Studio AI插件所需要的工具链,并自动配置环境。
从HiSpark下载SDK:单击下载WS63 SDK并保存。
工作区#
工作区为插件核心功能展示区域,详细交互逻辑请参见后续章节。
关键概念#
本文档中涉及如下概念,在此处做统一说明。
AMCT#
AMCT(Ascend Model Compression Toolkit,简称AMCT)是一个针对昇腾芯片的深度学习模型量化工具包,提供量化、张量分解等多种模型量化特性,量化后的模型体积变小,部署到NPU IP加速器上后可使能低比特运算,提高计算效率,从而实现性能提升。有关AMCT具体操作请参考《AMCT模型量化工具用户指南》。
ATC#
昇腾张量编译器(Ascend Tensor Compiler,简称ATC)是CANN异构计算架构体系下的模型转换工具,它可以将开源框架的网络模型转换为NPU IP加速器支持的离线模型。有关ATC具体操作请参考《ATC离线模型编译工具用户指南》。
数据准备与环境搭建#
数据准备#
模型的训练后量化校准、量化感知训练、量化精度评估以及上板精度评估等操作需要对应数据,请按照如下格式准备数据:
环境搭建#
环境配置请参考《HiSpark.AI 快速入门指南》。
WS63操作指南#
工程创建#
约束说明#
界面介绍#
用户需要提前准备WS63 SDK解压到指定目录,一级目录包含application、tools等文件夹。
通常情况下,用户将“SDK”和“Project Path”设置为相同路径即可。如果用户有将“.hiproj”等项目文件与SDK文件夹分开放置的需求,可以创建一个新的文件夹,专门用于放置项目文件,并单独配置到“Project Path”中。
首页#
单击HiSpark Studio AI插件中的“Home”按钮,进入首页如图1所示。
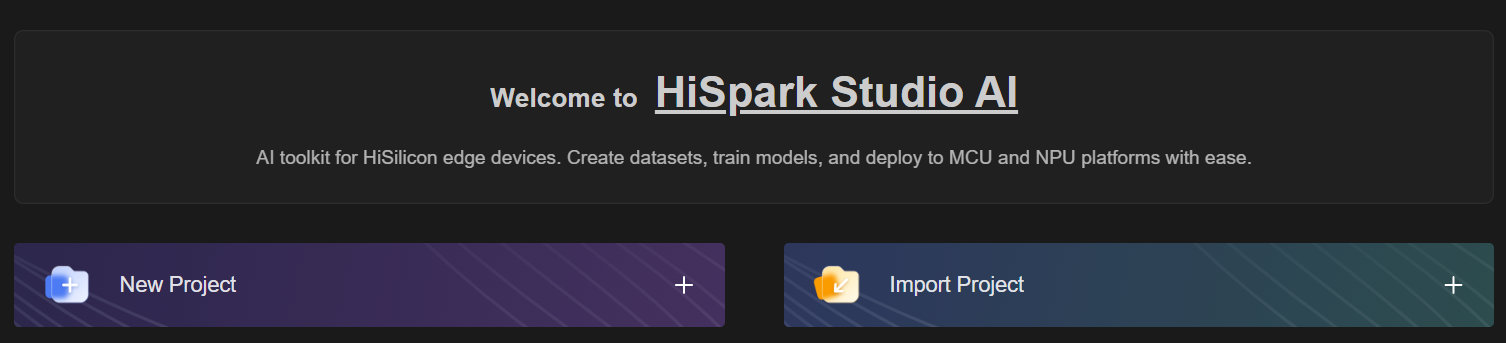
若用户首次使用HiSpark Studio AI,单击“New Project”即可创建新项目。若用户需要项目迁移,也可以选择“Import Project”导入已有项目。
新建工程配置界面#
选择芯片为WS63,选择已准备好的SDK目录,工程项目目录选择SDK相同路径即可。
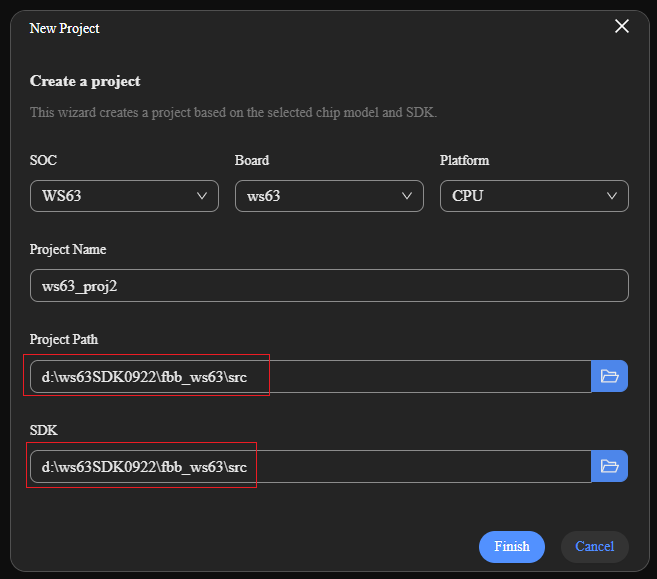
新建工程导入页面的具体逻辑如下,参数详细配置如表1所示。
选择芯片“SOC”为WS63,“Board”为WS63,“Platform”为CPU。
填写“Project Name”为项目名称。
配置“Project Path”以及“SDK”,一般情况下,配置为下载的SDK路径。
表 1 新建工程参数配置
模型导入#
模型导入主要帮助用户将本地已经训练好的ONNX模型或者TFLITE模型加载到HiSpark Studio AI中,并且记录之前的导入记录。
约束说明#
用户导入的模型有以下约束:
ONNX模型满足Opset版本小于等于18。
TFLITE推荐版本为Tensorflow 2.13。
ONNX以及TFLITE模型中的算子必须位于列表中,具体清单请参考《HiSpark. AI 转换工具 使用指南》。
目前仅支持浮点ONNX以及TFLITE模型,量化后的模型暂时不支持。
界面介绍#
整体界面#
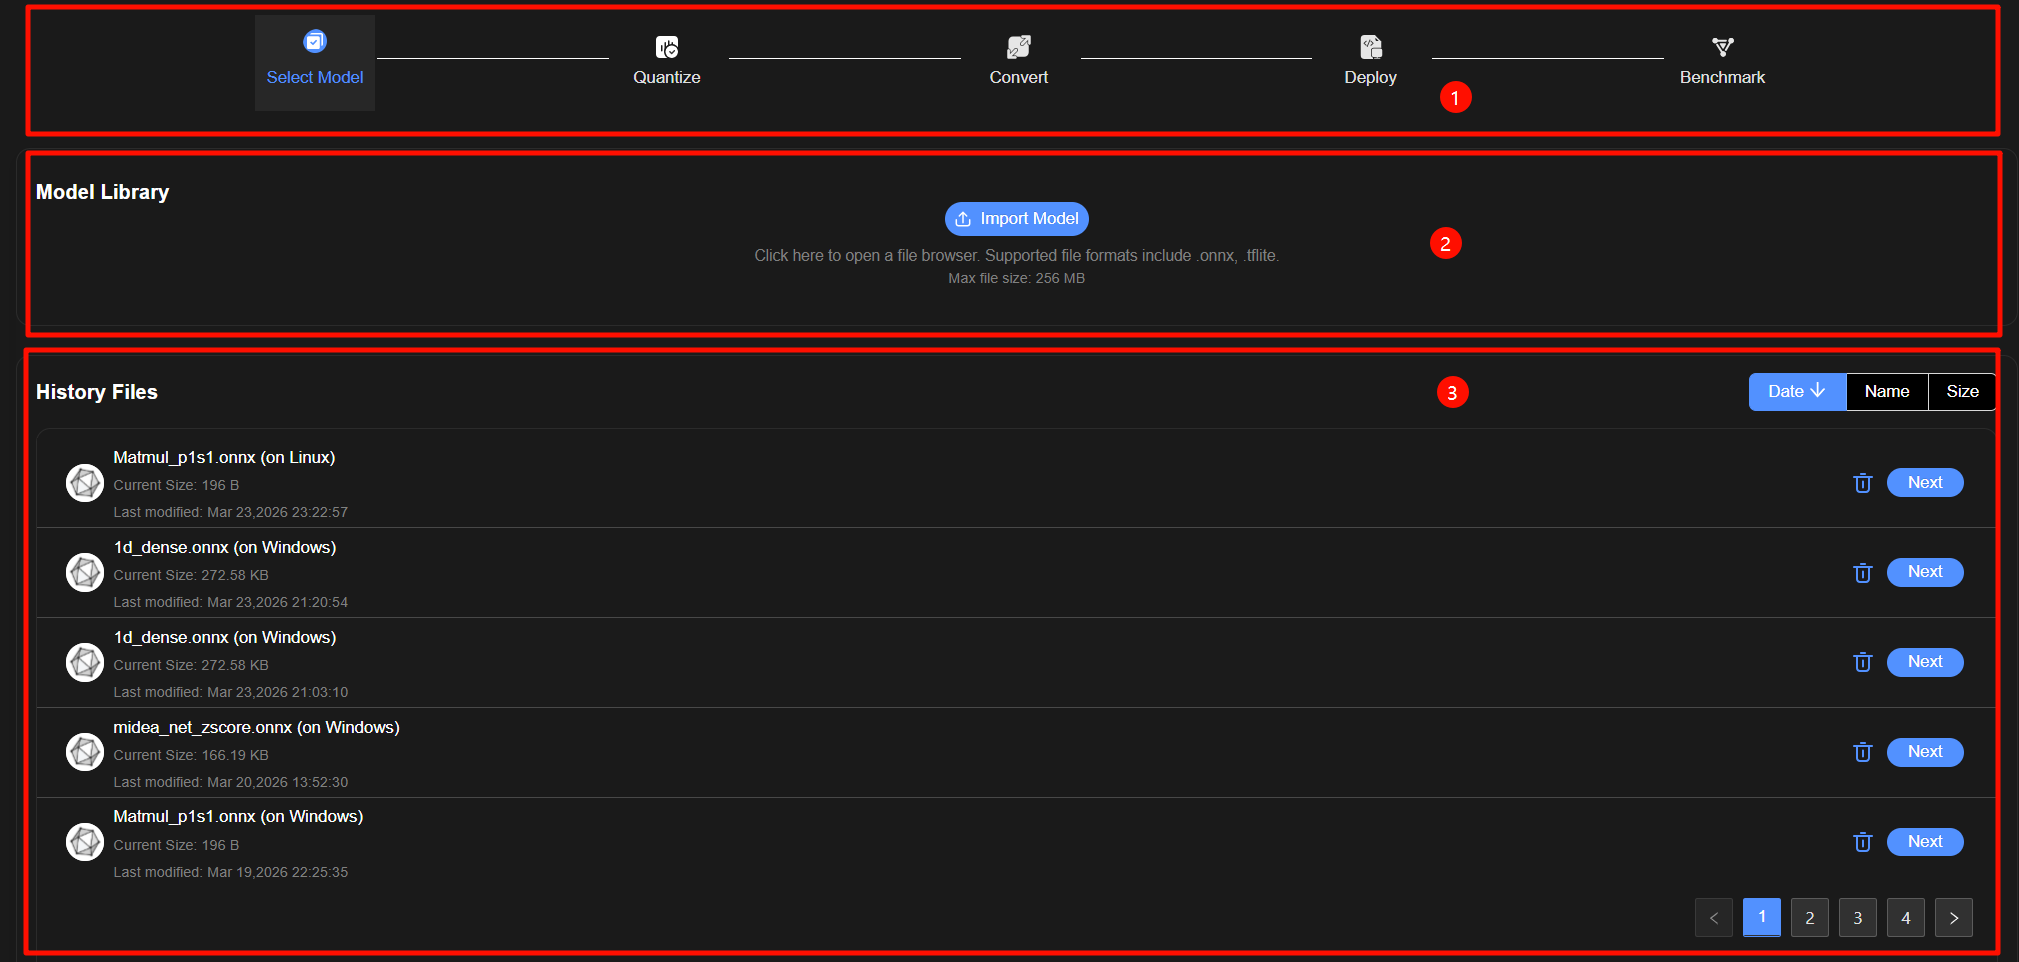
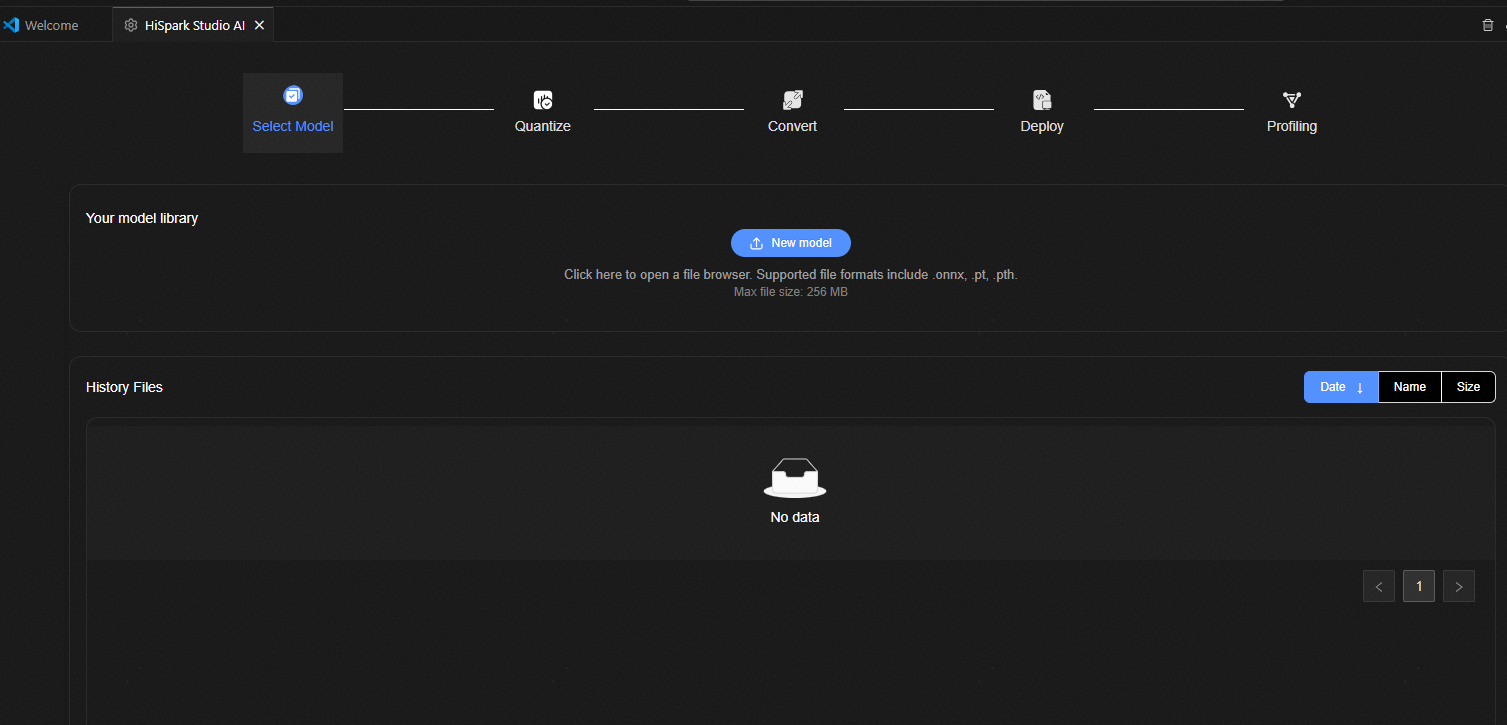
模型导入的界面如图1所示。主要包含以下部分:
跳转标签(Select Model —— Quantize —— Convert —— Deploy —— Benchmark),当存在历史操作记录时,完成界面的切换。
模型选择页面,用于选择部署目标模型。
历史模型选择记录页面,显示所有的选择过模型的大小、修改时间,并提供回溯历史步骤以及删除功能。
模型导入步骤如下:
进入模型选择页面,单击“Import Model”按钮,选择对应的Mnist ONNX模型,测试模型请参考Mnist-12.onnx。
模型导入结束,进入量化页面。
Linux导入配置界面(仅Linux端用户需要关注)#
首次单击“Import Model”按钮,需要用户填写服务器相关配置,用于连接远端服务器(需要先按照《Hispark.AI 快速入门指南》的“3.3.2 Linux服务器端环境准备(仅Linux端用户关注)”进行配置环境)。
单击“仅命令传输 & 待定文件下载连接”按钮。
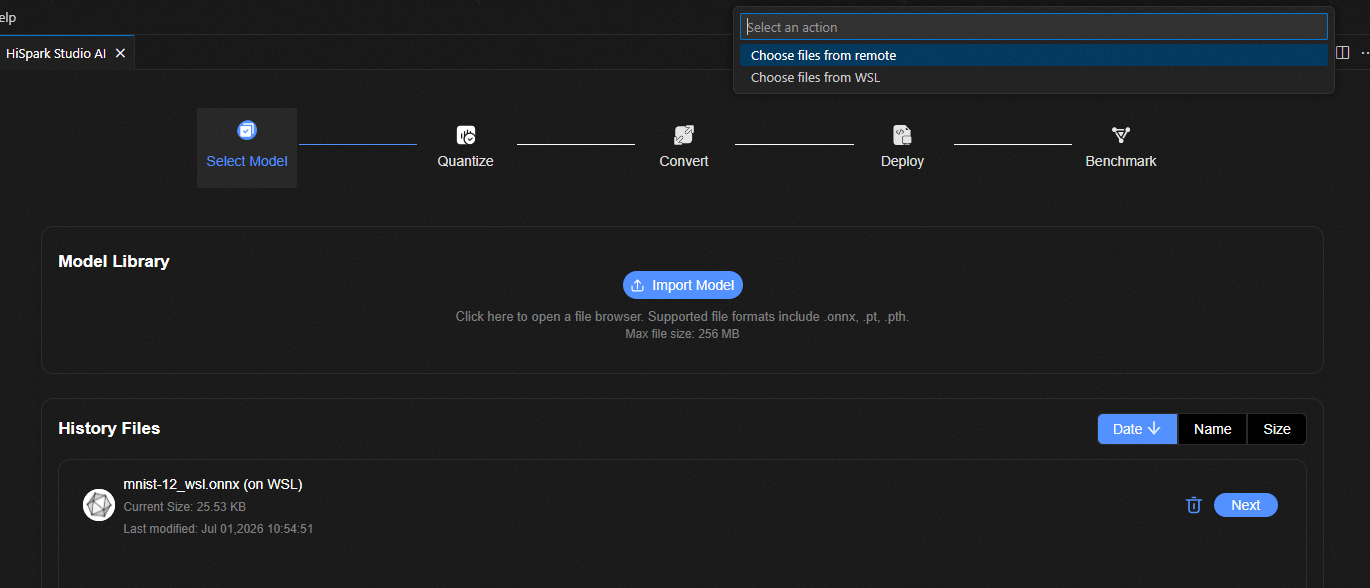
如需从ModelZoo下载官方模型,参见“ModelZoo模型下载”。
模型量化#
约束说明#
在进行模型量化前,有以下约束:
模型量化仅针对ONNX以及TFLITE两种格式的模型。
模型量化仅支持未进行过量化的模型,已量化完成的ONNX以及TFLITE不支持。
任何网络都会被处理为分类网络,带标签的量化精度准确率评估仅针对网络输入为[N, D]格式。
量化前提#
用户需要准备模型量化的输入数据(Linux用户需要提前将数据放置到Docker环境所在的服务器上),可参考《快速入门指南》的“样例运行”章节准备。
界面介绍#
整体界面#
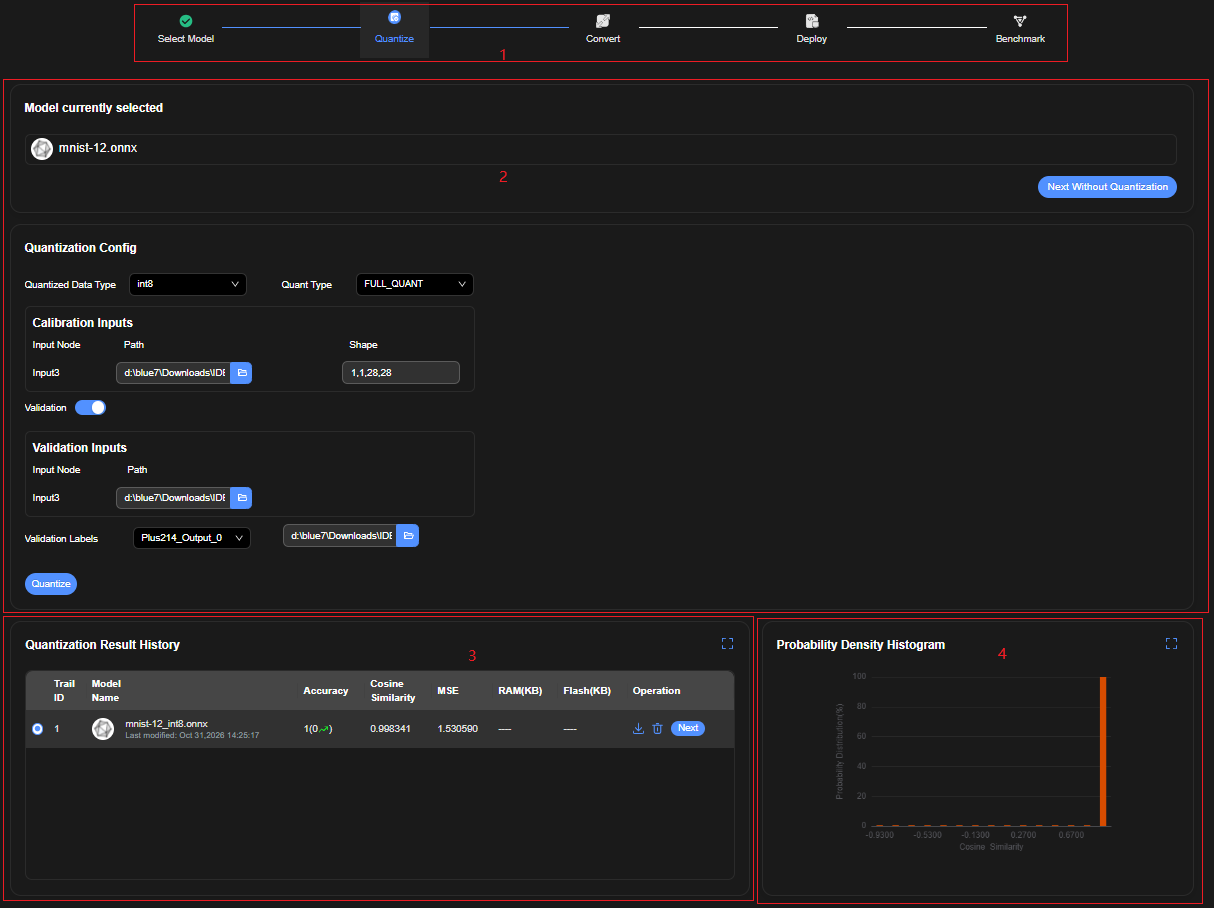
模型量化界面如图1所示,整体界面主要包含四个部分:
跳转标签页面,能否跳转到该量化记录关联的前后步骤。
量化参数配置界面。
量化历史显示界面,显示所有的量化网络余弦相似度、MSE、准确率等指标。
样本精度分布直方图显示界面,显示验证集量化输出与浮点标杆相似度的直方图界面。
量化步骤如下:
量化参数配置页面#
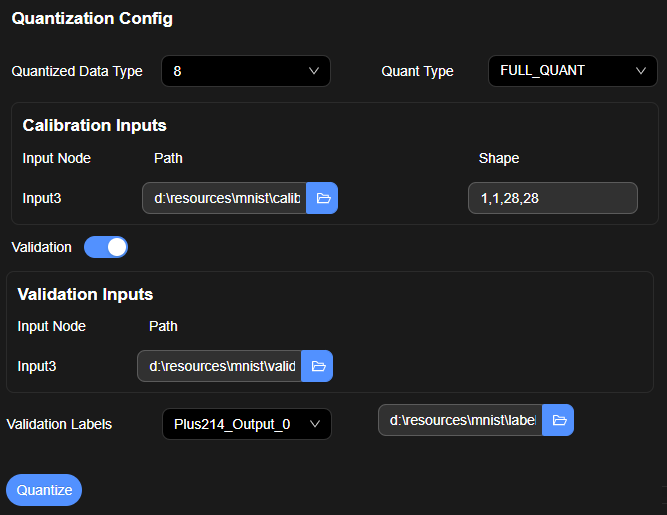
参数解释如表1所示。
表 1 量化参数配置
|
|
用户在该表格中输入量化的校准数据。表格中各列的含义如下所示:
|
|
使能验证开关。当开关打开时,验证数据集输入界面展开,如图3所示。 |
|
用户在该表格中输入量化评估网络的验证数据集。表格中各列的含义如图3所示:
|
|
使能开关打开后,输入含分类真值标签的csv表格文件。文件中的表格格式如表1所示。各列的含义如下所示:
|
|

单击“Next Without Quantization”按钮,即可跳过量化步骤,直接转换成浮点模型。
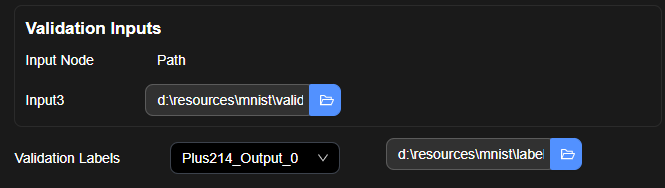
Validation Labels输入csv格式请参考“数据准备”。
量化历史配置界面#
量化历史显示窗口如图1所示。
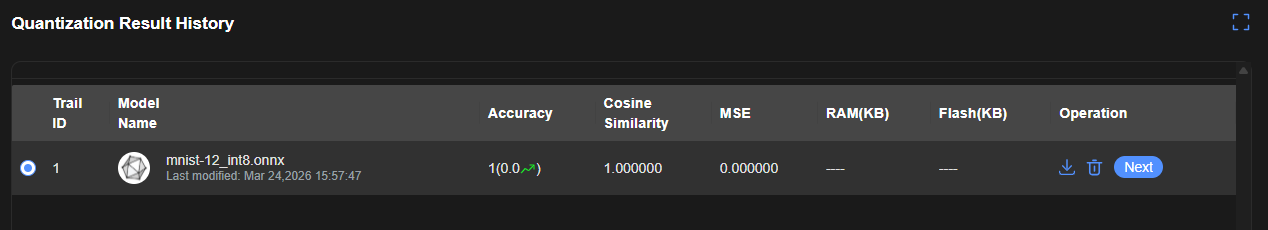
该窗口以表格的方式显示历史量化的结果。表头解释如表1所示。
表 1 历史压缩结果表头说明


验证集精度分布直方图显示界面#
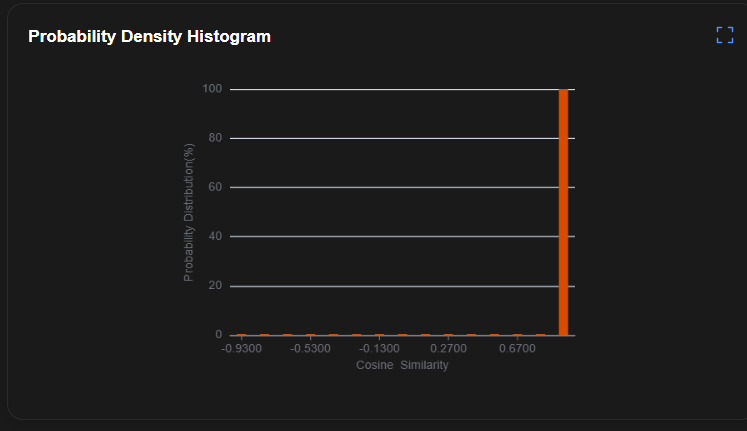
验证集精度分布直方图显示窗口如图1所示,该窗口显示验证集的余弦相似度的分布图。横轴为余弦相似度,纵轴为验证集样本的百分比。
模型转换#
约束说明#
转换前提#
用户已成功完成量化或跳过量化,且量化所用的校准数据位置不改变。
界面介绍#
整体界面#
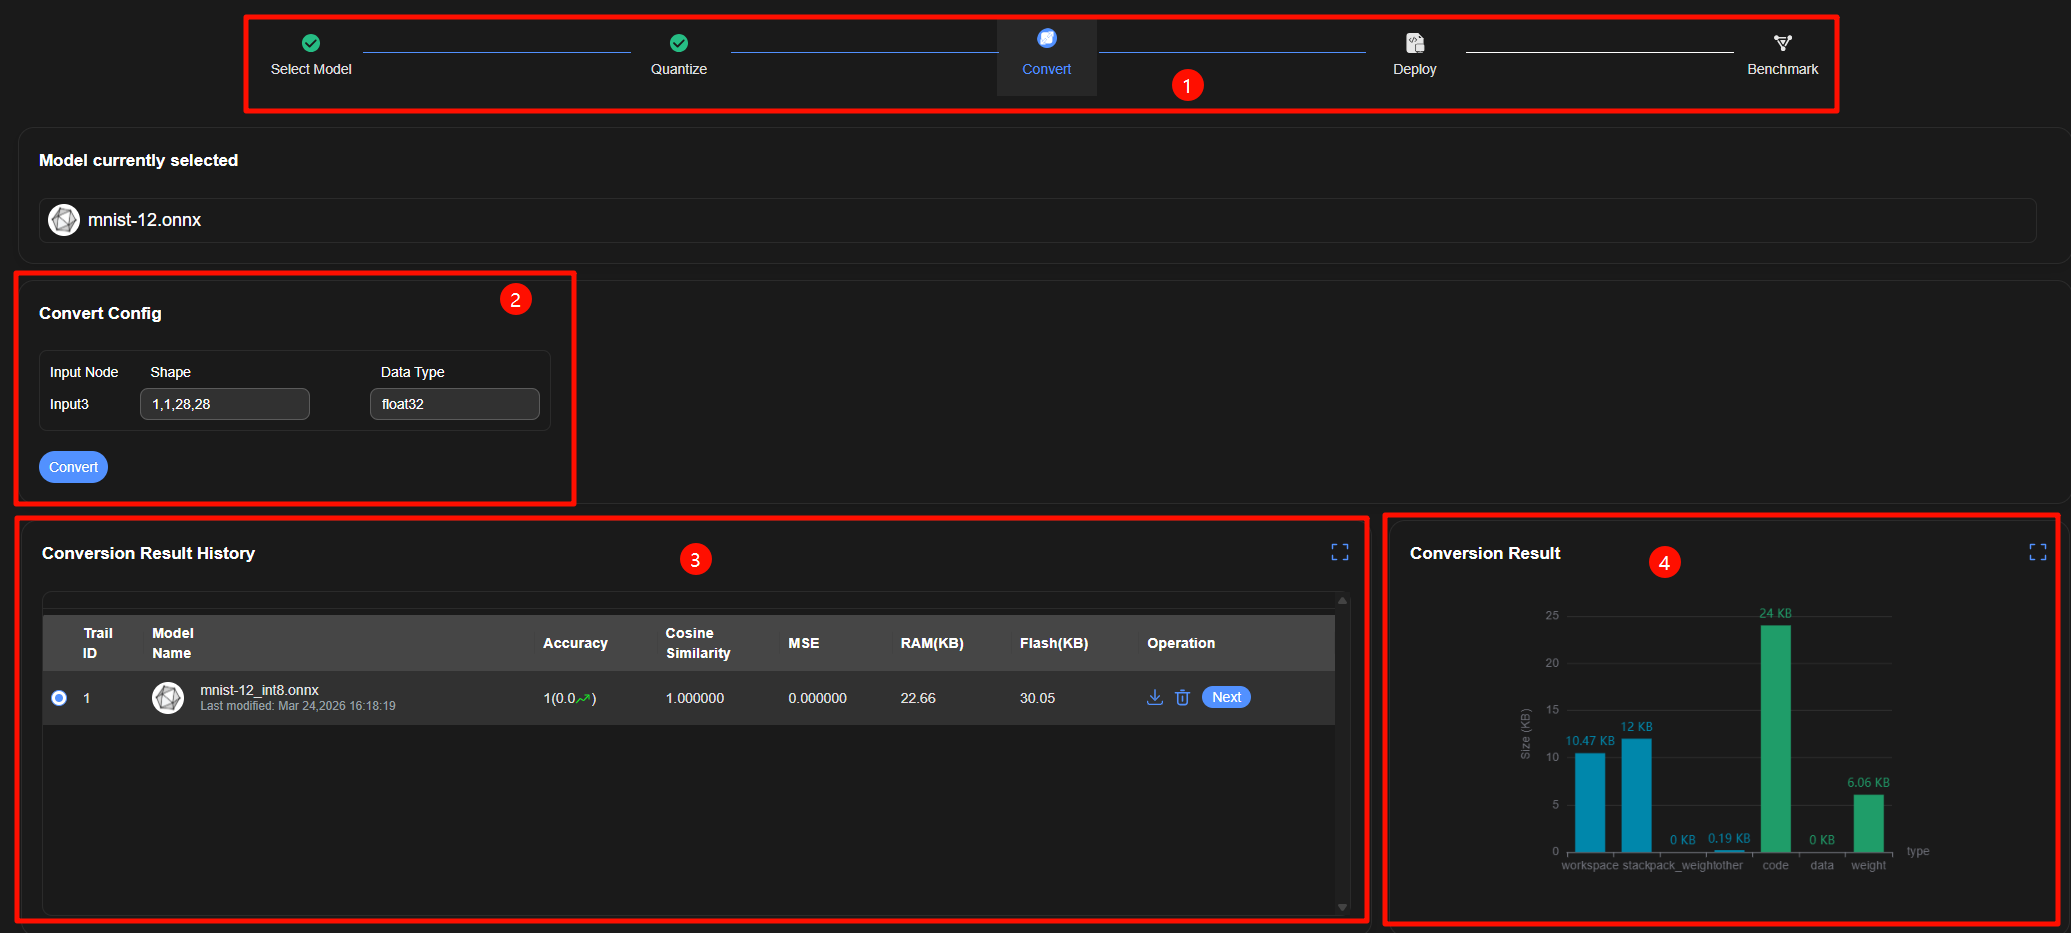
模型转换整体界面如图1所示,主要包含四个部分:
跳转标签页面,能否跳转到该量化记录关联的前后步骤。
转换参数配置界面。
历史转换记录配置界面,显示所有的转换网络余弦相似度、MSE、准确率、RAM、FLASH等指标。
转换结果RAM/FLASH对比界面,显示模型转换预估上板的各项RAM/FLASH估计。
转换步骤:
进入转换页面,配置转换参数,参数详情详见“转换参数配置页面”。
单击“Convert”按钮,输出转换RAM/FLASH等结果。
单击“Next”进入下一步。
转换参数配置页面#
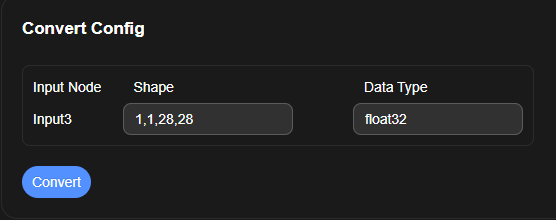
参数说明如表1所示。
表 1 转换参数配置
转换历史配置界面#
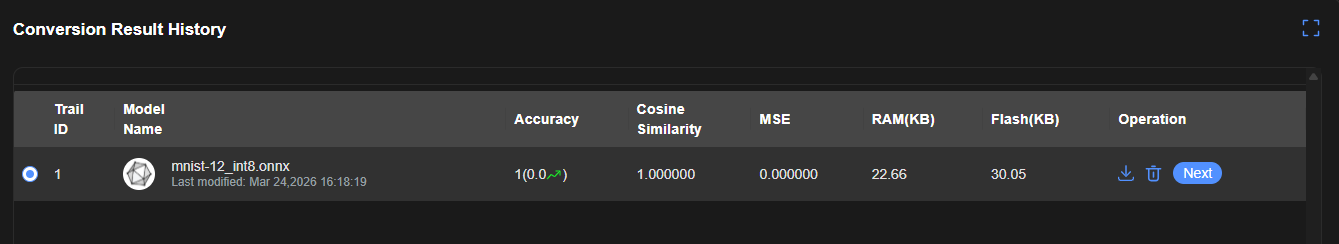
该窗口以表格的方式显示历史转换的结果。表头说明如表1所示。
表 1 历史转换结果表头说明
|
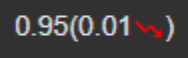
准确率表示的格式:{量化模型准确率}({量化模型与原始浮点模型准确率对比}) |
|



内存占用分布条形图显示界面#
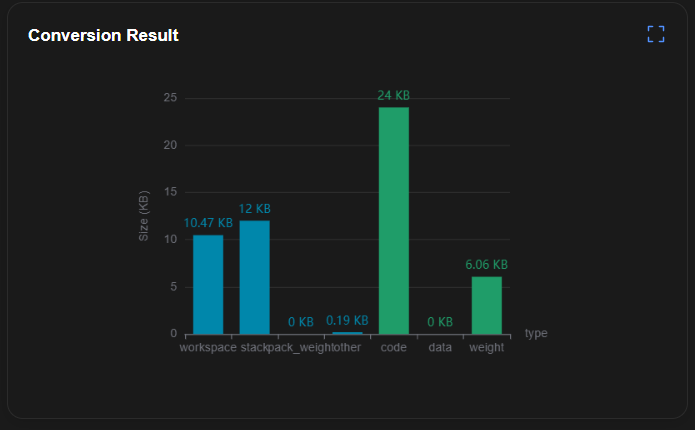
AI上板存储占比如图1所示,蓝色显示为RAM占用,绿色显示为FLASH占用,各参数显示具体含义如表1所示。
表 1 内存占用分布条形图各项含义
部署#
约束说明#
WS63模型部署需要满足以下条件: 用户必须已成功完成模型转换。
界面介绍#
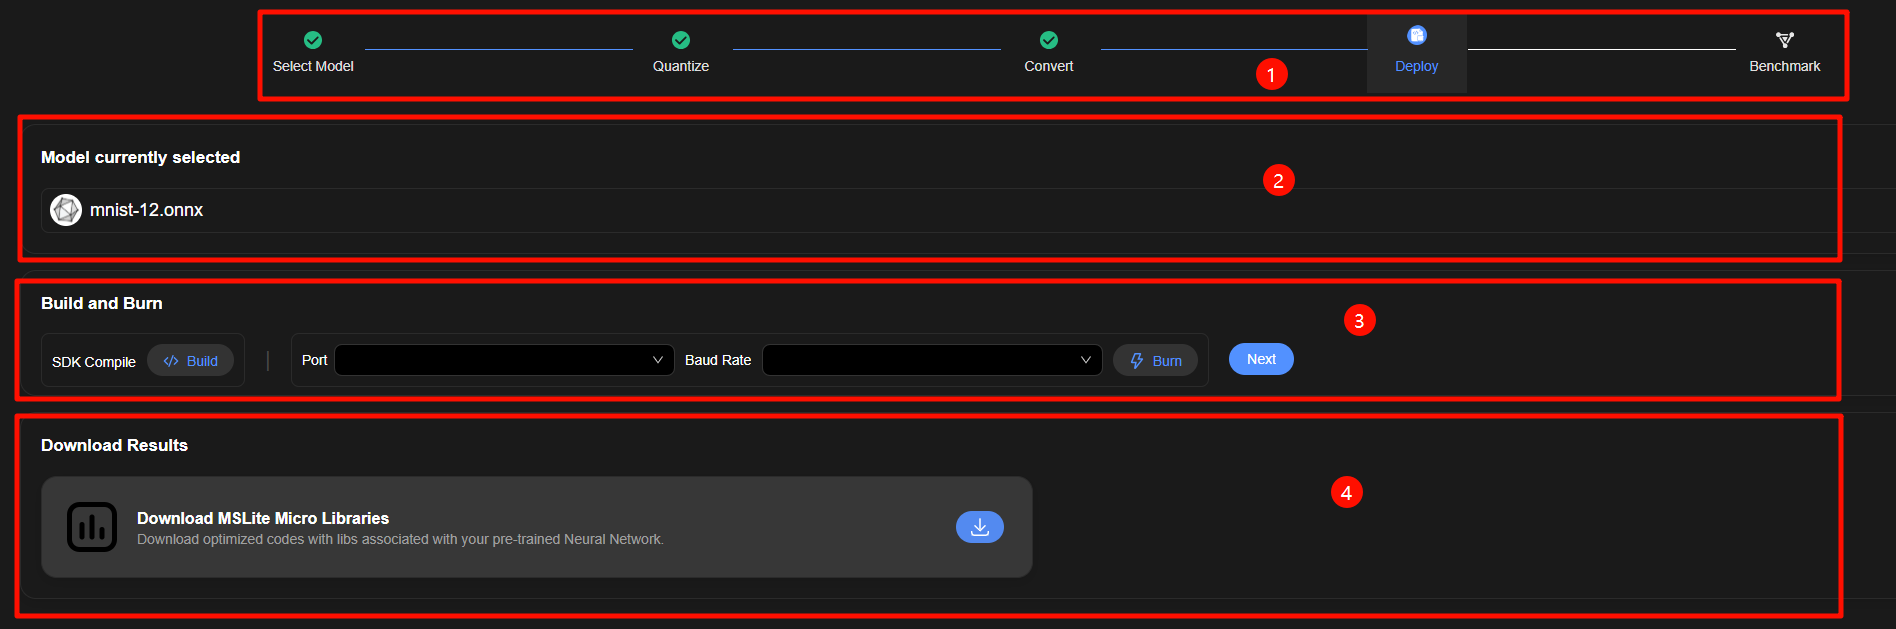
模型部署整体界面如图1所示,主要包含四个部分:
跳转标签页面,能否跳转到该量化记录关联的前后步骤。
模型选择页面,展示已选中的模型。
SDK编译以及烧录页面。
转换产物下载页面。
转换步骤如下:
单击界面上SDK Compile右侧的“Build”按钮,进行SDK的编译。
选择对应的Port以及Baud Rate,单击界面上的“Burn”按钮,完成固件烧录。
单击“Next”按钮,进行下一步性能 & 精度验证。
模型调优#
约束说明#
WS63模型调优需要满足以下约束条件:
用户需要保证SDK的完整性,确保AI组件(Adaptor 以及 AI_AT组件)包含在SDK中。
用户需要保证单个样本的输入数据量总和小于4K。
用户需要准备一块WS63单板,并且使用USB串口线与本地PC连接。
调优前提#
用户已完成模型转换步骤。
界面介绍#
整体界面#
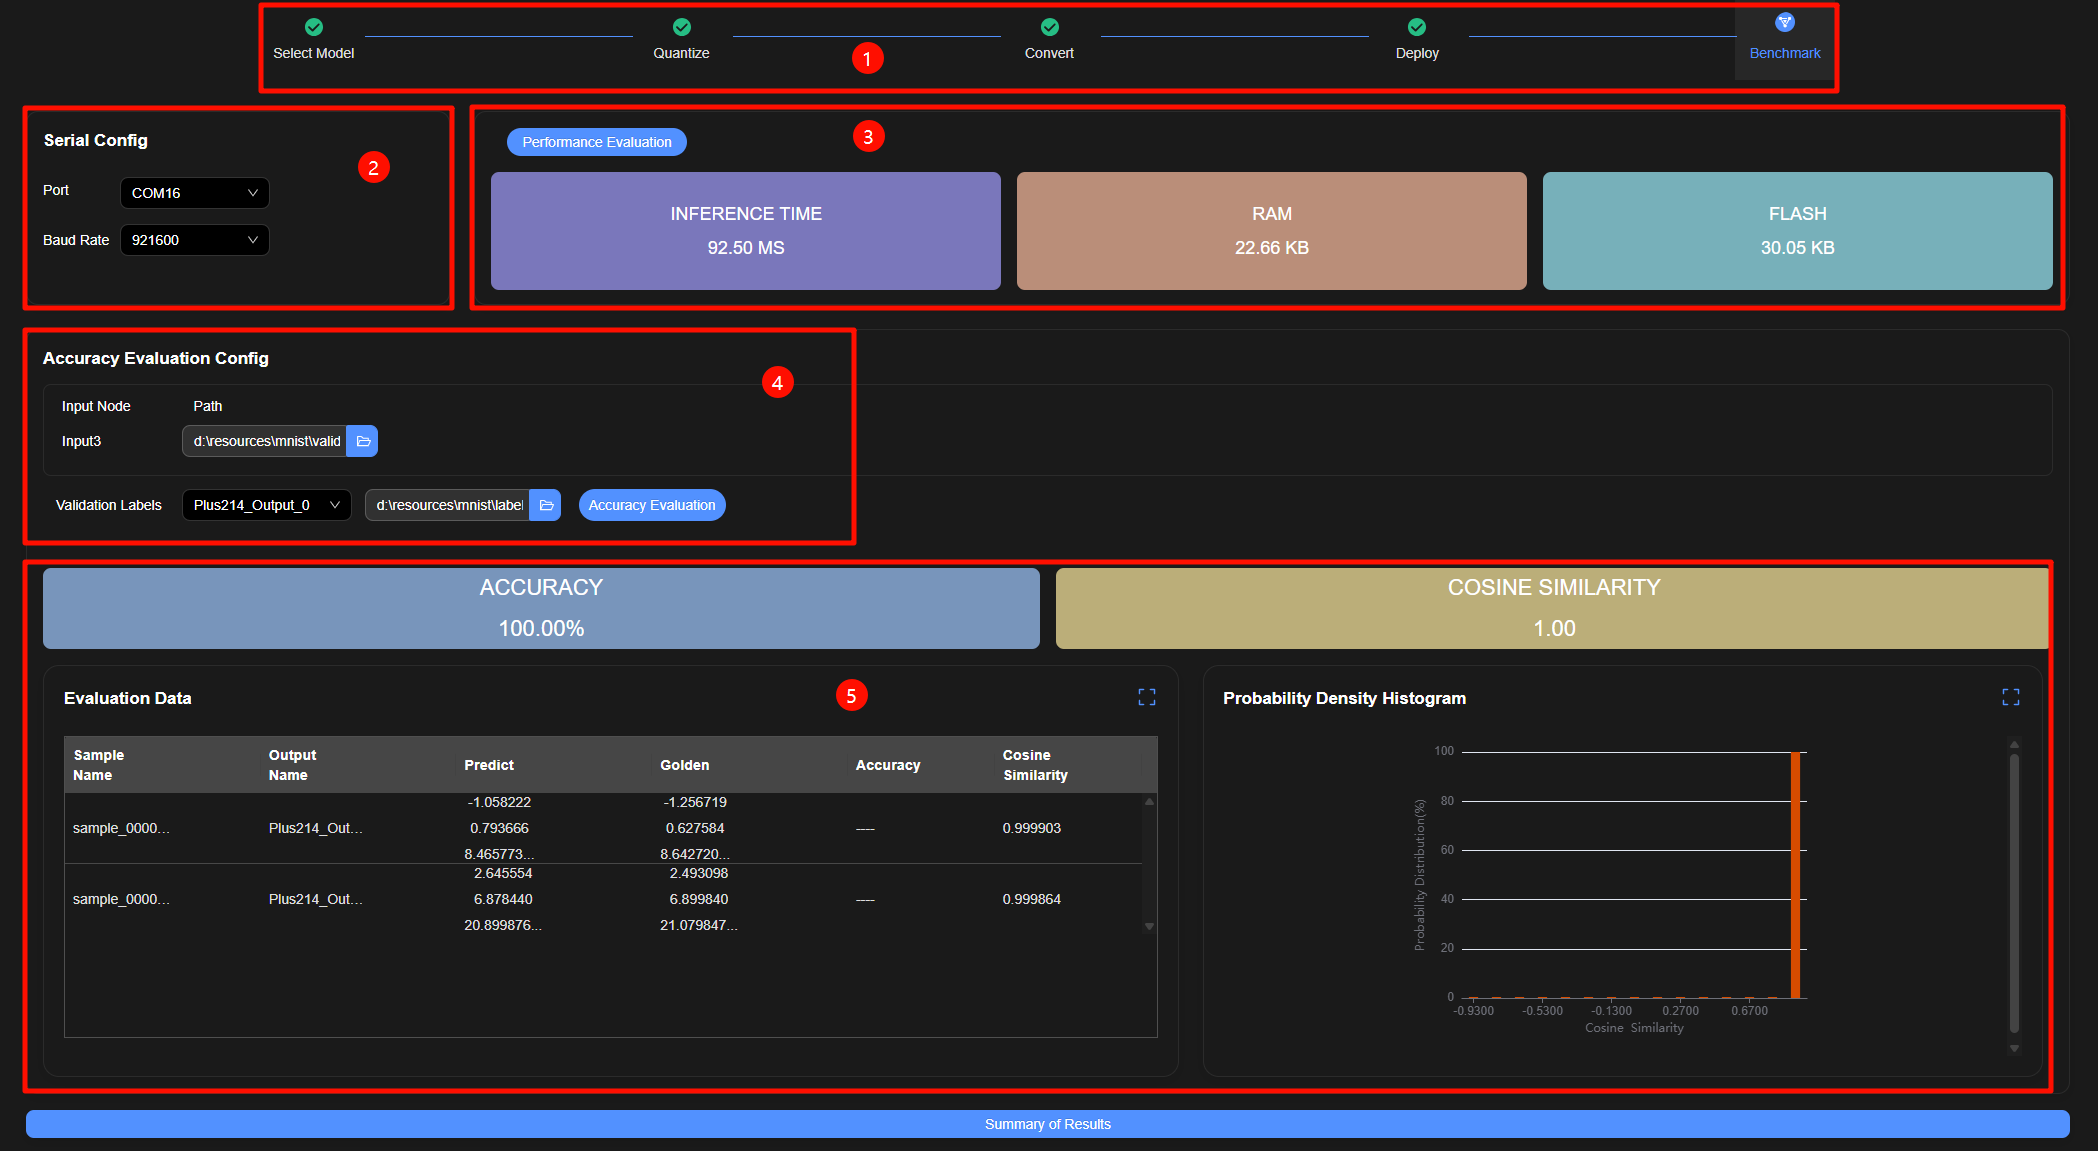
模型调优界面如图1所示,主要包含五个部分:
跳转标签页面,能否跳转到该量化记录关联的前后步骤。
性能验证参数配置页面,配置相关的串口连接相关选项。
性能验证结果评估页面,显示AI上板推理时间、RAM内存消耗、FLASH内存消耗等信息。
精度验证参数配置页面,配置相关的精度验证输入数据输入等信息。
精度验证结果评估页面,显示上板精度评估余弦相似度分布直方图 & 准确率等信息。
模型调优步骤如下:
进入模型调优页面,选择单板连接的串口以及波特率。
单击“Performance Evaluation”按钮,输出上板推理时间、RAM内存消耗、FLASH内存消耗等信息。
选择Windows本地相应的验证数据输入文件夹等精度验证相关的选项。
 说明:
上板精度验证需上传存放有npy格式文件的文件夹。
单击“Accuracy Evaluation”按钮,输出相关的准确率、余弦相似度分布以及上板推理的时间、精度等信息。
性能验证参数配置页面#
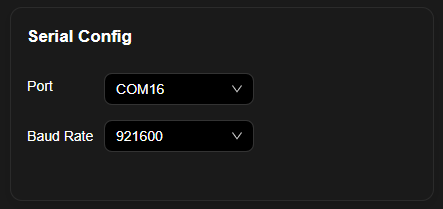
参数解释如表1所示。
表 1 转换参数配置
性能验证结果配置页面#
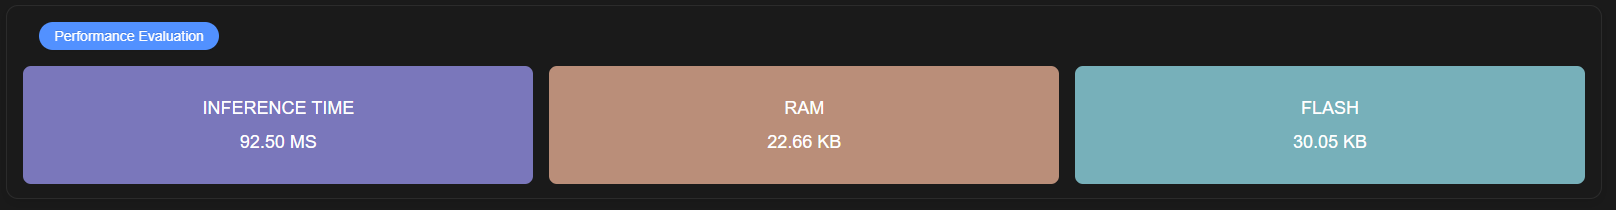
具体每个参数含义如表1所示。
表 1 性能验证结果
精度验证参数配置页面#
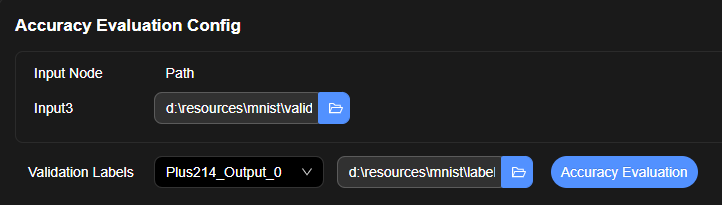
参数解释如表1所示。
表 1 转换参数配置
精度验证结果配置页面#
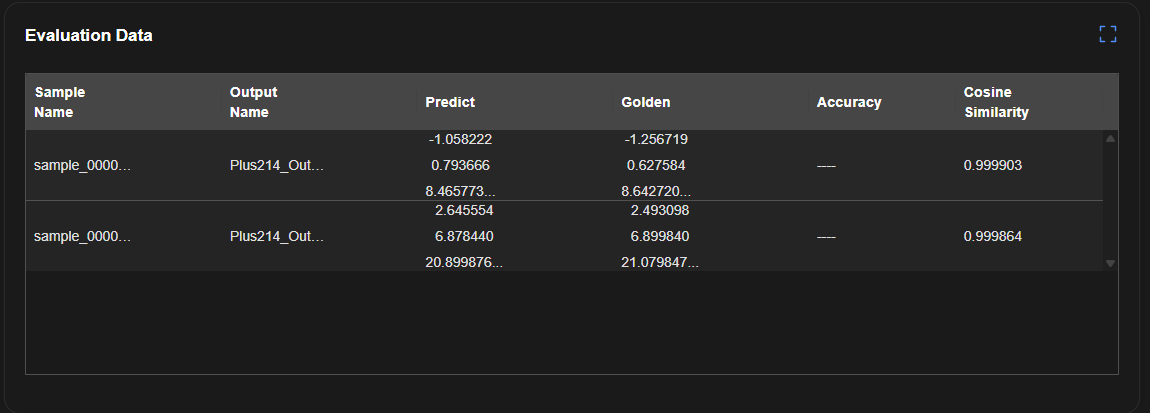
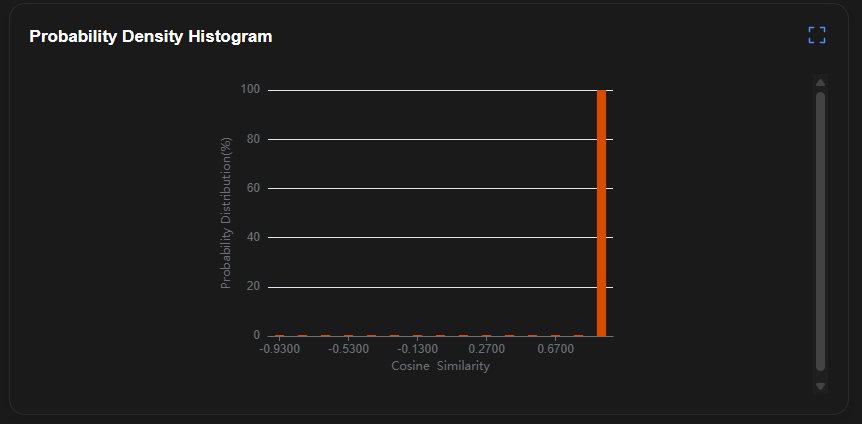
上板精度验证结果页面主要分为以下三部分:
准确率信息
逐项结果展示
余弦相似度分布直方图
各参数如表1所示。
表 1 上板精度验证结果说明

评估结果汇总页面#
单击“Summary of Results”按钮之后弹出评估结果汇总界面,该界面汇总每次评估的结果。如图1所示。
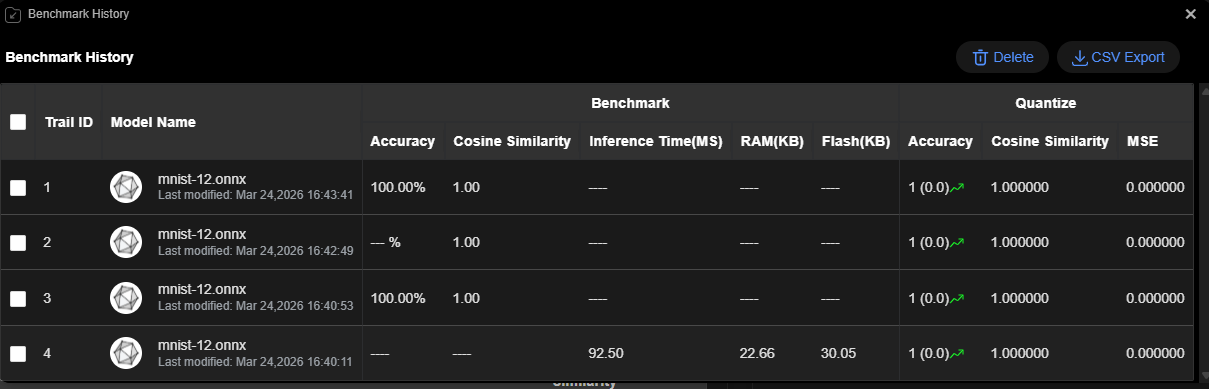
评估结果汇总界面元素说明如表1所示。
表 1 评估结果界面元素说明
模型上板精度评估的平均余弦相似度,计算公式如下,其中 |
||
模型量化的均方误差,计算公式如下,其中 |


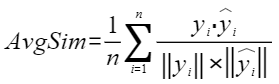


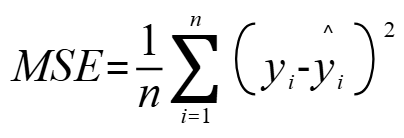
应用开发#
在HiSpark Studio AI中完成模型量化、转换之后,将模型导出并使用HiSpark.AI API完成应用开发。具体步骤如下。
Hi3322操作指南#
工程创建#
前提条件#
在工程创建前,请先获取Hi3322 SDK,并存放于本地Windows环境。SDK存放路径请勿带空格。
界面介绍#
进入HiSpark Studio AI单击“New Project”按钮进入新建工程页面。工程创建整体界面如图1所示。
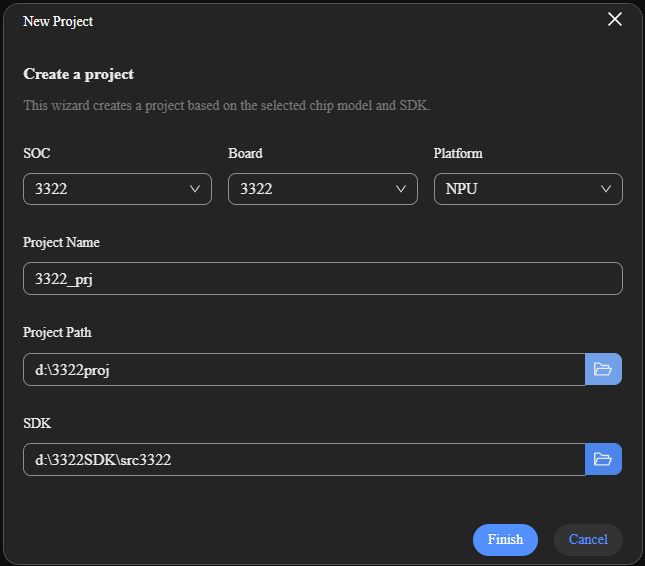
工程创建的步骤如下所示:
选择3322 SOC。
输入工程创建配置参数。
单击“Finish”按钮。
工程创建界面元素说明如表1所示。
表 1 工程创建元素说明
模型导入#
约束说明#
在进行模型导入前,请务必查看如下约束要求: Hi3322平台只支持导入ONNX以及pt、pth模型。ONNX模型支持训练后量化。pt、pth模型支持量化感知训练。
前提条件#
完成Linux服务器环境配置或者WSL环境配置。
连接Linux服务器或者WSL环境,若未完成连接,在单击“Import Model”按钮时会弹出Linux服务器或者WSL连接窗口。
若使用Linux服务器,将待处理的网络模型上传至Linux服务器。
界面介绍#
模型导入界面整体界面如图1所示。
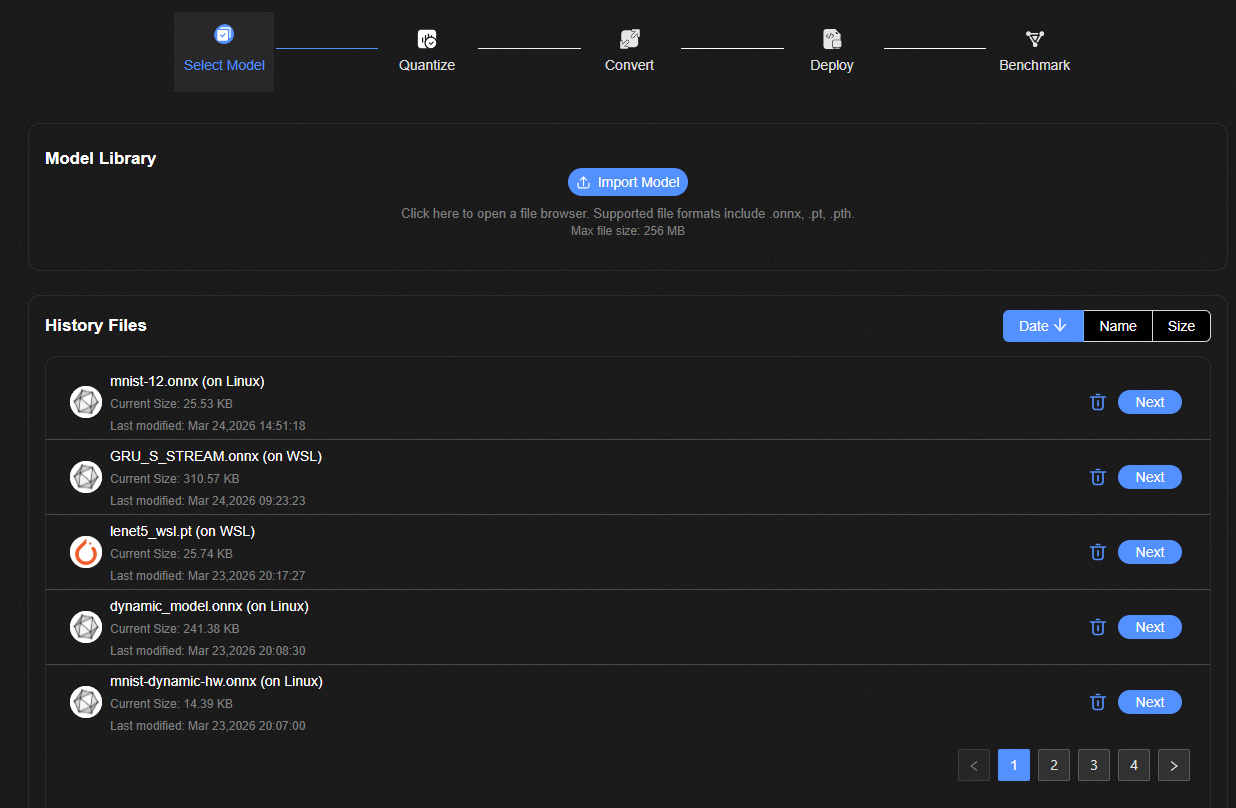
模型导入界面主要元素说明如表1。
表 1 模型导入主要元素说明
如需从ModelZoo下载官方模型,参见“ModelZoo模型下载”。
模型量化#
约束说明#
在进行模型压缩前,请务必查看如下约束要求:
支持原始框架类型为ONNX的模型训练后量化PTQ。
支持原始框架类型为PyTorch(参数后缀pt或pth)的模型量化感知训练QAT。
只支持单输出分类网络计算量化评估网络的准确率。
量化感知训练只支持单输入单输出分类网络。
量化前提#
界面介绍#
整体界面#
量化的整体界面如图 量化整体界面所示。
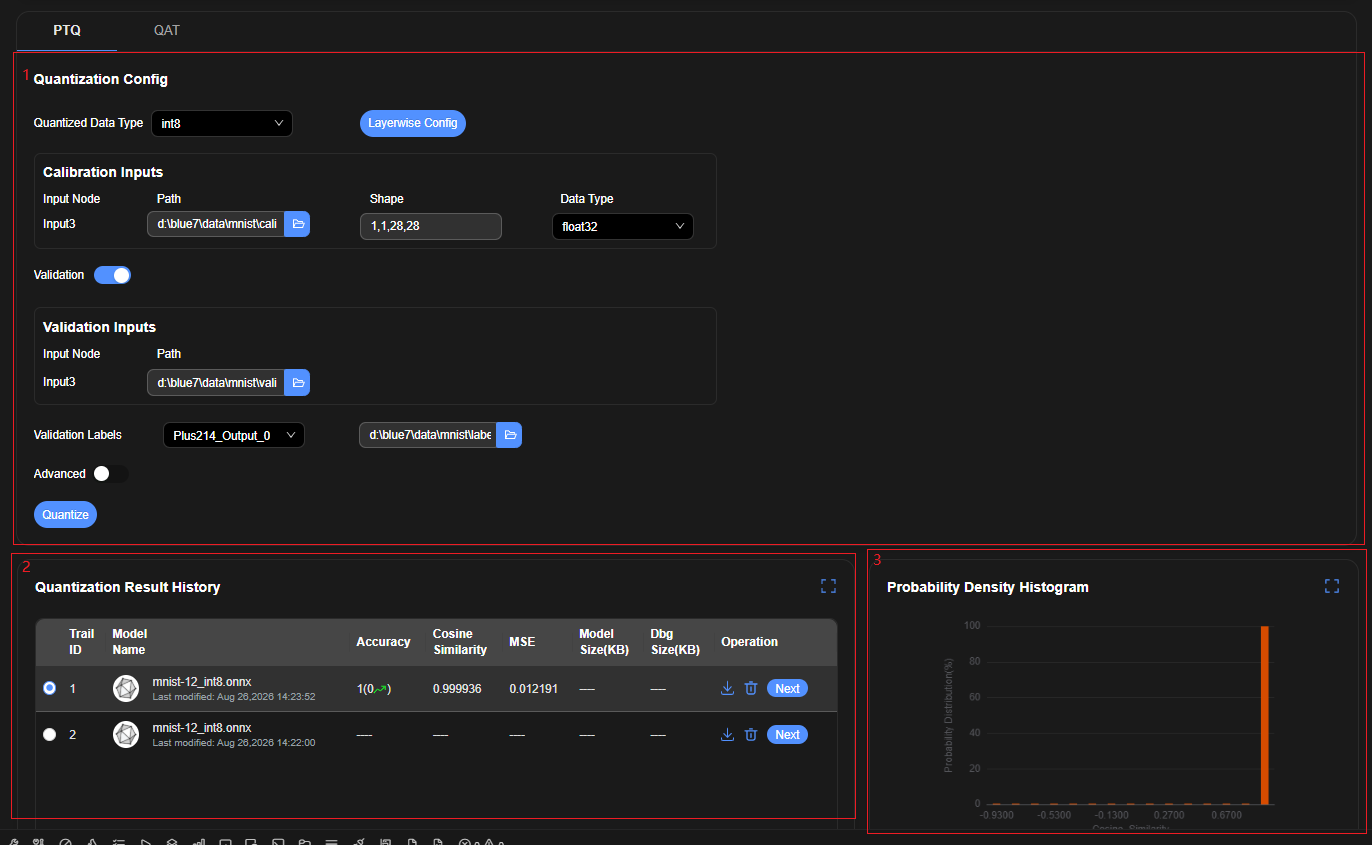
模型量化整体界面如图1所示,主要包含三个部分:
量化参数配置界面。
压缩历史显示界面,显示所有压缩的网络及其精度指标。
样本精度分布直方图显示界面,显示验证集的精度分布。
执行量化步骤如下:
在量化参数界面配置量化参数。
单击“Quantize”按钮。
压缩历史显示界面查看压缩的结果。如果使能了量化精度验证,在该表格中显示量化精度验证评估结果。
如果使能了量化精度验证,在样本精度分布直方图显示界面中查看验证集精度分布直方图。
压缩历史显示界面中选择待转换的量化模型,单击“Next”按钮进入模型转换界面。
量化参数配置界面#
训练后量化#
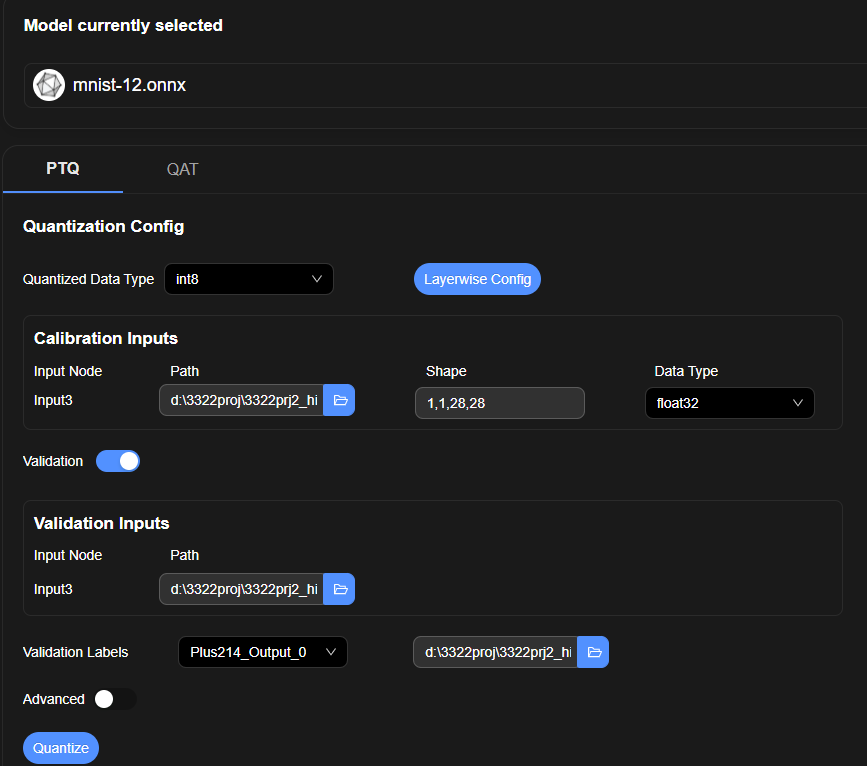
训练后量化量化参数配置窗口如图 量化参数配置界面所示。
参数解释如表1所示。
表 1 训练后量化参数配置界面参数
模型量化类型。当配置为int8时,转换后模型占用空间相对较小,推理速度相对较快,精度损失相对更大。当配置为int16时,转换后模型占用空间相对较大,推理速度相对较慢,精度损失相对小。 |
|
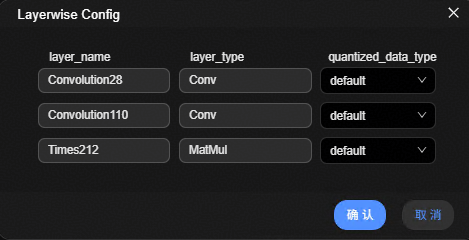
打开逐层量化配置窗口。逐层量化类型配置窗口如图2所示。表格中各列的含义如下所示:
|
|
用户在该表格中输入量化的校准数据。表格中各列的含义如下所示:
|
|
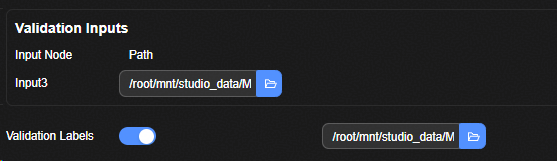
使能验证开关。当开关打开时,验证数据集输入界面展开,如图3 验证集输入界面示。 |
|
用户在该表格中输入量化评估网络的验证数据集。表格中各列的含义如下所示:
|
|
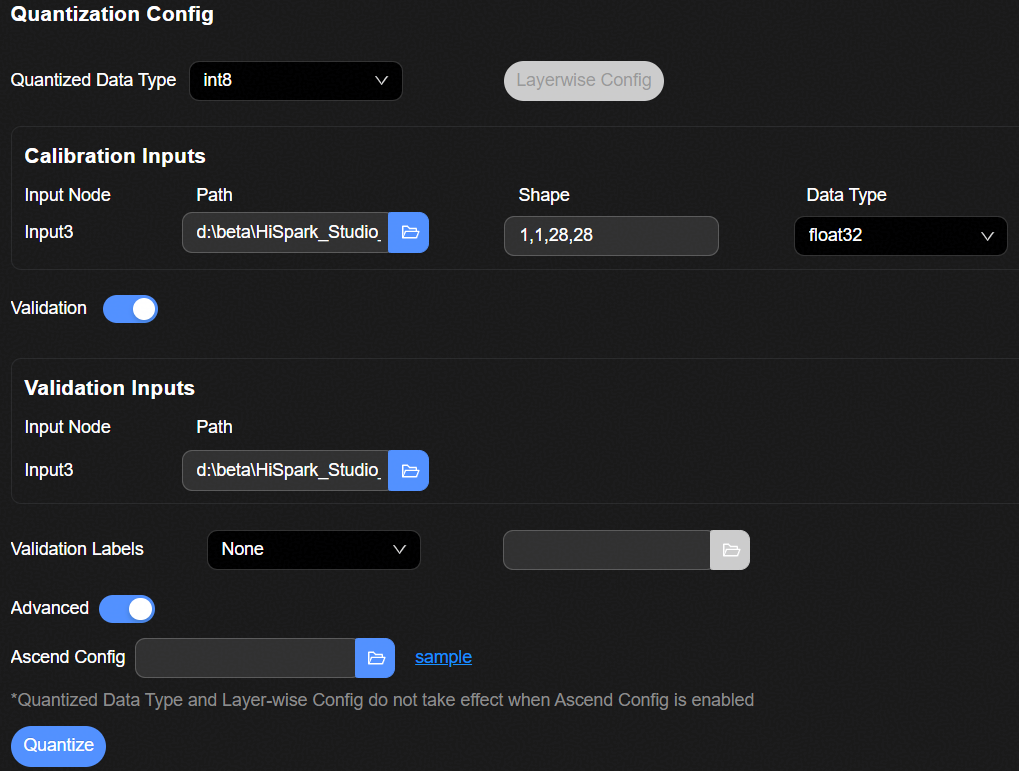
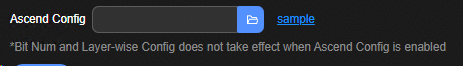
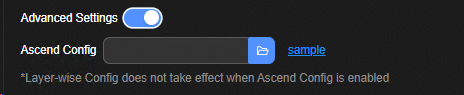
高级模式使能开关。当开关打开时,高级模式界面展开,如图4所示。 |
|
高级模式量化配置文件输入控件。在该输入控件中输入昇腾量化配置cfg文件。昇腾量化配置文件编写格式参见文档《AMCT模型压缩工具用户指南》。单击 |
|

量化感知训练#
量化感知训练参数配置窗口如图1所示。
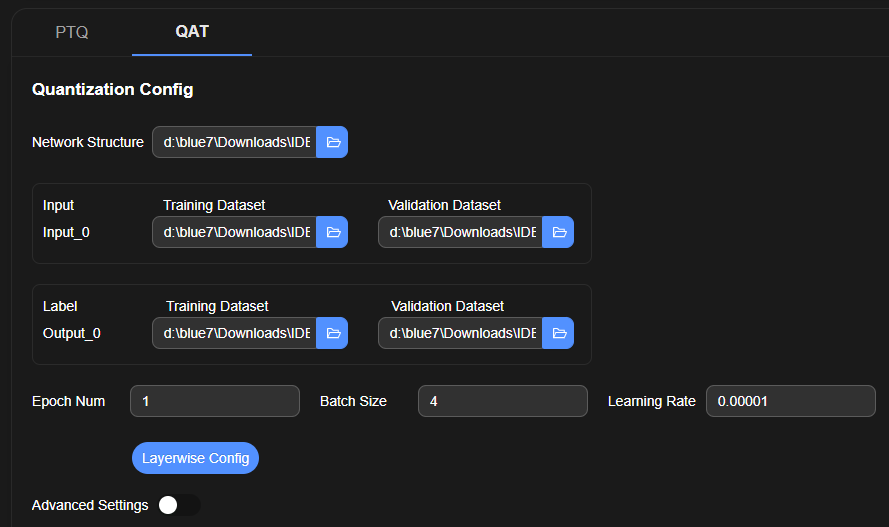
参数解释如表1所示。
表 1 量化感知训练参数配置界面参数
网络结构输入路径。网络结构文件为一个python文件,里面含有网络结构的定义。在定义网络结构时,请满足如下约束:
class NNModel(nn.Module): def __init__(self) -> None: """Initialize network layers and components.""" super(NNModel, self).__init__() |
|
Training Dataset:训练集输入数据目录。训练集输入数据为npy格式。 Validation Dataset:验证集输入数据目录。目录中存放和模型输入匹配的npy文件数据。若模型有多个输入,同一个训练样本的多个输入npy文件文件名必须保持一致。 |
|
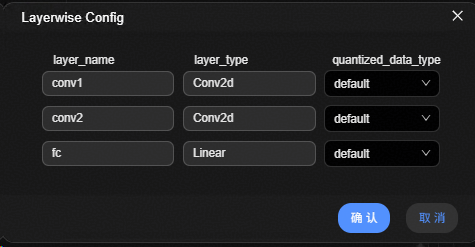
打开逐层量化配置窗口。逐层量化类型配置窗口如图2所示。表格中各列的含义如下所示:
|
|
高级模式使能开关。当开关打开时,高级模式界面展开,如图3所示。 |
|
高级模式量化配置文件输入控件。在该输入控件中输入昇腾量化配置cfg文件。昇腾量化配置文件编写格式参见文档《AMCT模型压缩工具用户指南》。单击 |
|

量化历史显示界面#
压缩历史显示窗口如图1所示。
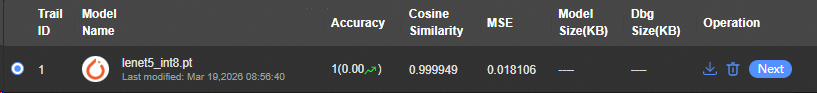
该界面以表格的方式显示历史压缩的结果。表头解释如表1所示。
表 1 压缩历史
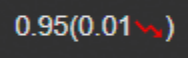
表示分类结果准确率,使用标签真值计算。计算公式如下,其中 {量化模型准确率}({量化模型与原始浮点模型准确率对比}) |
|


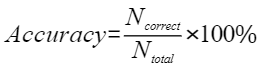



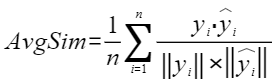


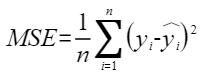


验证集精度分布直方图显示界面#
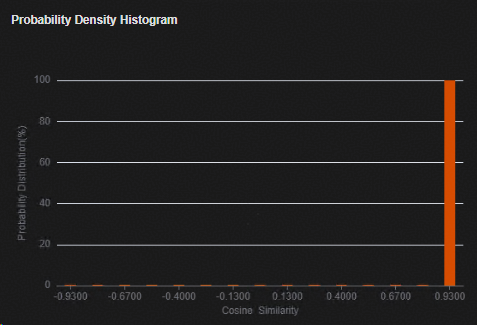
验证集精度分布直方图显示界面如图 验证集精度分布直方图显示界面所示。该窗口显示验证集的余弦相似度的分布图,横轴为余弦相似度,纵轴为验证集样本的百分比。
模型转换#
整体界面#
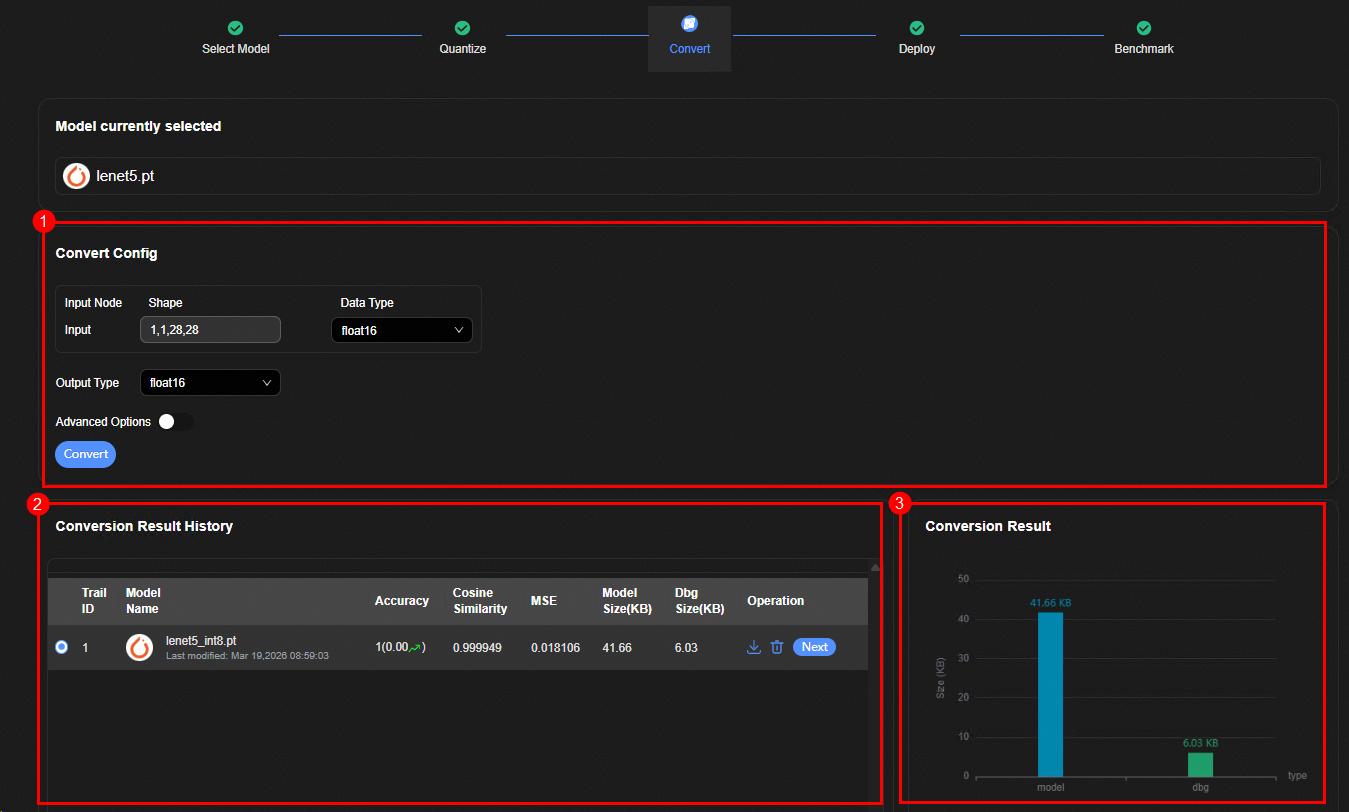
用户在模型转换界面将模型转换成昇腾NPU执行的离线模型。模型转换整体界面如图1所示。主要包含三个部分:
模型转换参数配置界面。
转换历史显示界面,显示所有转换的网络及其相关信息。
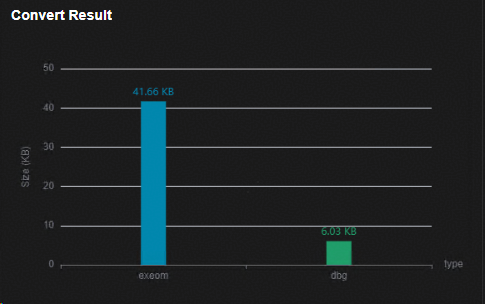
转换结果显示界面,显示转换后模型的大小。
模型转换步骤如下:
在模型转换参数配置界面配置转换参数。
单击“Convert”按钮。
转换历史显示界面查看转换的结果。
转换结果显示界面查看转换后模型的大小。
转换历史显示界面选择待评估的模型,单击“Next”按钮进入部署界面。
模型转换参数配置界面#
模型转换参数配置界面如图1所示。
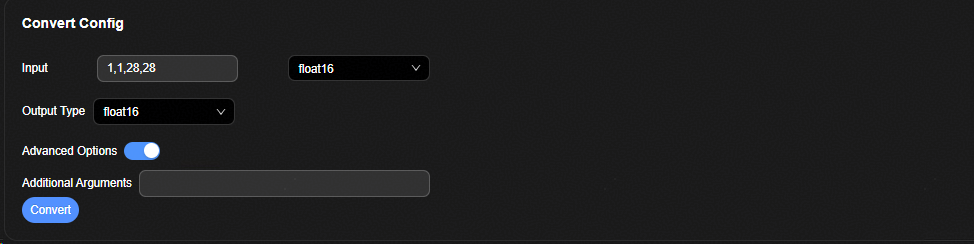
参数解释如表1所示。
表 1 模型转换参数配置界面参数
|
|
扩展参数输入框。模型转换界面不支持配置,但是ATC工具支持的参数均可通过此选项进行扩展。在该输入框中用户根据实际情况输入ATC工具可用的参数。多个参数使用空格分隔。详细参数请参见《ATC离线模型编译工具用户指南》。 |
|
转换历史显示界面#
转换历史显示界面如图1所示。
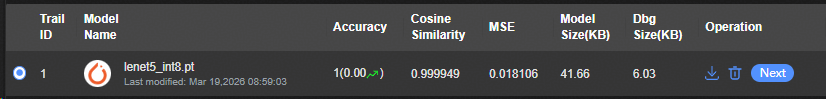
该界面以表格的方式显示历史转换的结果。表头说明如表1所示。
表 1 转换历史


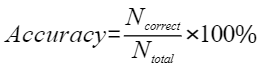


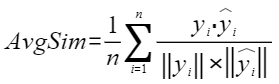


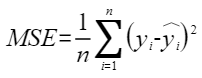


转换结果显示界面#
转换结果显示界面如图1所示。该界面以柱状图的形式显示转换后模型以及图调试信息文件的大小。
部署#
部署界面如图1所示。
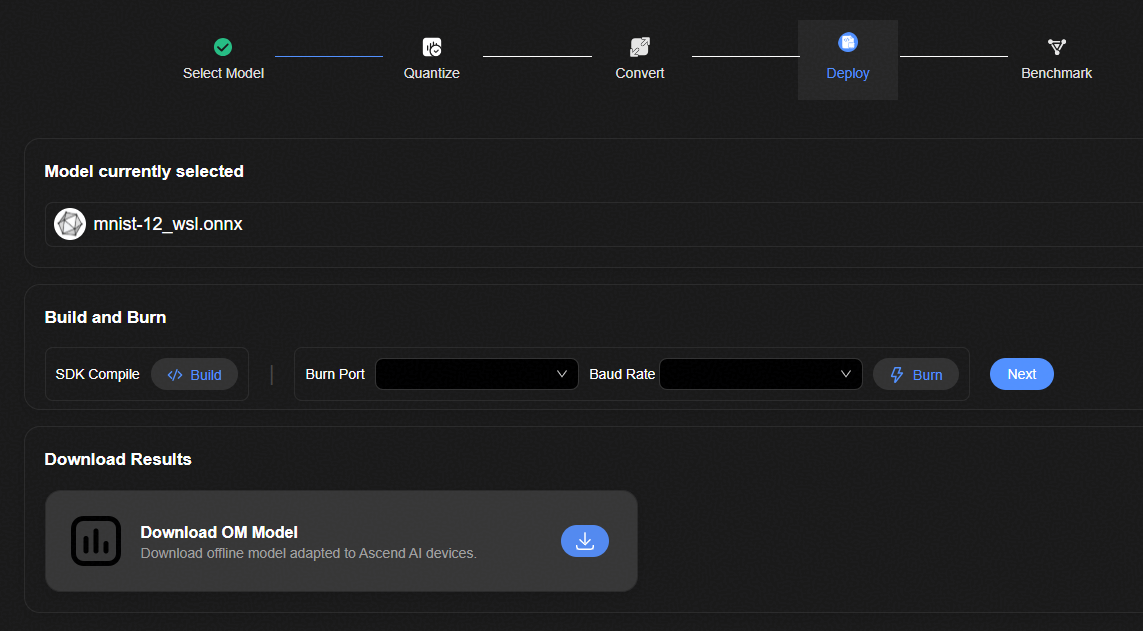
该界面主要包含Model currently selected、Build and Burn、Download Results三个部分。Build and Burn中的主要控件如表1 Build and Burn主要控件说明所示。
表 1 Build and Burn主要控件说明
表 2 Download Results主要控件说明
模型调优#
约束说明#
在进行模型调优前,请务必查看如下约束要求: 只支持计算单输出分类网络量化评估的准确率。
调优前提#
准备精度验证数据,并保存于本地Windows环境。具体数据格式见“数据准备与环境搭建”。
准备并连接Hi3322单板。
界面介绍#
整体界面#
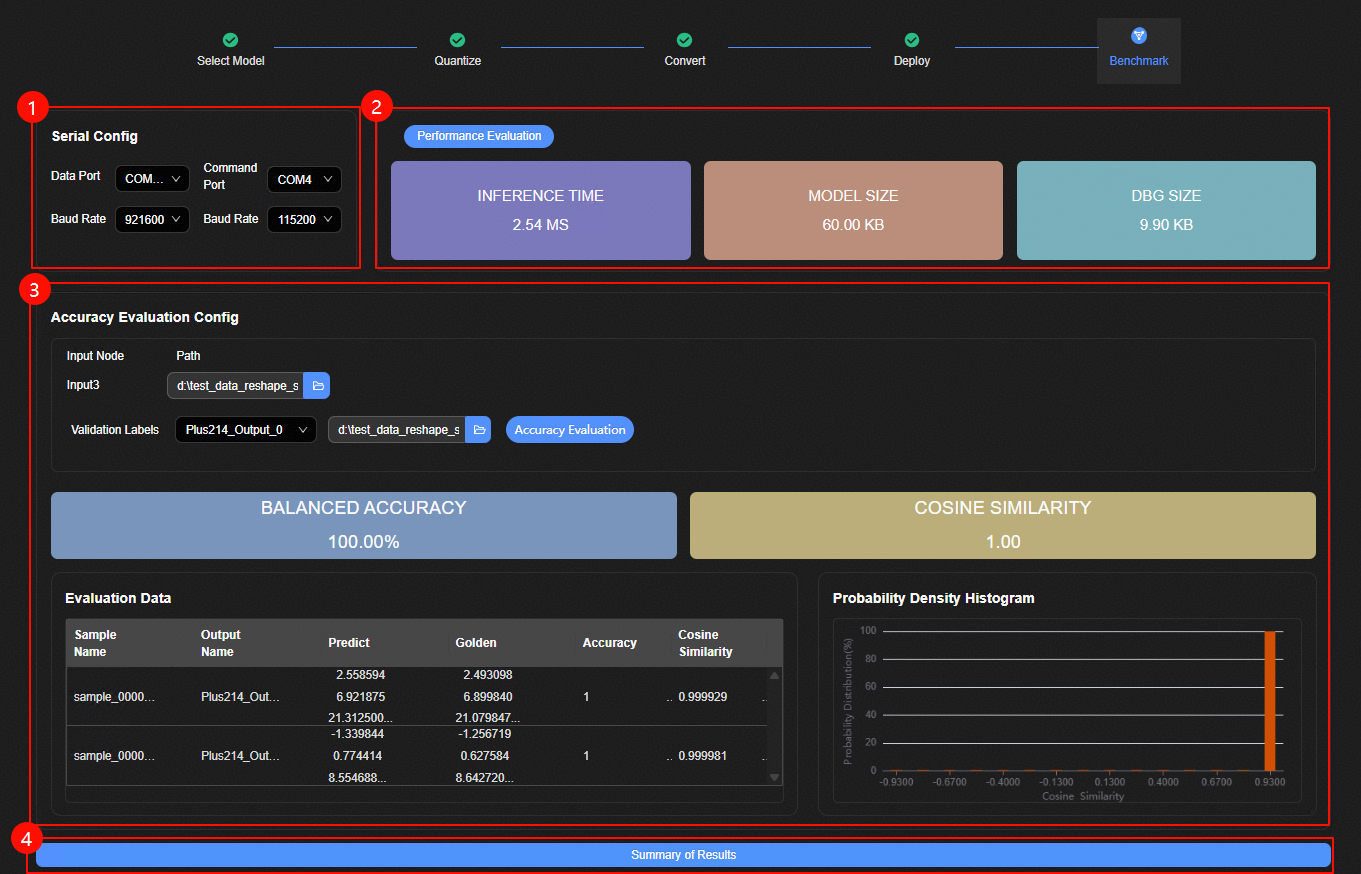
模型调优整体界面如图1所示,主要包含四个部分:
串口配置界面。在该界面配置数据传输、命令串口和波特率。
性能评估界面。
精度评估界面。
评估结果汇总按钮。
执行模型调优的步骤如下:
配置数据传输、命令串口和波特率。
可选。单击“Performance Validation”按钮,执行上板性能评估。查看性能评估结果。
可选。配置精度验证数据集路径,单击“Accuracy Evaluation”按钮,执行上板精度评估。查看精度评估结果。
单击“Summary of Results”按钮,在弹窗中查看历史评估结果。
串口配置界面#
用户在串口配置界面配置数据传输、命令发送串口和波特率。串口配置界面如图1所示。
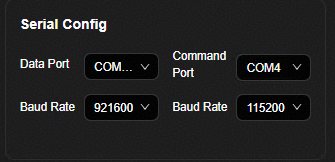
元素说明如表1所示。
表 1 串口配置界面元素说明
性能评估界面#
用户在性能评估界面触发上板性能评估,并查看性能评估结果。性能评估界面的如图1所示。
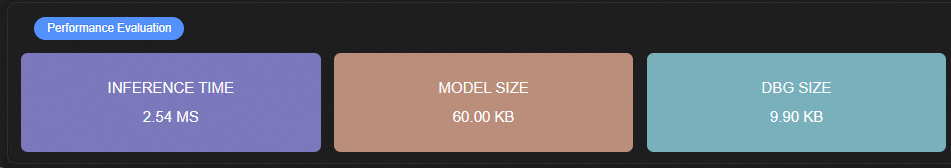
性能评估界面元素说明如表1所示。
表 1 性能评估界面元素说明
精度评估界面#
用户在精度评估界面配置精度评估验证数据、触发上板精度验证以及查看精度验证结果。精度评估界面如图1所示。
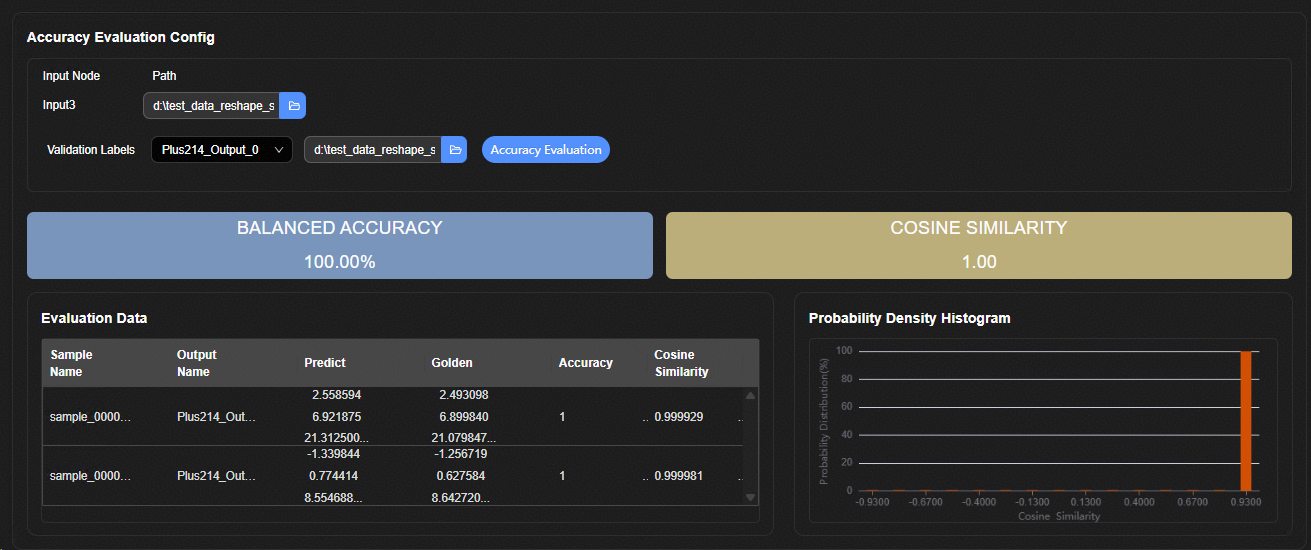
精度评估界面元素说明如表1所示。
表 1 精度评估界面元素说明
各验证样本验证结果。表格中各项说明如表2所示。 |
|


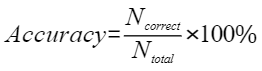


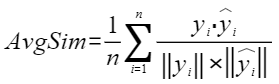
表 2 验证样本结果说明


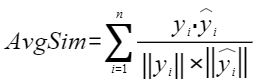
评估结果汇总界面#
单击“Summary of Results”按钮之后弹出评估结果汇总界面,该界面汇总每次评估的结果。如图1所示。
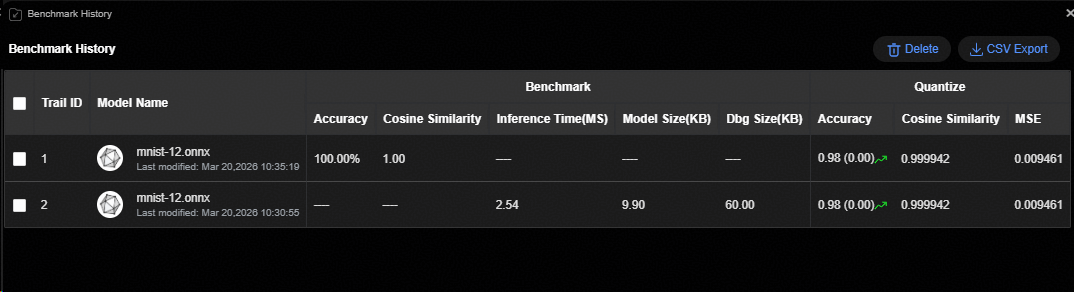
评估结果汇总界面元素说明如表1所示。
表 1 评估结果界面元素说明


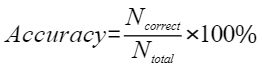


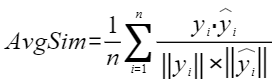


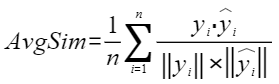


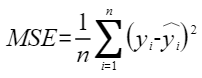
应用开发#
在HiSpark Studio AI中完成模型量化、转换之后,将模型导出并使用HiSpark.AI API完成应用开发。具体步骤如下:
ModelZoo模型下载#
ModelZoo模型下载帮助用户从官方模型仓一键下载模型,可同时下载配套的数据集与样例文件。下载完成后自动导入HiSpark Studio AI并跳转到模型量化页面;后续也可以通过面板的“Next”按钮随时回到该模型的最新记录。
约束说明#
使用ModelZoo模型下载前,有以下约束:
使用ModelZoo前需先创建对应芯片的工程,目前支持WS63工程与Hi3322工程,面板按当前工程的芯片展示对应的模型目录。
Hi3322工程下载完成后的自动导入需要WSL环境,请确保已安装WSL并完成AI工具链配置。
下载模型需要网络可以访问ModelZoo模型仓。数据集文件较大,如果源站访问受限(如提示HTTP 403),可以在设置中配置数据集镜像(hisparkAI.modelzooDatasetMirrors)后重试,也可以配置代理后重试。
界面介绍#
WS63工程与Hi3322工程的ModelZoo面板布局一致,分别如图1、图2所示:
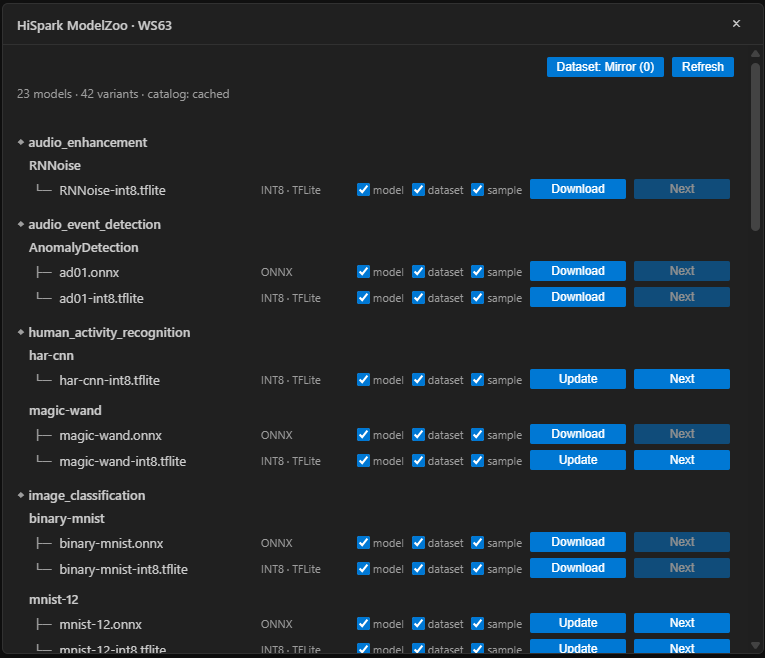
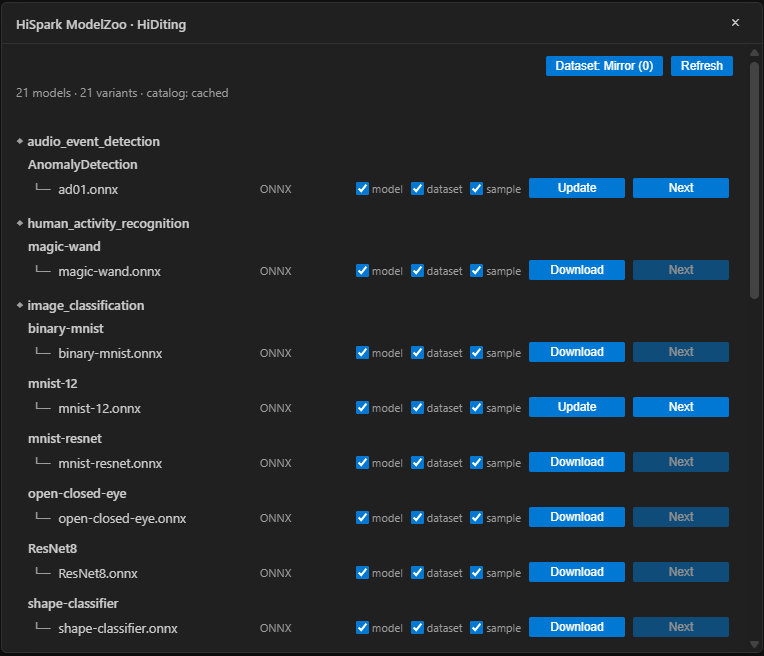
面板主要包含以下部分:
模型列表页面,按场景展示当前芯片支持的模型以及每个模型的输入规格说明。
模型变体行,每个变体行包含Model、Dataset、Sample三个勾选项(默认全部勾选,取消勾选表示跳过下载对应部分)、下载状态与进度,以及“Download”/“Update”按钮和“Next”按钮。
下载进度与日志区域,实时显示下载进度与结果。
操作步骤#
WS63工程#
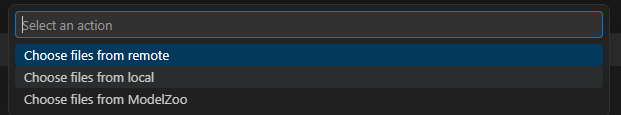
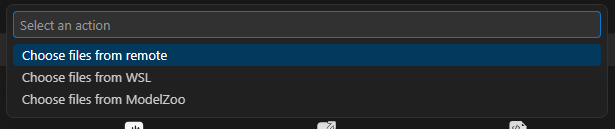
在模型选择页面单击“Import Model”按钮,在弹出的选项列表中选择“Choose files from ModelZoo”,打开ModelZoo面板,面板展示WS63对应的模型目录;也可以通过命令面板(Ctrl+Shift+P)执行“Choose files from ModelZoo”命令打开。
单击目标模型变体行的“Download”按钮,在弹出的目录选择框中选择下载保存目录(每个面板仅首次询问,之后沿用),等待下载完成。
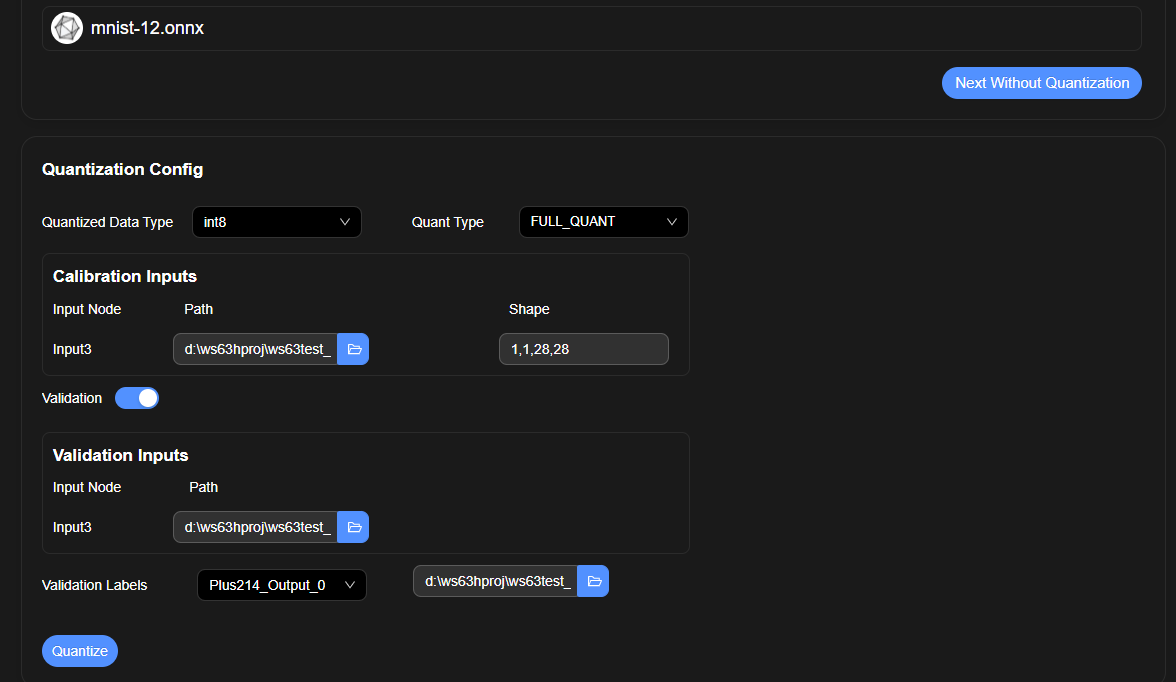
下载完成后插件自动将模型导入AI流程并跳转到量化页面;如果下载内容包含数据集,量化页面的训练集、验证集与标签文件参数会自动填充,无需手动输入。
Hi3322工程#
在模型选择页面单击“Import Model”按钮,在弹出的选项列表中选择“Choose files from ModelZoo”,打开ModelZoo面板,面板展示Hi3322对应的模型目录;也可以通过命令面板(Ctrl+Shift+P)执行“Choose files from ModelZoo”命令打开。
单击目标模型变体行的“Download”按钮,在弹出的目录选择框中选择下载保存目录(每个面板仅首次询问,之后沿用),等待下载完成。
下载完成后插件自动将模型导入AI流程并跳转到量化页面;如果下载内容包含数据集,量化页面的训练集、验证集与标签文件参数会自动填充,无需手动输入。
功能细节#
勾选规则:每个模型变体行提供Model、Dataset、Sample三个勾选项,默认全部勾选,取消勾选的部件在下载时跳过;下载进行中勾选项会锁定,结束后恢复。如果三个部件全部取消勾选,单击“Download”会提示“Nothing to download: keep at least one of Model / Dataset / Sample checked.”,且不会开始下载。
下载目录:首次下载时询问一次保存目录,同一面板内的后续下载沿用该目录,不再重复询问。
已下载判定:某个模型变体成功下载过(至少勾选一个部件)后,工程中会生成一条带ModelZoo来源标志的导入记录,该变体的“Download”按钮从此显示为“Update”,“Next”按钮点亮。
Update与保存目录:单击“Update”后沿用上次保存目录时,目录中已存在的部件直接复用、不重复下载;如果全部内容均已存在,会提示“Model and dataset already exist”并直接进入导入流程。如果选择了与上次不同的保存目录,新目录中没有已下载内容,勾选的部件(包括数据集)会重新下载。重新下载也可用于获取上游更新后的模型版本。
数据集检测:下载数据集前会检测所选目录中是否已存在该数据集,存在则跳过下载,不存在则自动下载。如果仅数据集阶段下载失败,模型与样例保持可用,并提示数据集被跳过的原因。
下载可取消:下载过程会在通知区域显示进度,可随时单击取消终止本次下载。
按需拉取:首次打开面板不会下载整个模型仓,仅在下载某个模型时拉取对应内容,避免长时间等待。
导入与记录:每次“Download”/“Update”完成后都会重新导入并创建一条新的导入记录。
Next跳转:“Download”/“Update”完成后会自动跳转到量化页面;该跳转成功后,再次打开ModelZoo页面时,可以看到对应模型变体行的“Next”按钮已可点击。单击“Next”,直接跳转到该模型最新一条记录对应的量化页面,无需重新下载或导入。同一模型存在多条记录时,始终跳转时间戳最新的一条;Next与下载完成后的自动导入互斥,不会互相打断。
参数填充规则:如果跳转到的记录还没有量化结果,且下载内容包含数据集,量化页的训练集、验证集与标签文件参数按下载内容自动填充;如果该记录已有量化结果,则恢复该记录当时的真实参数。
来源标记:从ModelZoo导入的模型在模型选择页面的历史记录中带有“(from ModelZoo)”标记。
后续流程#
下载导入后的量化、转换、部署、模型调优等操作与对应芯片的既有流程一致:WS63工程请参考“模型量化”(WS63操作指南);Hi3322工程请参考“模型量化”(Hi3322操作指南)。
常见问题#
服务器断连#
对于Linux通路,若远程服务器在使用过程中断连,插件右下角会弹窗提示 "Lost connection to remote server" 。当远程服务器重新启动,连接恢复后,需手动在选择模型界面通过导入模型或选择已有模型的方式,重新连接一次服务器。