
 HiSpark AI

前言
本文档主要描述HiSpark Studio AI for VS Code插件的安装及使用。该工具主要用于模型压缩、模型转换、应用开发,端侧部署,性能调优等。
本文档主要适用于基于海思芯片进行嵌入式开发的相关人员:
软件开发工程师
技术支持工程师
硬件开发工程师
嵌入式爱好者
在本文中可能出现下列标志,它们所代表的含义如下。
文档版本 |
发布日期 |
修改说明 |
|---|---|---|
05 |
2026-09-02 |
修改“开发板准备”、“3322样例运行”章节。 |
04 |
2026-07-03 |
更新“Linux通路环境准备、基础版环境准备、GPU加速版环境准备”。 |
03 |
2026-04-28 |
新增 HiSpark社区资源下载关联。 |
02 |
2026-03-24 |
新增“3.2.1-Windows环境准备”(仅Windows端用户关注)、WSL环境准备(仅Windows端用户关注)”章节。 |
01 |
2026-01-26 |
第一次正式版本发布。 |
简介
HiSpark Studio AI是面向开发者提供的超轻量级AI应用开发平台,具备高集成、高专业、高易用等特征,聚焦嵌入式AI应用场景,提供模型压缩、模型转换、应用开发、端侧部署、性能调优的全流程开发平台。
开发板准备
目前支持WS63、3322两款芯片,需要提前准备单板资源。
开发环境准备
HiSpark Studio AI准备
准备资源
从HiSilicon社区的资源下载部分下载HiSpark.AI组件,下载按钮如下图所示。
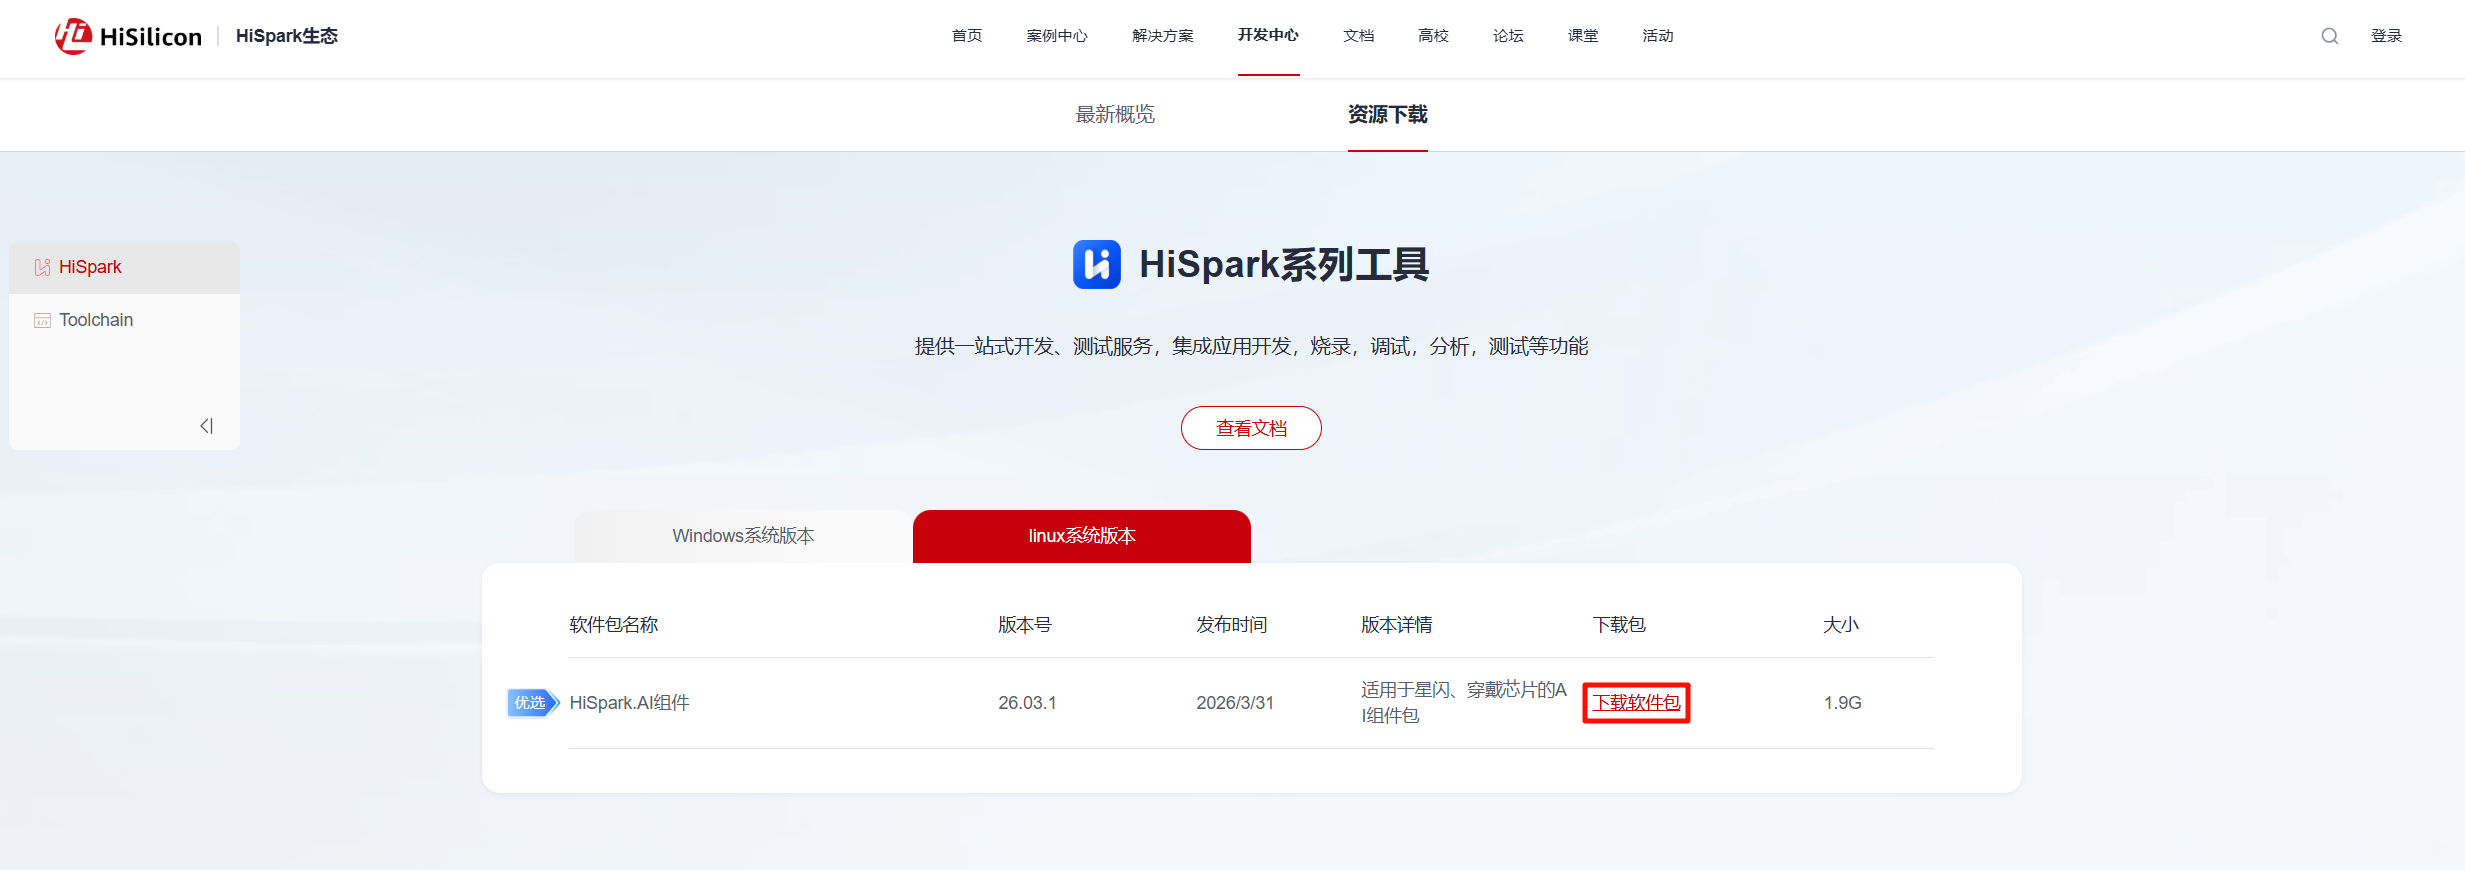
下载压缩包,解压后内部customer文件夹下包含 MSLite (WS63 AI工具链),CANN(3322 AI工具链),Tools(Dockerfile),samples(WS63、3322共用的AI相关Samples),adaptor(WS63、3322共用的AI相关适配层)。
插件安装
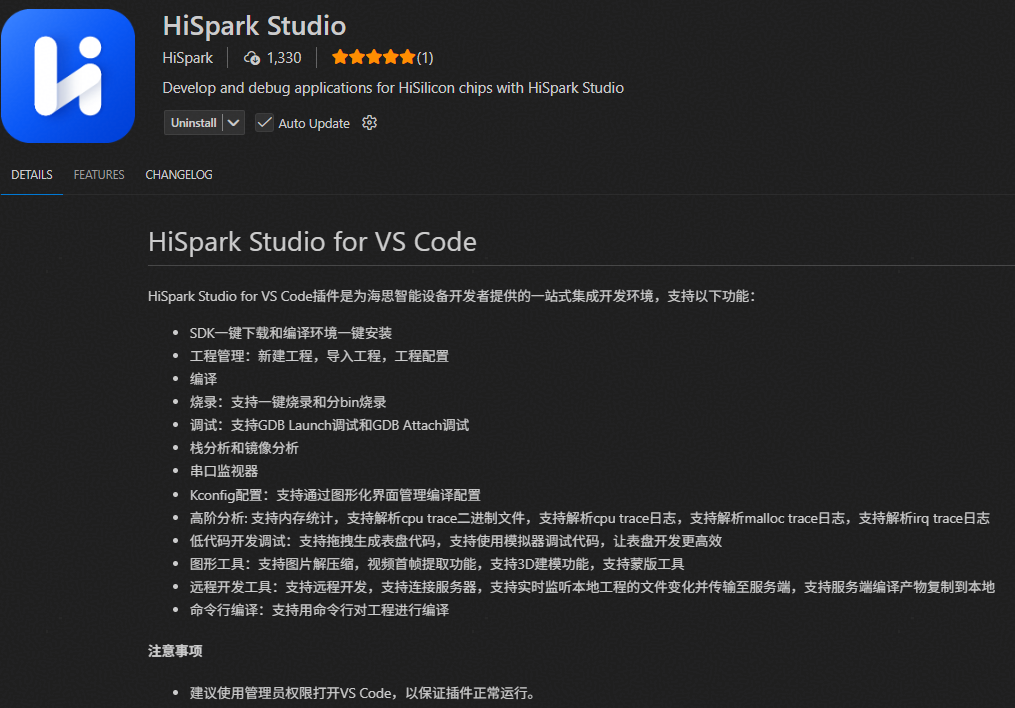
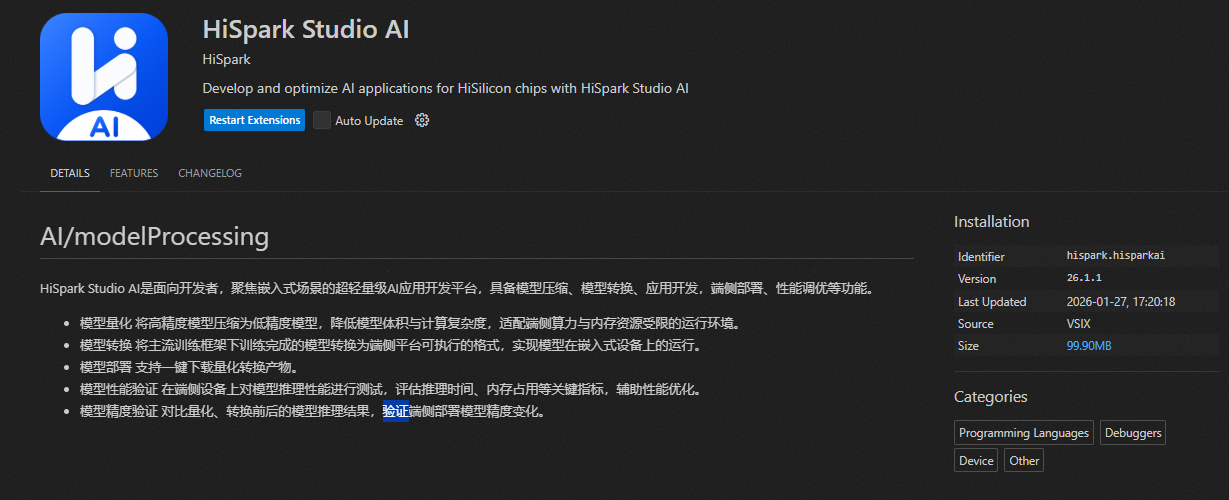
从VS Code插件市场中安装插件:
环境配置
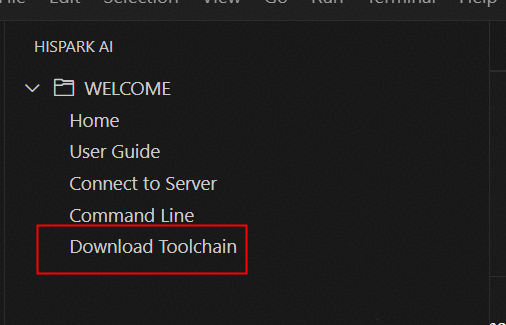
进入HiSpark Studio AI页面,单击“Download Toolchain”按钮。
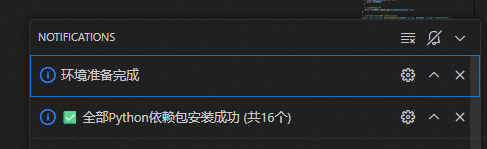
出现如图2所示界面,即表示一键下载工具链已完成。
WS63环境准备
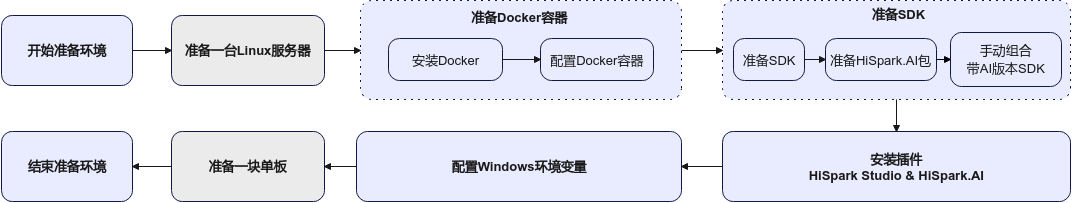
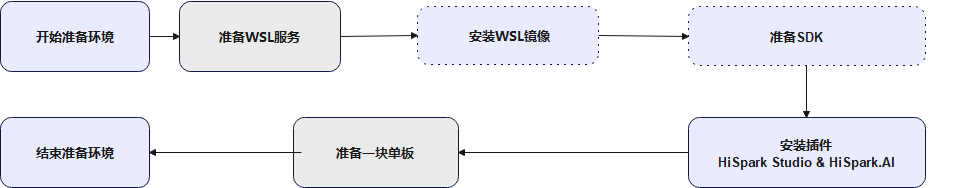
HiSpark Studio AI后端支持用户在Windows(推荐)和Linux环境中使用,环境准备步骤大致如图1、图2所示。若需要使用命令行工具进行模型的量化与转换,请参考《HiSpark.AI 转换工具使用指南》 以及 《HiSpark.AI API 开发指南》,进行环境准备。
整个CPU侧环境准备步骤大致如下所示。

Linux服务器端AI环境准备(仅Linux端用户关注)
使用Dockerfile准备Linux服务器端AI环境。环境安装前,需要从发布包获取Dockerfile文件、MSLite安装包,并放置于同级目录下。
Dockerfile包括Dockerfile_mslite。Dockerfile_mslite为基础版环境准备配置文件。
环境安装前,请先检查目录下是否包含如下文件:
.
├── Dockerfile_mslite
└── HiSpark.AI_xx.xx.xx-mindspore-enterprise-lite-xx.xx.xx-linux-x64.tar.gz
须知:
请勿将多个不同版本的MSLite包放置于该目录下。
请保持Linux服务器网络畅通。
Linux通路环境准备
基础版环境准备前,请先保证Linux服务器安装Docker。
基础版环境准备步骤如下:
准备 Docker 镜像:
下载并导入 Docker 镜像(推荐)
已构建完成的 Docker 镜像下载链接如下:
https://hispark-obs.obs.cn-east-3.myhuaweicloud.com/mslite-cpu.tar
下载镜像文件后,执行如下命令导入 Docker 镜像:
docker load -i mslite-cpu.tar导入完成后,可执行如下命令查看镜像信息:
docker images如果镜像列表中包含已导入的镜像,则表示 Docker 镜像导入成功。请根据 docker images 查询结果,确认后续运行容器时使用的镜像名称和镜像标签。
说明: 如需自行构建 Docker 镜像,或需了解运行容器、进入容器、配置密码、测试 SSH 等后续步骤,请参见《linux环境docker镜像制作参考》。
准备SDK
在HiSpark Studio AI插件左侧边栏的“Environment Configuration”区域,单击“Download SDK from HiSpark”按钮,在顶部弹出的选择框中选择“WS63 SDK”,完成SDK下载。
图 1 插件内下载WS63 SDK

下载完成后,SDK目录下包含“fbb_ws63”(SDK源码仓,含docs、src、tools、vendor等目录)以及“hispark_ai”(HiSpark.AI组件仓)等文件夹。AI相关适配代码(如“middleware/utils/ai_mcu”、“middleware/utils/at/at_ai_cmd”)已预集成在SDK源码中,无需再手动解压组件包或修改编译配置脚本。
后续在“新建工程与选择模型”章节创建工程时,SDK路径请选择“fbb_ws63”下的“src”目录(如“D:\ws63SDK0922\fbb_ws63\src”)。
3322环境准备
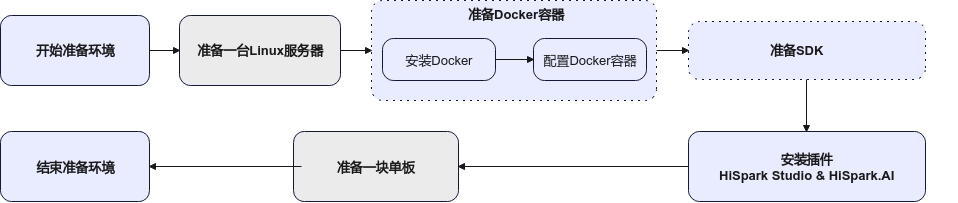
HiSpark Studio AI后端支持用户在Windows(推荐)和Linux环境中使用,环境准备步骤大致如图1、图2所示。若需要使用命令行工具进行模型的量化或转换(量化仅适用于3322),请参考《Nano AI应用开发指南》,进行环境准备。
WSL环境准备(仅Windows端用户关注)
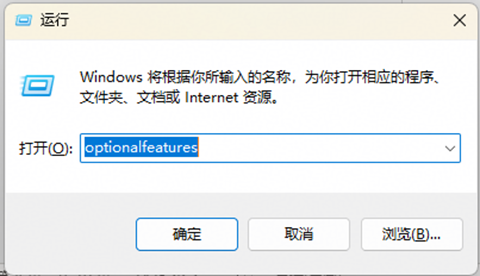
Win + R,输入“optionalfeatures”。
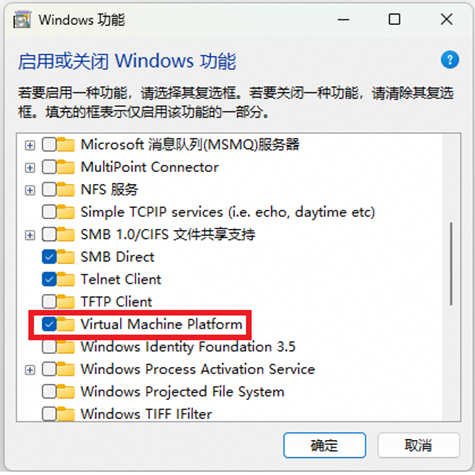
若Virtual Machine Platform/虚拟机平台选项未开启,开启并重启电脑。
通过离线安装包https://github.com/microsoft/WSL/releases/download/2.6.3/wsl.2.6.3.0.x64.msi安装WSL,并下载指定镜像。
通过以下命令安装WSL镜像:
wsl --install --from-file {WSL镜像路径} --location {WSL安装路径} --name {WSL_DISTRIB名称}
其中:
WSL镜像路径:为镜像所在路径。
WSL安装路径:用户指定的wsl安装的目标目录,
WSL_DISTRIB名称:用户指定的WSL Distribution名称。 HiSpark Studio AI通过该名称连接WSL环境。在HiSpark Studio AI中,可以使用默认名称“ubuntu-22.04-cann-base”,或者指定自定义名称连接WSL环境。
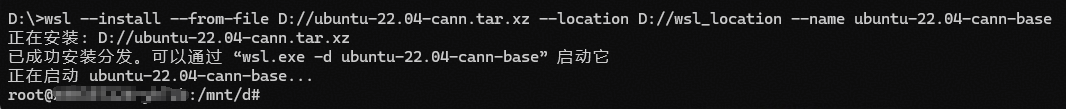
如,用户的镜像存放于D盘:D://ubuntu-22.04-cann.tar.xz;安装的目标目录为“D://wsl_location”,使用默认名称“ubuntu-22.04-cann-base”,则使用如下命令进行WSL镜像安装:
wsl --install --from-file D://ubuntu-22.04-cann.tar.xz --location D://wsl_location --name ubuntu-22.04-cann-base
安装成功后会自动进入WSL环境,如图1所示。
Linux服务器端环境准备(仅Linux端用户关注)
使用Dockerfile准备Linux服务器端AI环境。环境安装前需要从发布包获取Dockerfile文件、ATC安装包、AMCT安装包,并将其放置在同级目录下。
Dockerfile包括Dockerfile_cann_cpu和Dockerfile_cann_gpu。其中Dockerfile_cann_cpu为基础版环境准备配置文件;Dockerfile_cann_gpu为GPU加速版环境准备配置文件。GPU可以加速量化感知训练的效率。
环境安装前,请先检查目录下是否包含如下文件:
.
├── CANN-amct-{版本号}-linux.x86_64.tar.gz
├── CANN-compiler-{版本号}-linux.x86_64.run
├── CANN-opp-{版本号}-linux.x86_64.run
├── CANN-runtime-{版本号}-linux.x86_64.run
├── CANN-toolkit-{版本号}-linux.x86_64.run
└── Dockerfile_cann_cpu或Dockerfile_cann_gpu
请勿将多个不同版本的ATC和AMCT安装包放置于该目录下。
请保持Linux服务器网络畅通。
基础版环境准备
基础版环境准备前,请先保证Linux服务器安装Docker。
基础版环境准备步骤如下:
准备 Docker 镜像:
下载并导入 Docker 镜像(推荐)
已构建完成的 Docker 镜像下载链接如下:
https://hispark-obs.obs.cn-east-3.myhuaweicloud.com/cann_docker/cann-cpu.tar
下载镜像文件后,执行如下命令导入 Docker 镜像:
docker load -i cann-cpu.tar导入完成后,可执行如下命令查看镜像信息:
docker images如果镜像列表中包含已导入的镜像,则表示 Docker 镜像导入成功。请根据 docker images 查询结果,确认后续运行容器时使用的镜像名称和镜像标签。
说明: 如需自行构建 Docker 镜像,或需了解运行容器、进入容器、配置密码、测试 SSH 等后续步骤,请参见《linux环境docker镜像制作参考》。
GPU加速版环境准备
GPU加速版环境准备前,请先保证Linux服务器:
安装Docker。
安装GPU驱动;并保证版本号≥525。
安装和配置NVIDIA Container Toolkit。
GPU加速版环境准备步骤如下:
准备 Docker 镜像:
下载并导入 Docker 镜像(推荐)
已构建完成的 Docker 镜像下载链接如下:
https://hispark-obs.obs.cn-east-3.myhuaweicloud.com/cann_docker/cann-gpu.tar
下载镜像文件后,执行如下命令导入 Docker 镜像:
docker load -i cann-gpu.tar导入完成后,可执行如下命令查看镜像信息:
docker images如果镜像列表中包含已导入的镜像,则表示 Docker 镜像导入成功。请根据 docker images 查询结果,确认后续运行容器时使用的镜像名称和镜像标签。
说明: 如需自行构建 Docker 镜像,或需了解运行容器、进入容器、配置密码、测试 GPU/SSH 等后续步骤,请参见《linux环境docker镜像制作参考》。
3322 Windows侧Bash环境准备
该小节仅针对于需要依赖bash环境才可以编译的3322工程。
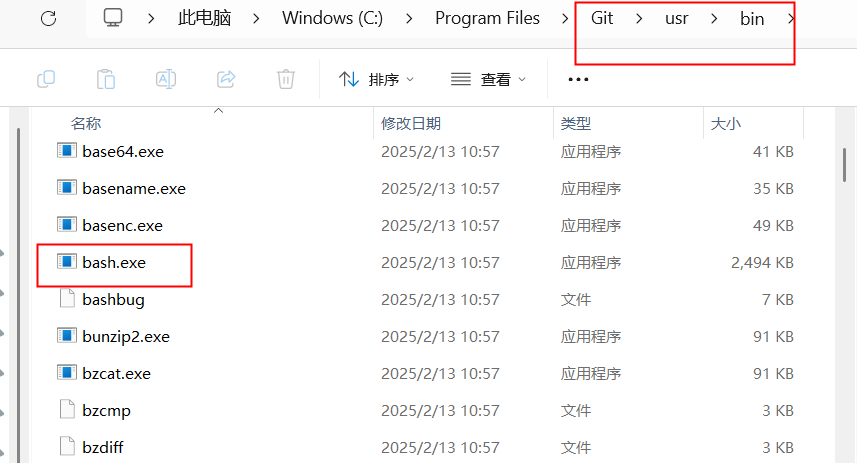
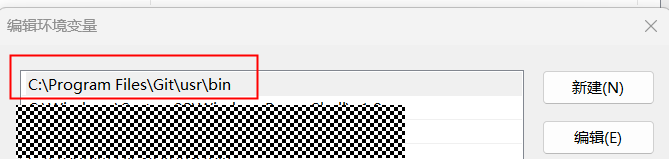
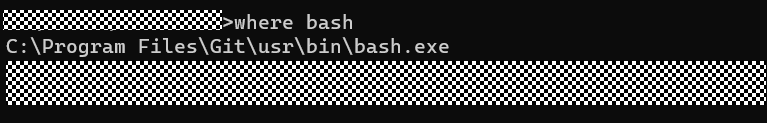
如果需要编译3322的工程,用户需手动下载Git并将bash路径添加到环境变量中。
下载链接:https://github.com/git-for-windows/git/releases/download/v2.48.1.windows.1/Git-2.48.1-64-bit.exe
如果Windows系统System32下默认有“bash.exe”,需要删除其系统下的“bash.exe”,使用安装的git下内置的“bash.exe”。
完成后,重启VS Code使新环境变量生效,即可正常编译工程。
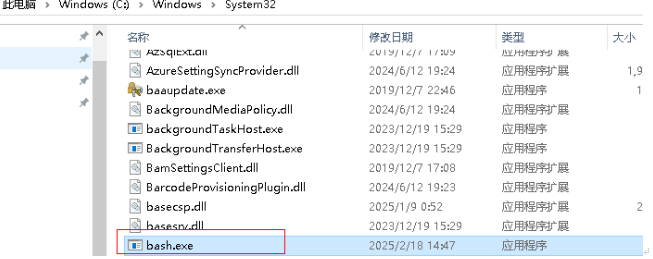
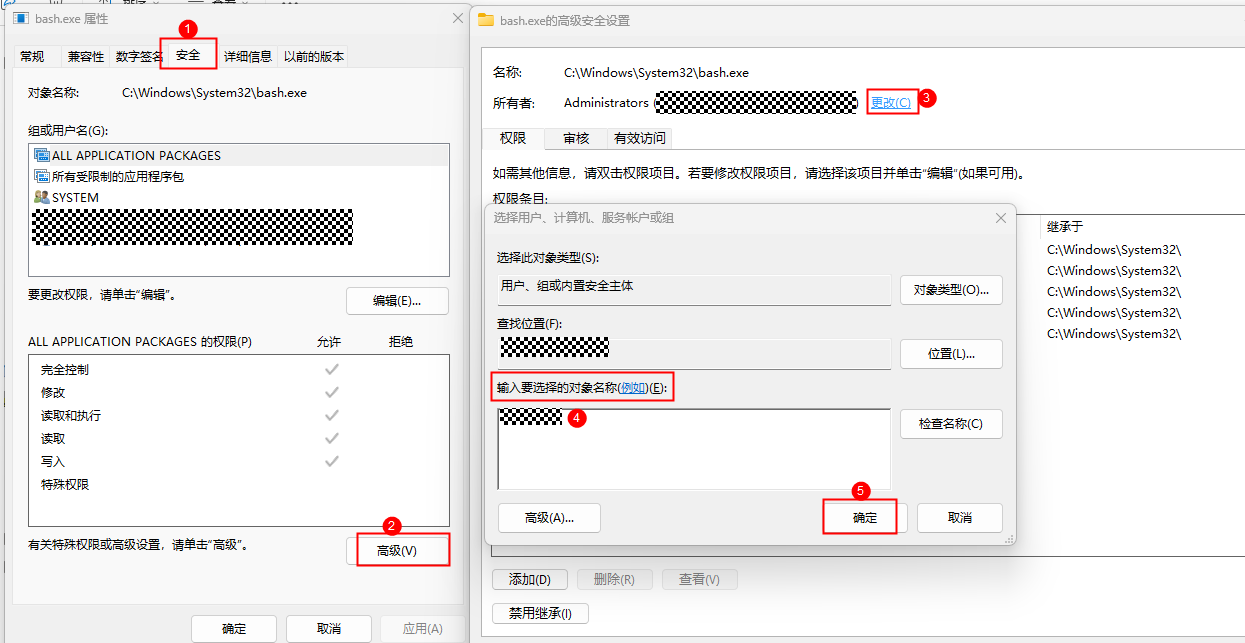
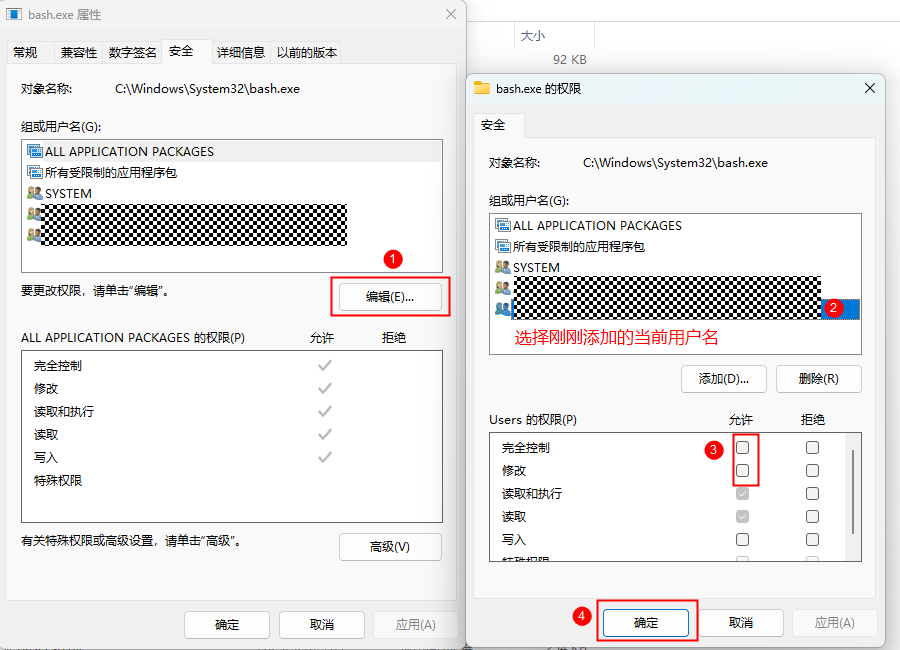
说明: 若删除Windows系统库下的bash时提示没权限,可以在需要删除的“bash.exe”上右键单击,选择“属性”,在弹出的窗口中依次单击“安全”标签页→“高级”→单击“所有者”标签页下的“更改”按钮。选择一个新的所有者(例如当前用户),单击“应用”和“确定”。返回“安全”标签页,单击“编辑”。为当前添加的用户或组分配适当的权限(如完全控制、读取等)。点“应用”和“确定”后即可删掉选择的“bash.exe”文件。
准备SDK
取3322对应SDK发布包,解压SDK包到本地目录,SDK解压目标路径请勿带空格。
样例运行
WS63样例运行
模型与数据获取
模型获取,若使用Linux服务器环境,将其上传到容器内。
进行模型量化,请点击Link,下载ONNX模型。
点击Link,下载数据和预处理脚本“preproc_mnist_data.py”。请参考文档,在容器内执行该脚本,进行数据获取。请确保文件夹内包含如下数据和文件。
.
|-- test_data
|   `-- npy
|       `-- sample_00000_7.npy
|       `-- ......
|       `-- sample_09999_6.npy
|   `-- bin
|       `-- sample_00000_7.bin
|       `-- ......
|       `-- sample_09999_6.bin
|   `-- label.csv
`-- train_data
|   `-- bin
|       `-- sample_00000_5.bin
|       `-- ......
|       `-- sample_59999_8.bin
|   `-- label.csv
说明:
test_data和train_data目录作为数据下载和预处理脚本的输入参数,会根据用户的输入而变化。
新建工程与选择模型
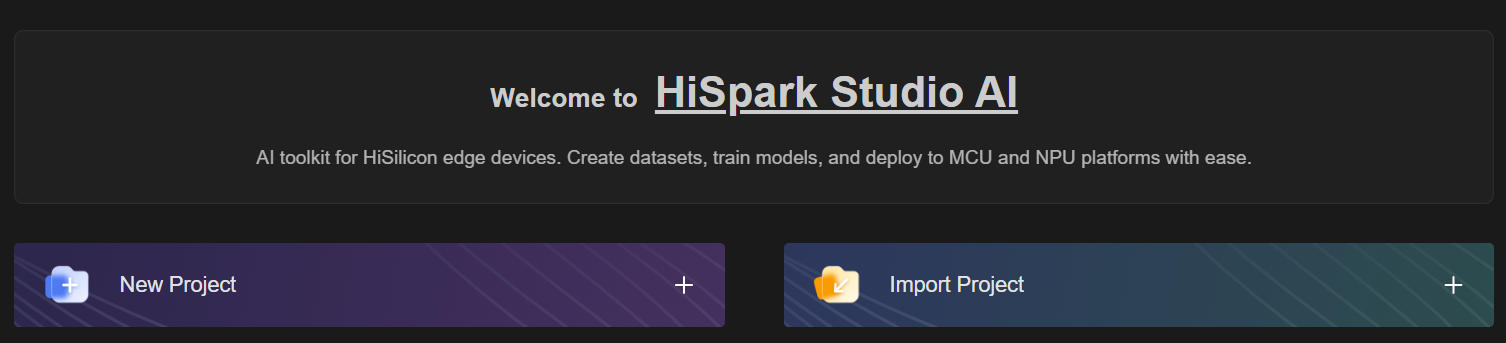
进入HiSpark Studio AI插件点击home按钮,单击“New Project”按钮。
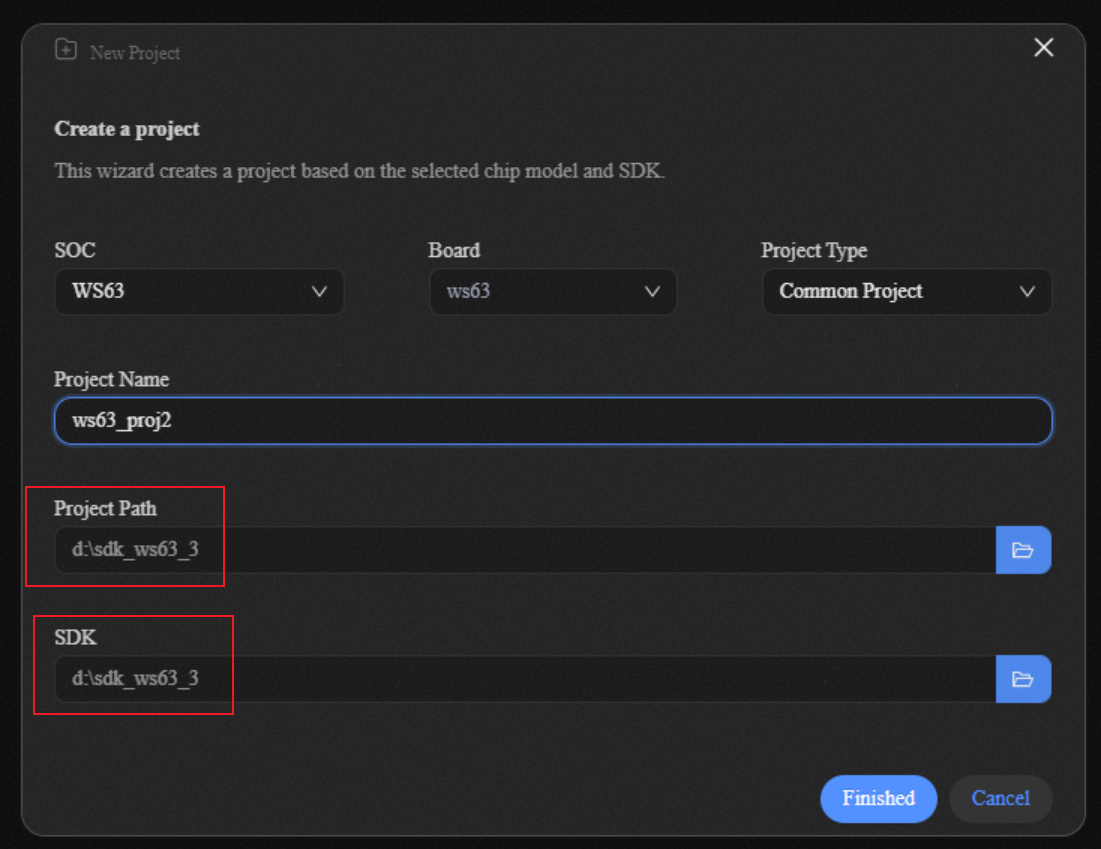
选择芯片为WS63,选择已准备好的SDK目录,工程项目目录选择SDK相同路径即可。
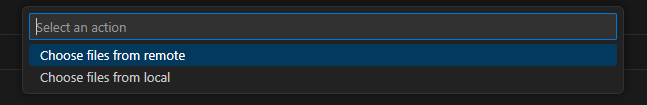
进入模型选择页面,单击“Import Model”,进入模型选择窗口如图4。
选择模型文件:
Windows端用户选择“Choose files from local”,从本地选择文件。
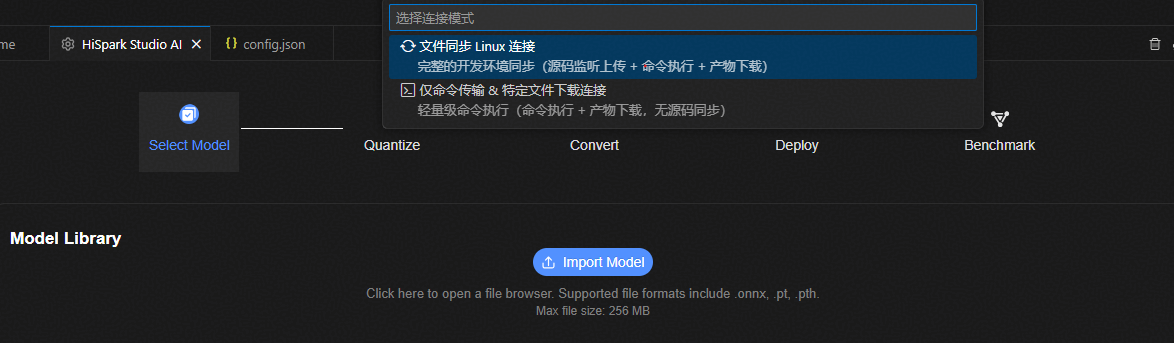
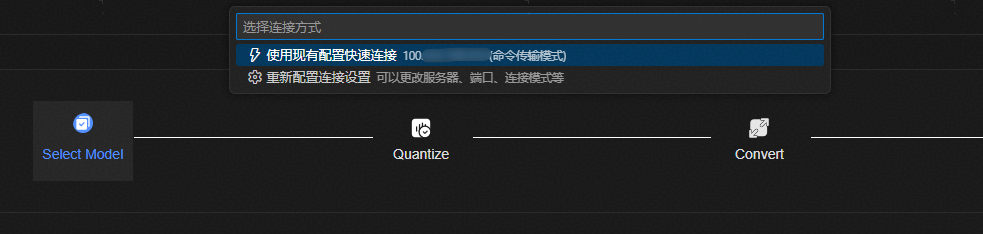
Linux端用户点击“Choose files from remote”;选择“仅命令传输 & 特定文件下载连接”,输入Docker的IP、端口号、用户名、密码。成功连接一次以后,下次登录可直接选择“使用现有配置快速连接”,只需输入密码即可,界面如图5所示。
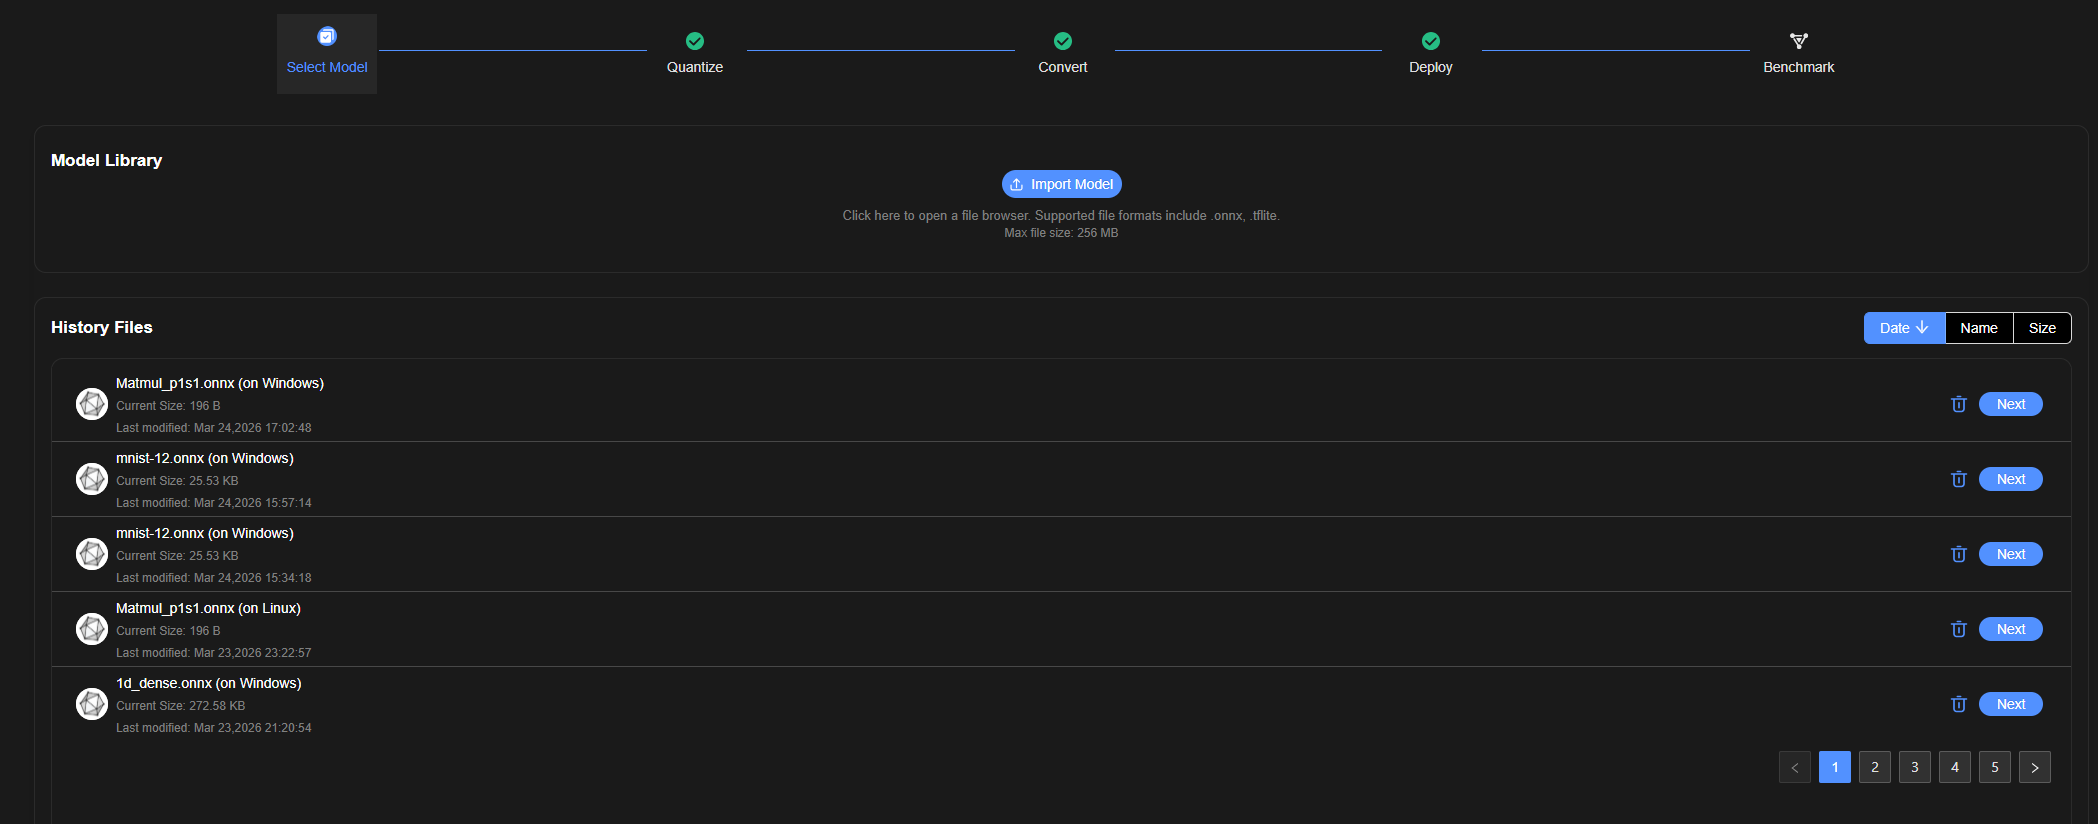
模型量化
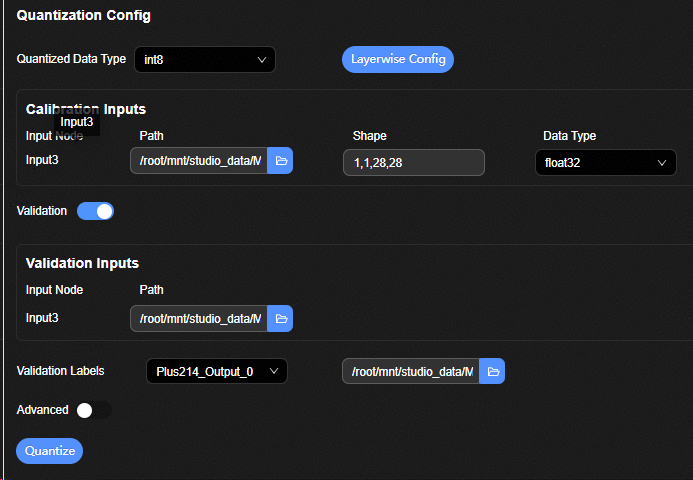
进入模型量化页面,,在Calibration Inputs选择“Input3”(模型输入名称)对应的Path选择框架;如需要进行数据验证,将Validation开关打开,选择量化数据所对应的npy文件目录路径,在Validation Inputs输入框选择“Input3”对应的Path选择框架,选择验证数据所对应的npy目录,在Validation Labels文本框选择为含标签的label文件。
Label文件数据结构如表1所示。
表 1 label.csv文件内容
说明:
label.csv中为样本分类的真值标签。文件中的表格格式如表1。其中:sample列:表示样本的名称。
label列:表示样本对应的真值标签。
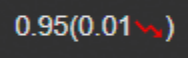
准确率:表示的格式,{量化模型准确率}({量化模型与原始浮点模型准确率对比}),例如:
 :表示量化后模型的准确率为0.99,与原始浮点网络模型相比上升0.01。
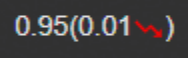 :表示量化后模型的准确率为0.95,与原始浮点网络模型相比下降0.01。
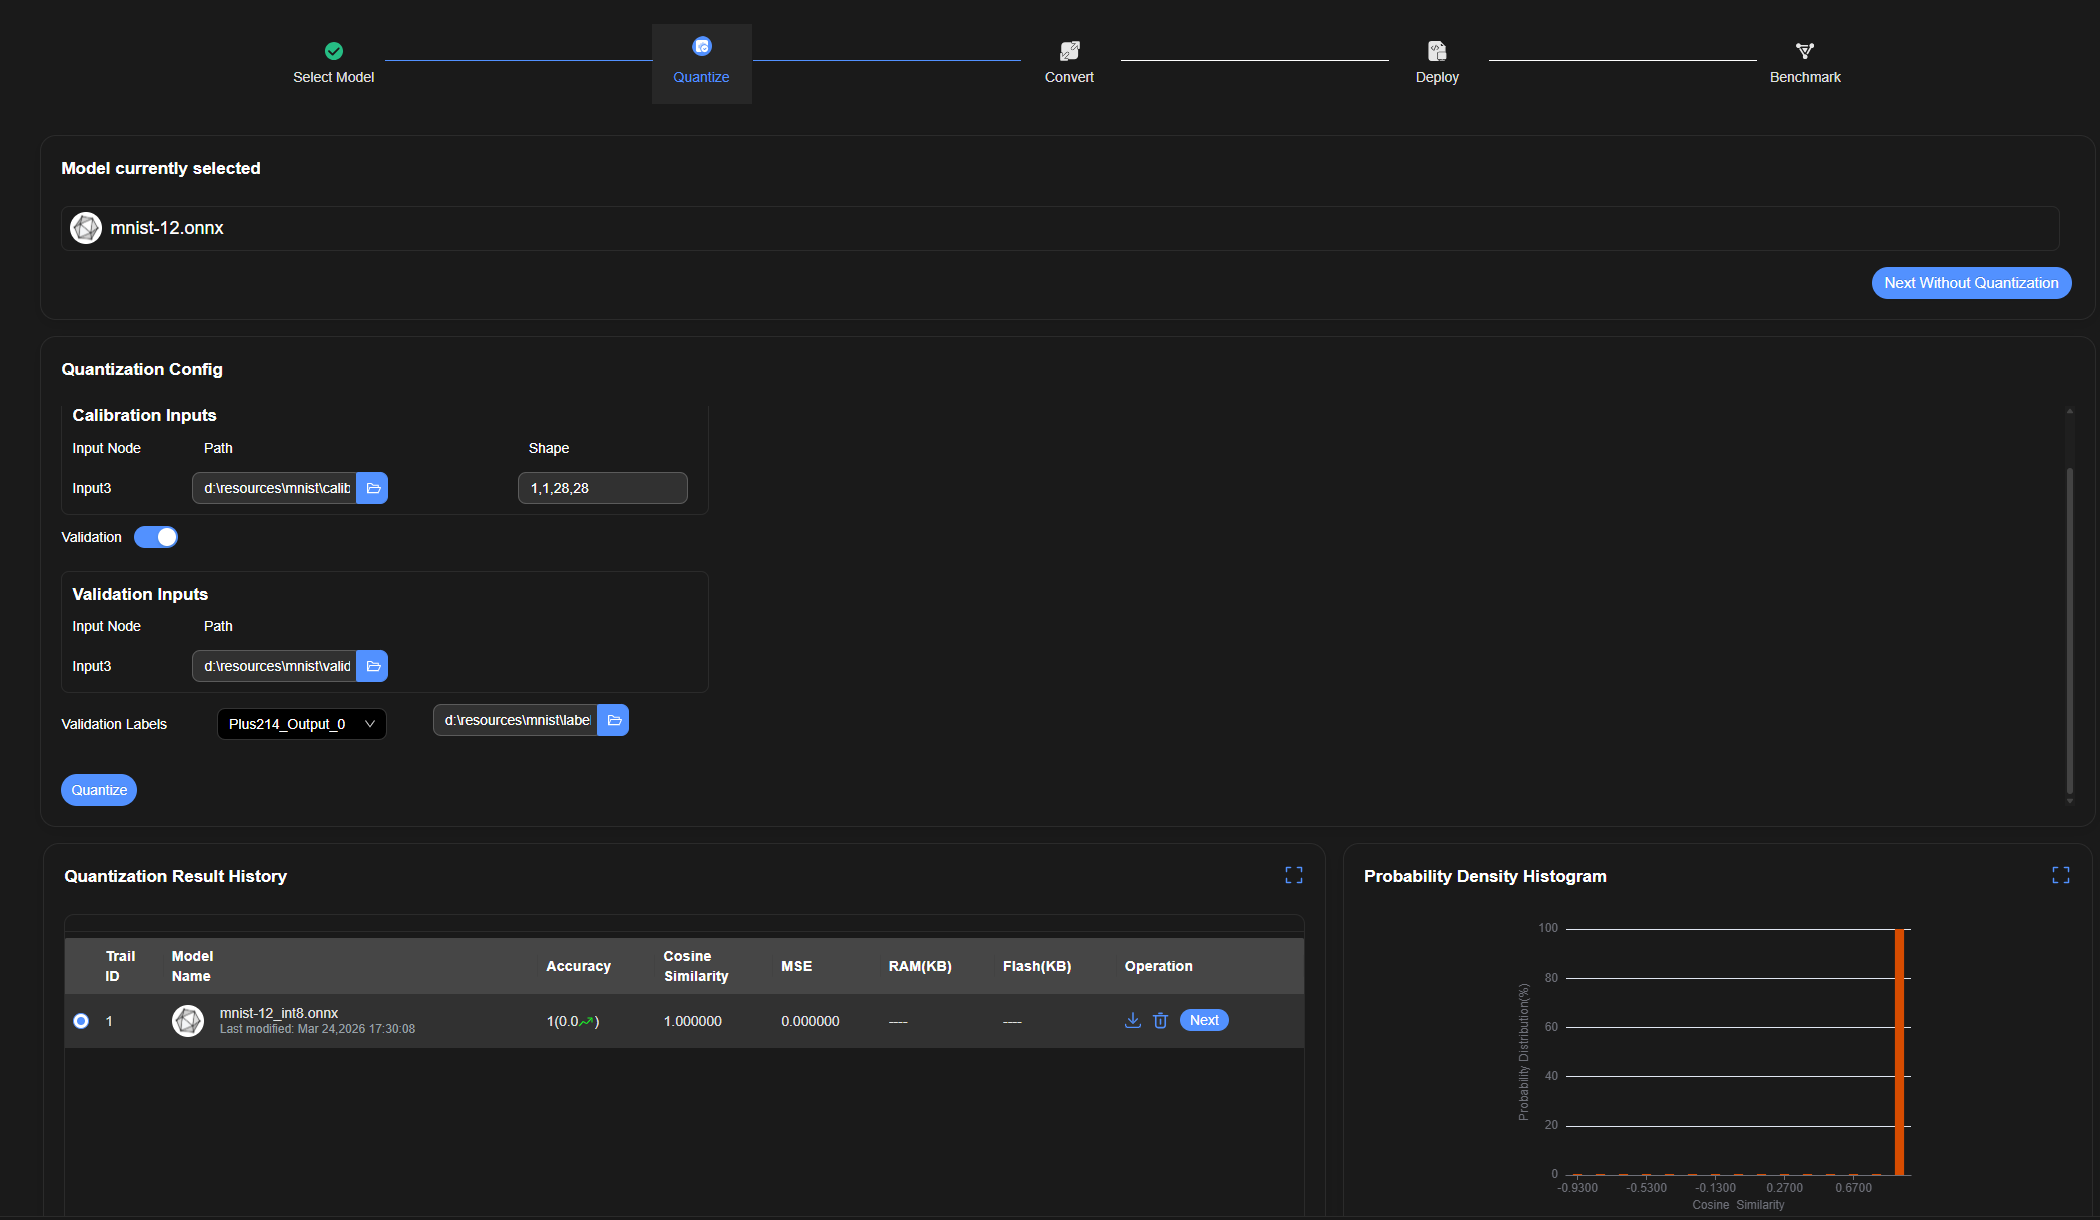
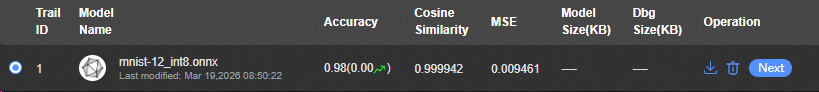
单击“Quantize”按钮,输出量化余弦相似度、准确率以及MSE等结果。
模型转换
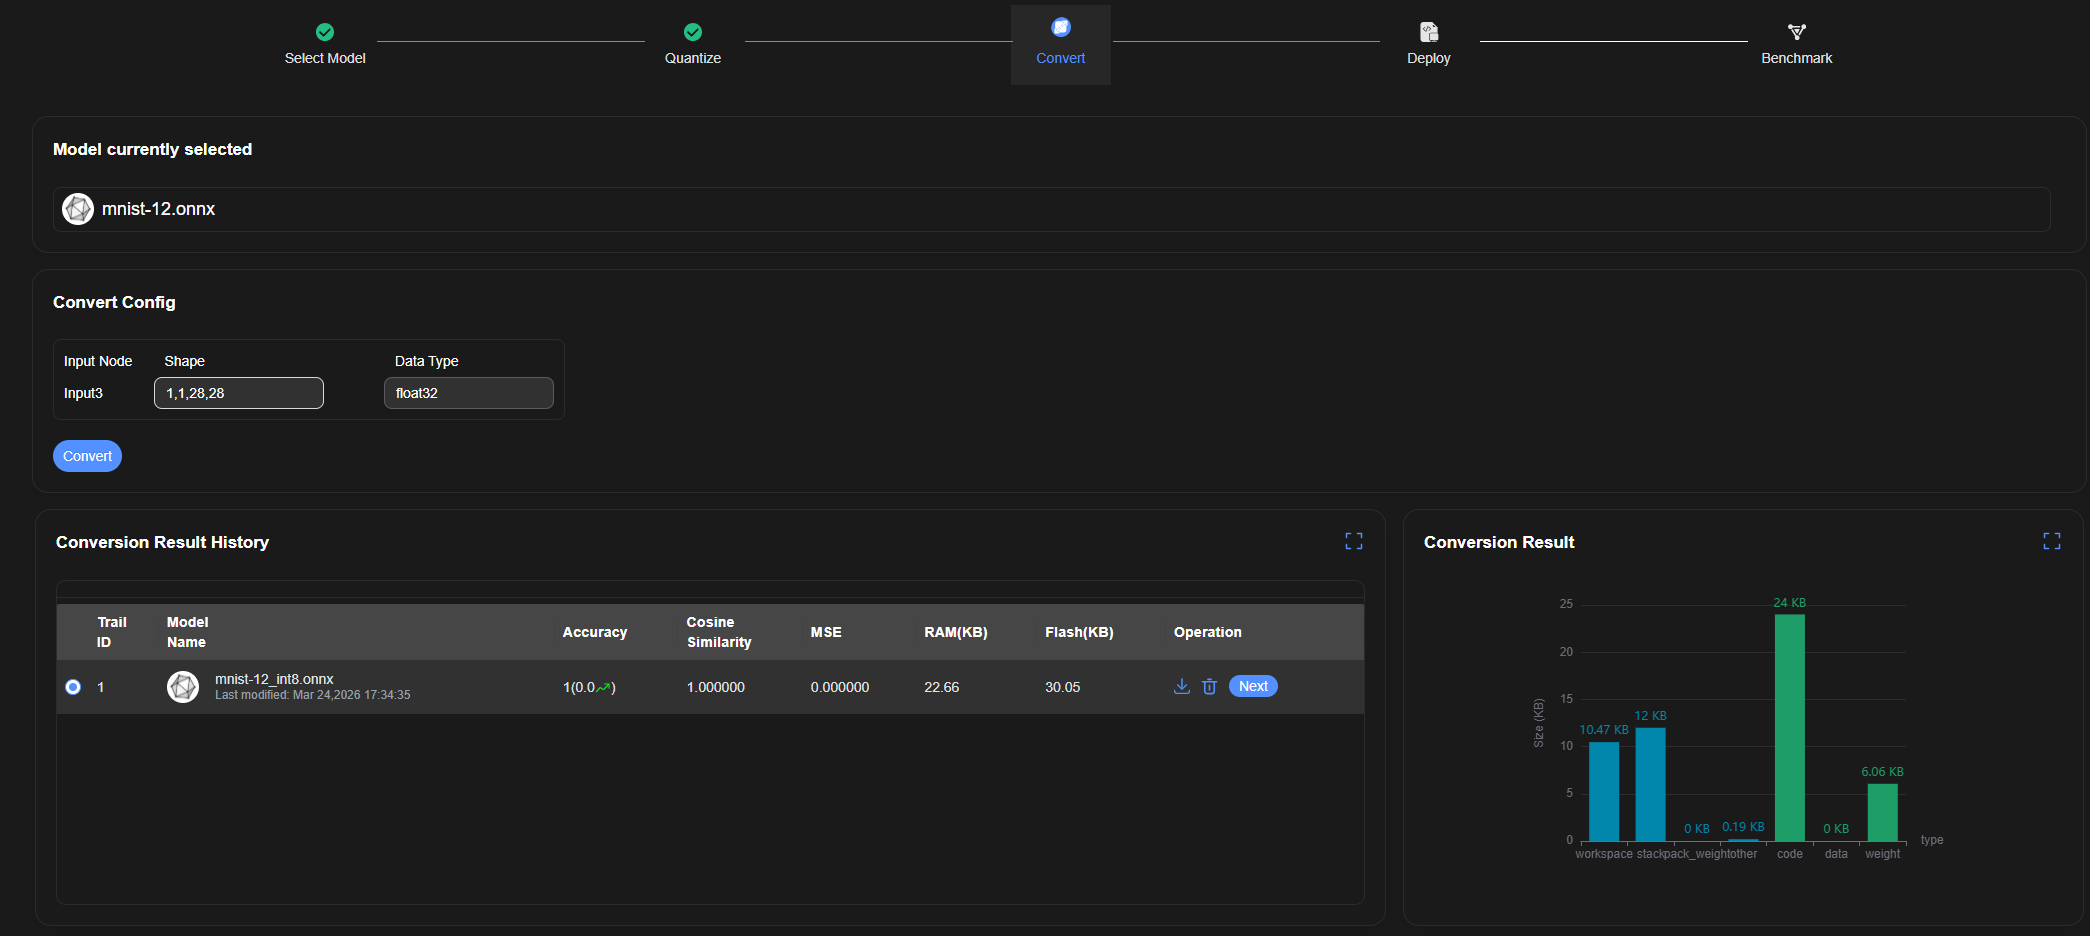
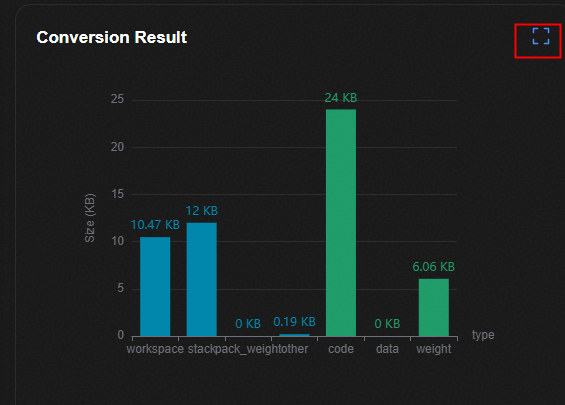
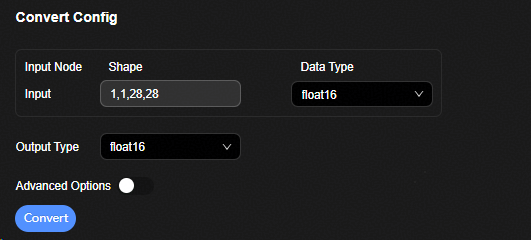
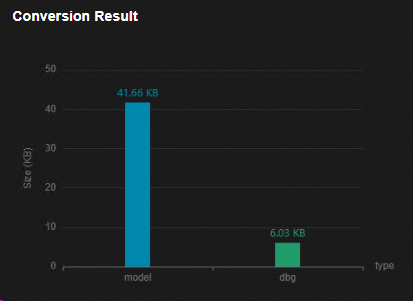
单击“Convert”按钮,完成模型转换,输出对应的RAM以及FLASH值。
模型部署
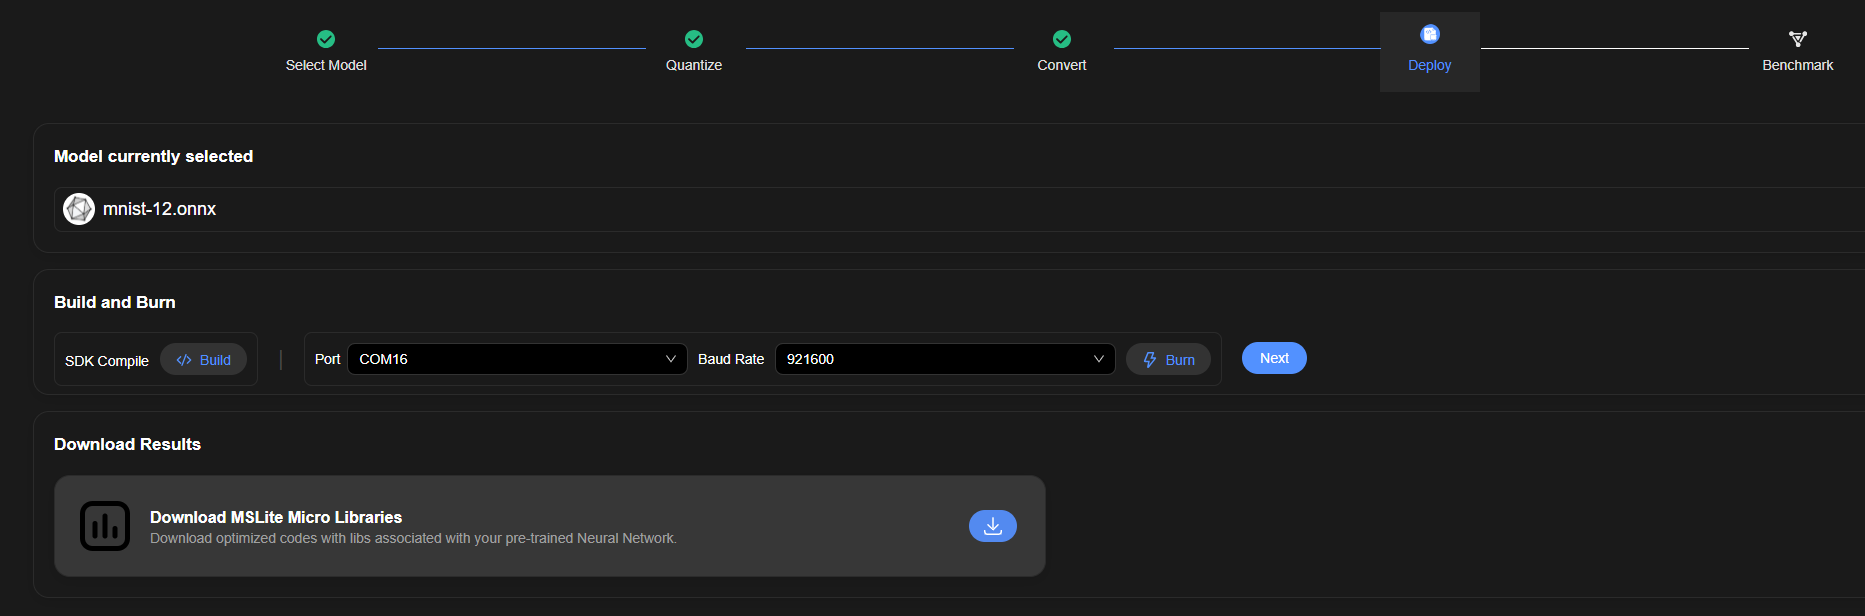
单击“Build”编译SDK,选择烧录串口与波特率,单击“Burn”开始烧录。
单击下方“Download Results”中的下载按钮下载前一步转换产物。
全部完成后,单击“Next”进入后续评估页面。
性能评估和精度评估
进入Benchmark模型评估页面。
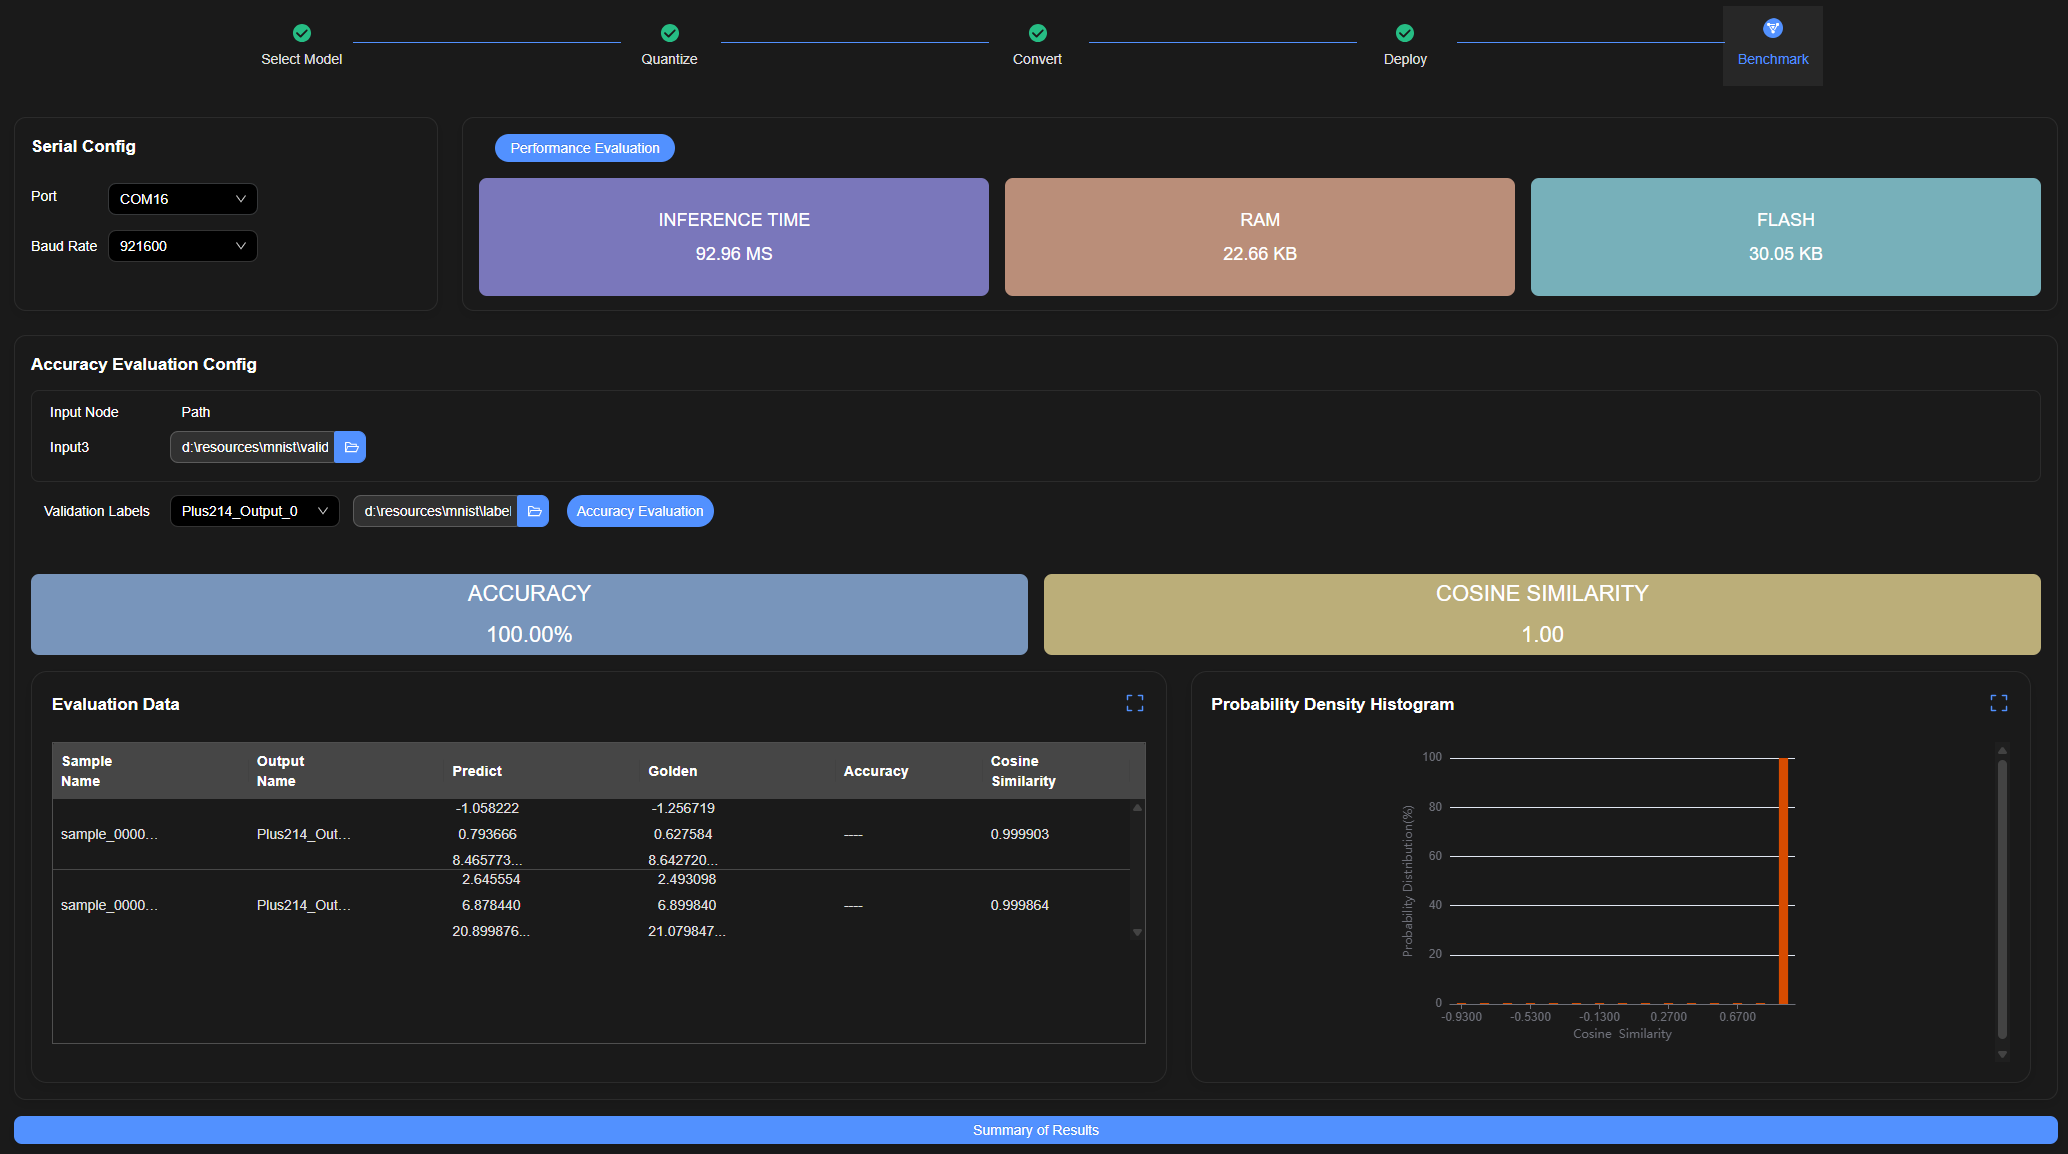
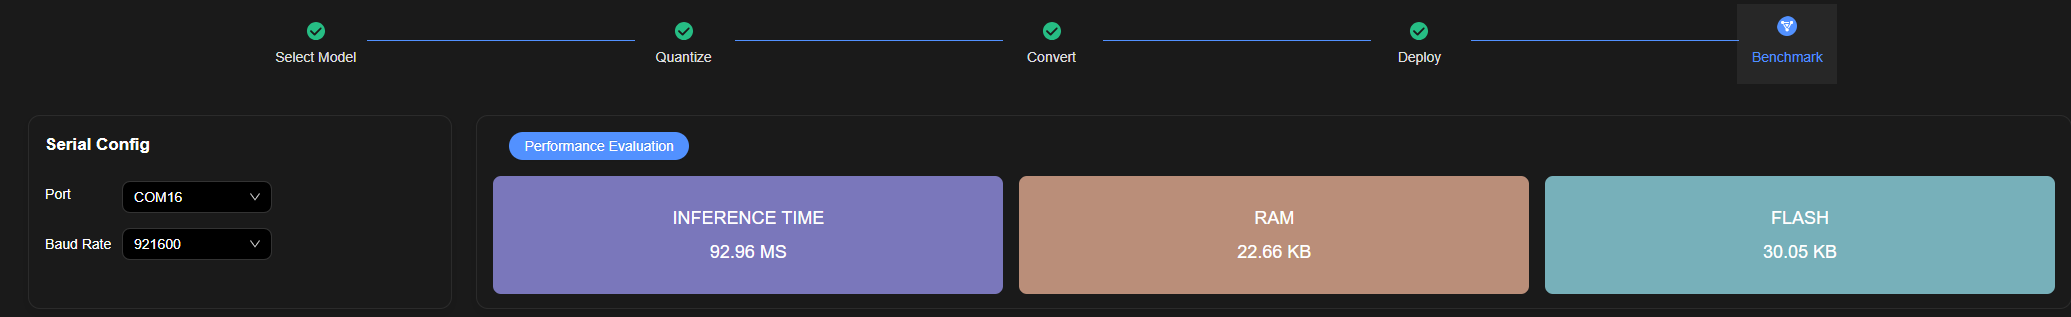
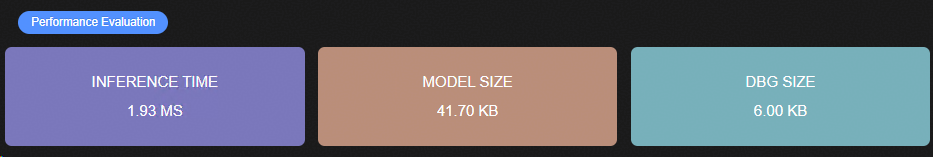
配置串口、波特率等信息,如图2,点击Performance Evaluation按钮,输出上板验证的推理时间、占用RAM、FLASH的值。
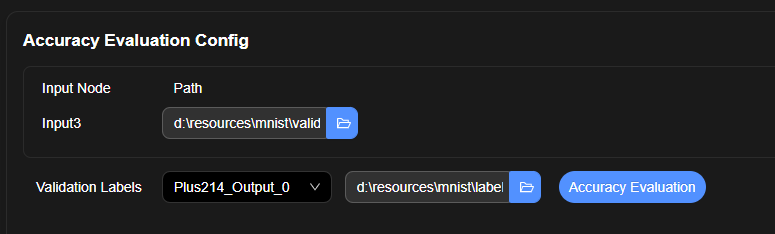
选择Accuracy Evaluation Config中对应的路径,并选择Validation Labels的label文件的值,配置项如图3,单击Accuracy Evaluation按钮。
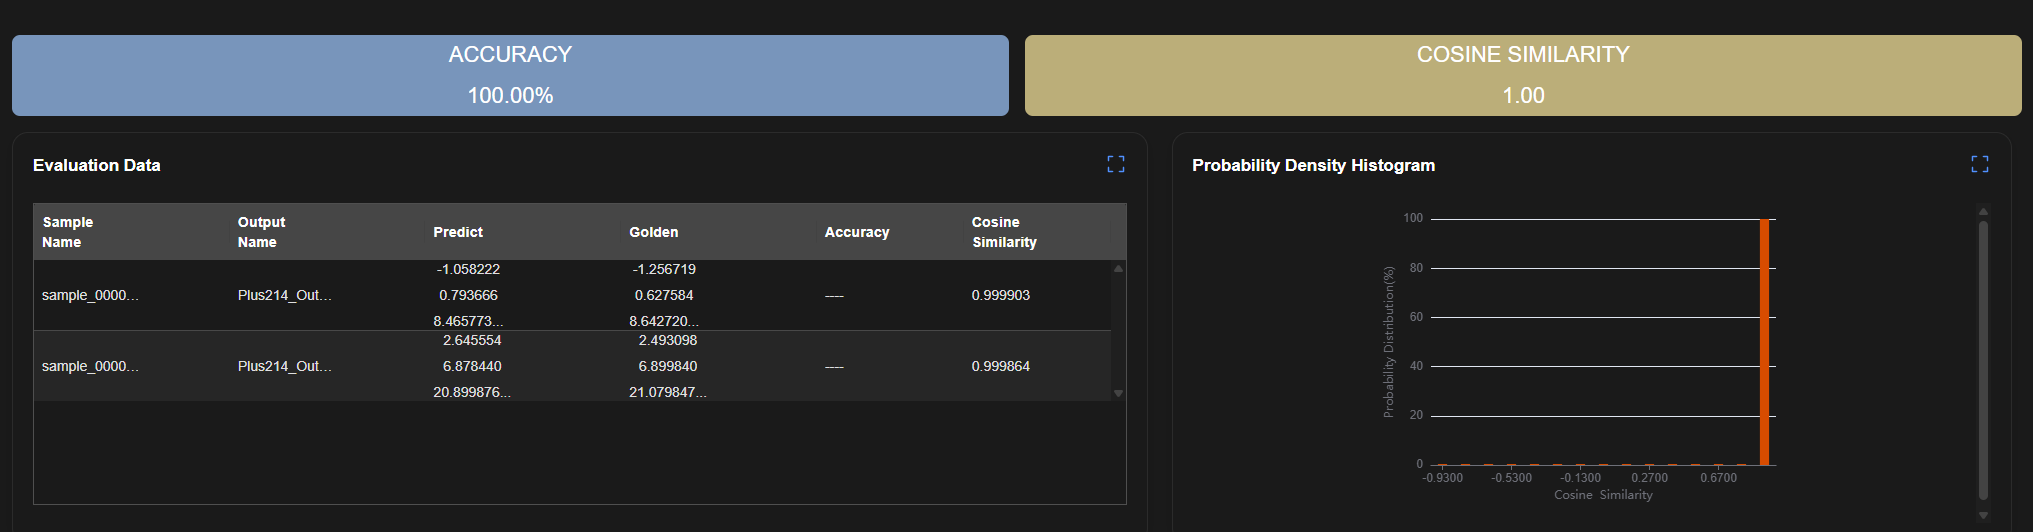
如图4输出验证数据结果的余弦相似度等值。
应用开发
在HiSpark Studio AI中完成模型量化、转换之后,将模型导出并使用HiSpark.AI API完成应用开发。具体步骤如下。
3322样例运行
本章节以LeNet5模型为例,介绍如何使用HiSpark Studio AI工具进行模型量化、转换、性能评估以及精度评估。如果需要使用命令行工具进行如上操作,请参考《Nano应用开发指南》。
模型与数据获取
模型获取。若使用Linux服务器端环境,请将模型上传到容器内。 3322进行训练后量化PTQ,请点击Link,下载ONNX模型;进行量化感知训练QAT,请点击Link,下载PyTorch模型权重文件。
点击Link,下载数据和预处理脚本“preproc_mnist_data.py”。请参考文档,生成数据。
若使用WSL环境,通过命令“wsl -d {WSL DISTRIB名称}”,进入WSL环境内,并执行该脚本,进行数据获取。
若使用Linux服务器端环境,在容器内执行该脚本,进行数据获取。
请确保文件夹内包含如下数据和文件。
.
|-- test_data
|   `-- npy
|       `-- sample_00000_7.npy
|       `-- ......
|       `-- sample_09999_6.npy
|   `-- label.csv
`-- train_data
|   `-- npy
|       `-- sample_00000_5.npy
|       `-- ......
|       `-- sample_59999_8.npy
|   `-- label.csv
说明:test_data和train_data目录作为数据下载和预处理脚本的输入参数,会根据用户的输入而变化。
label.csv中为样本分类的真值标签。文件中的表格格式如表1。其中sample列表示样本的名称。label列表示样本对应的真值标签。
表 1 label.csv格式示例
新建工程与选择模型
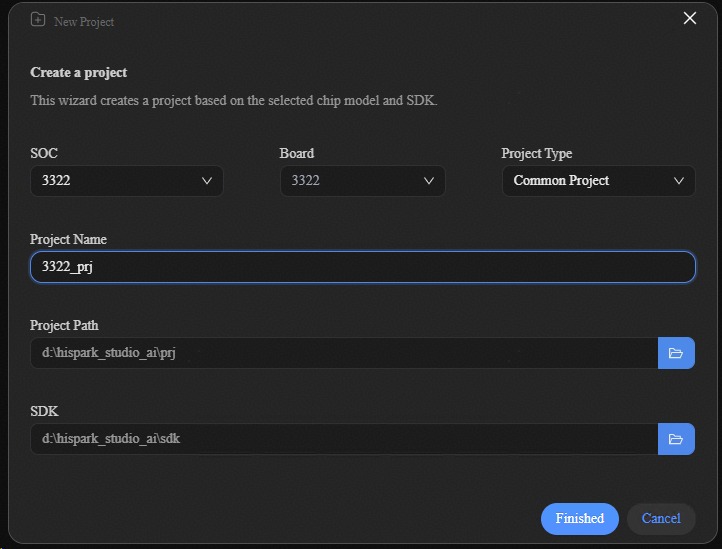
进入HiSpark Studio AI插件单击“Home”按钮,单击“Import Project”按钮进入新建工程页面。在弹出框中选择对应的芯片、开发板、平台。选择已经下载的SDK路径;并为工程设置好名字和工程文件保存地址。
单击“Finished”进入“Select Model”页面。
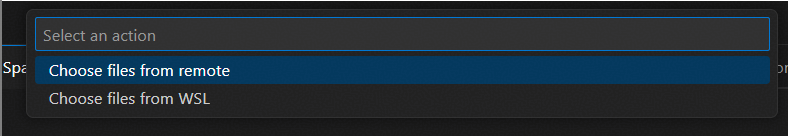
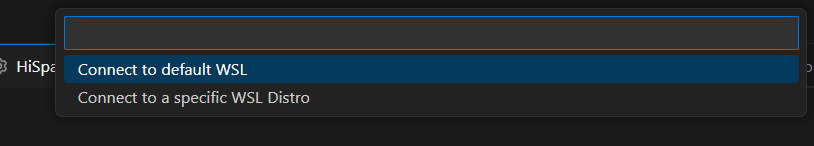
单击“Import Model”,并选择“模型与数据获取”章节下载的模型。 3322可选择从Linux服务器或WSL(本地)选择模型。通过如下弹窗选择模型所在的位置。
可选用自定义名称的镜像,或默认名称镜像(默认名称为ubuntu-22.04-cann-base)
若从Linux服务器选择模型,选择“Choose files from remote”。输入Docker的IP、端口号、用户名、密码。如下图所示
说明:
首次连接请根据提示设置远端连接。注意端口选择映射到容器内的服务器端口。3322工程导入模型后,自动跳转到量化页面。如果导入的模型为ONNX模型,跳转到训练后量化页面。如果导入的模型为PyTorch模型,跳转到量化感知训练界面。
3322模型量化
在“Quantize”页面对模型进行量化,并对量化后的评估模型进行精度验证,以帮助用户评估量化后的模型是否符合业务需求。精度验证的指标如表1 精度验证指标所示。
表 1 精度验证指标
{量化模型准确率}({量化模型与原始浮点模型准确率对比}) |
|

模型压缩“Quantize”页面提供训练后量化PTQ和量化感知训练QAT两种量化方式。
训练后量化
在“Quantization Config”中配置输入参数。
“Calibration Inputs”的Path列文件选择框中输入量化校准数据:选择“模型与数据获取”下载的训练数据文件夹下的npy子文件夹,若当前为Linux通路,则从Linux服务器上选择文件夹,如“train_data/npy”。若当前为WSL通路,则从Windows本地选择文件夹,如“D:\\train_data\\npy”。
打开“Validation”开关。
在“Validation Inputs”的Path列文件选择框中输入验证数据:选择“模型与数据获取”下载的测试数据文件夹下的npy子文件夹。若当前为Linux通路,则从Linux服务器上选择文件夹,如“test_data/npy”。若当前为WSL通路,则从Windows本地选择文件夹,如“D:\\test_data\\npy”。
“Validation Labels”下拉框选择对应的输出节点。并在文件输入验证数据的真值:选择框选择“模型与数据获取”下载的测试数据文件夹下的“label.csv”文件。
其他参数保持默认,或按需调整。
单击“Quantize”按钮开始量化。“OUTPUT”中输出如下类似信息,表示量化成功。
All quantization workflow steps completed successfully
INFO - HiSpark.AI: SUCCESS
在“Quantization Result History”中查看量化仿真模型在验证集的精度。
在“Probability Density Histogram”窗口查看验证样本余弦相似度的分布。
在“History of Compression results”的“Operation”列单击“Next”按钮,进入模型转换页面。
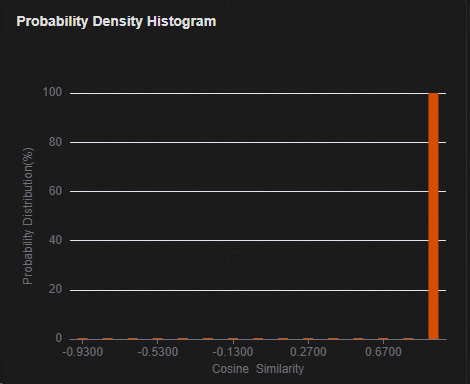
量化感知训练
配置“Quantization Config”中的输入参数
“Network Structure”文件选择框中选择结构定义的 python文件,选择完成后,后台自动触发结构解析和校验流程。网络结构定义示意如下。在网络定义时,请满足如下约束:网络结构类的名称固定为NNModel;当前只支持单输入和单输出网络,因此forward函数的输入输出类型为torch.Tensor;构造函数不包含除self外的其他入参,如果有其他入参请配置默认值。
class NNModel(nn.Module):
    def __init__(self) -> None:
        """Initialize network layers and components."""
        super(NNModel, self).__init__()

        self.conv1 = nn.Conv2d(1, 8, kernel_size=(5, 5), padding=2)
        self.relu1 = nn.ReLU()
        self.maxpool1 = nn.MaxPool2d(kernel_size=(2, 2), stride=(2, 2), padding=(0, 0), dilation=1, ceil_mode=False)

        self.conv2 = nn.Conv2d(8, 16, kernel_size=(5, 5), padding=2)
        self.relu2 = nn.ReLU()
        self.maxpool2 = nn.MaxPool2d(kernel_size=(3, 3), stride=(3, 3), padding=(0, 0), dilation=1, ceil_mode=False)

        self.fc = torch.nn.Linear(256, 10, bias=True)

    def forward(self, img):
        """
        Forward pass of the network.

        Args:
            x (torch.Tensor): Input tensor with shape (batch_size, 1, 28, 28)

        Returns:
            torch.Tensor: Output logits with shape (batch_size, 10)
        """
        out = self.conv1(img)
        out = self.relu1(out)
        out = self.maxpool1(out)
        out = self.conv2(out)

        out = self.relu2(out)
        out = self.maxpool2(out)
        out = out.reshape(-1, 256)
        out = self.fc(out)
        return out
Input 栏的Training Dataset 文件选择框中选择“模型与数据获取”下载的训练数据文件夹下的npy子文件夹,若当前为Linux通路,则从Linux服务器上选择文件夹,如“train_data/npy”,若当前为WSL通路,则从Windows本地选择文件夹,如“D:\\train_data\\npy”。
Input栏的 Validation Dataset 文件选择框中选择“模型与数据获取”下载的测试数据文件夹下的npy子文件夹,如:test_data/npy。若当前为Linux通路,则从Linux服务器上选择文件夹,如“test_data/npy”,若当前为WSL通路,则从Windows本地选择文件夹,如“D:\\test_data\\npy”。
Label 栏的 Training Dataset文件选择框选择“模型与数据获取”下载的训练数据文件夹下的“label.csv”文件。若当前为Linux通路,则从Linux服务器上选择文件,若当前为WSL通路,则从Windows本地选择文件。
Label 栏的 Validation Dataset 文件选择框选择“模型与数据获取”下载的测试数据文件夹下的“label.csv”文件。若当前为Linux通路,则从Linux服务器上选择文件,若当前为WSL通路,则从Windows本地选择文件。
设定训练epoch数。
EPOCH_NUM = 1设定训练的batch_size。
BATCH_SIZE = 4设定学习率。
LEARNING_RATE = 0.00001其他参数保持默认,或按需调整。
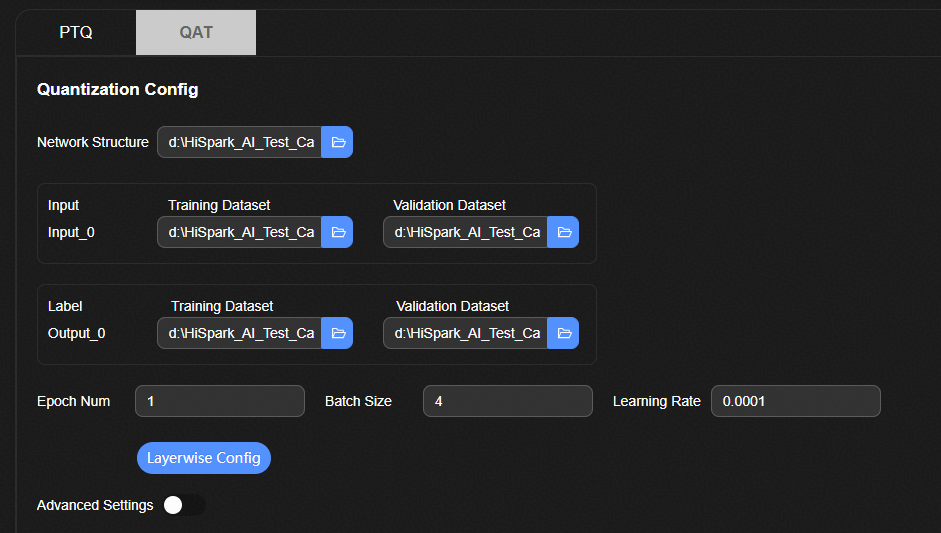
单击“Quantize”按钮开始量化感知训练。“OUTPUT”框中出现如下类似信息,说明量化感知训练成功。
All workflow steps completed successfully在“Quantization Result History”中查看量化仿真模型在验证集的精度。
在“Probability Density Histogram”窗口查看验证样本余弦相似度的分布。
在“Quantization Result History ”的“Operation”列单击“Next”按钮,进入模型转换页面。
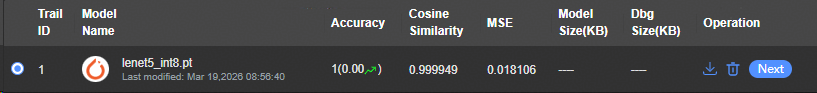
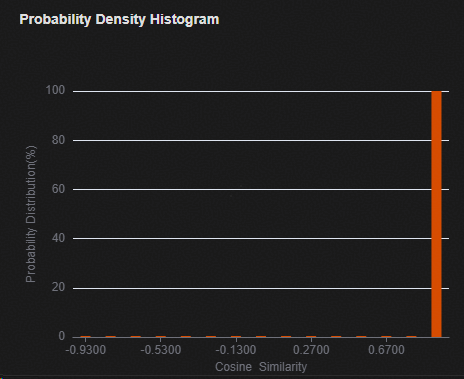
模型转换
在“Convert”模型转换页面将模型进行转换,得到适配NPU IP加速器的离线模型:3322转换量化后的模型。具体步骤如下。
模型部署
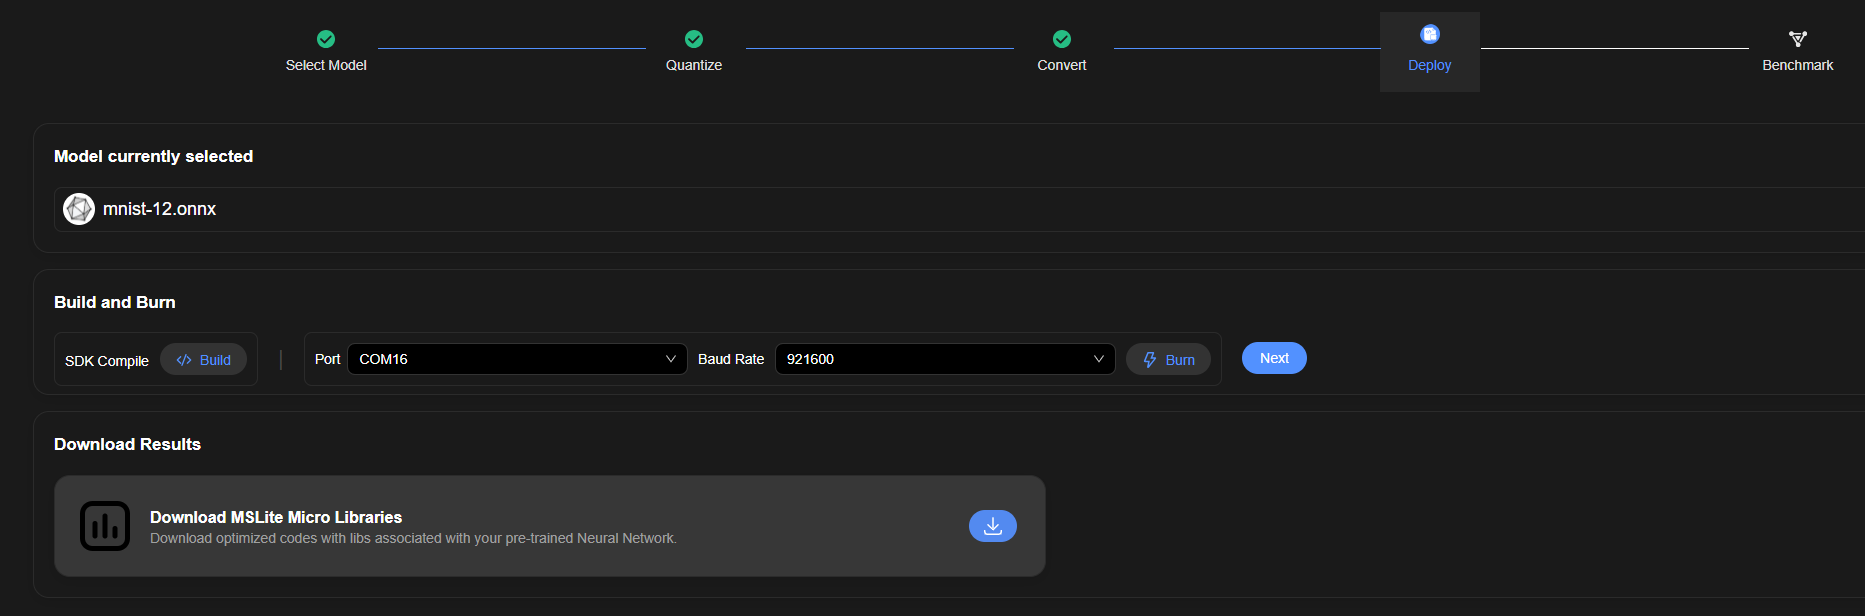
单击“Build”编译SDK,选择烧录串口与波特率,单击“Burn”开始烧录。
说明:
3322通过串口进行烧录,在界面中配置串口。单击下方“Download Results”中的下载按钮下载前一步转换产物。
全部完成后,单击“Next”进入后续评估页面。
性能评估和精度评估
HiSpark Studio AI提供连板性能评估和精度评估功能。在开始性能评估和精度评估前,请按照3322硬件指导完成对应单板硬件环境的准备。
性能评估自动将转换的模型上传到单板,在端侧推理模型并统计模型推理性能。
精度评估自动将转换的模型和验证集上传到单板,在端侧推理模型;并和原始浮点模型以及真值标签对比,计算精度指标。
性能评估和精度评估的具体步骤如下。
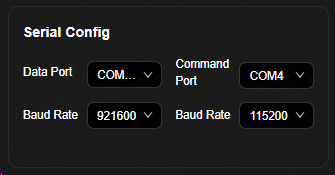
在“Serial Config”窗口配置数据传输和命令发送的端口、波特率。
单击“Performance Evaluation”按钮,完成模型上板性能验证。验证完成后,在性能验证窗口显示推理时间和模型大小。
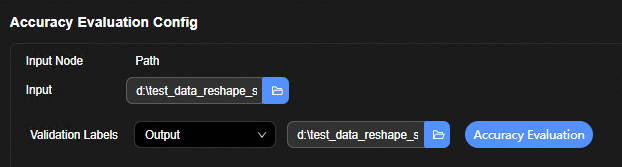
在“Accuracy Evaluation Config”窗口配置精度验证数据集。
单击“Accuracy Evaluation”按钮,开始上板精度验证。
在“BALANCED ACCURACY”窗口查看上板精度验证的精度值。该值为使用为“label.csv”中的标签真值计算的结果。在“COSINE SIMILARITY”窗口查看样本上板推理结果和PC端浮点网络推理结果的余弦相似度。
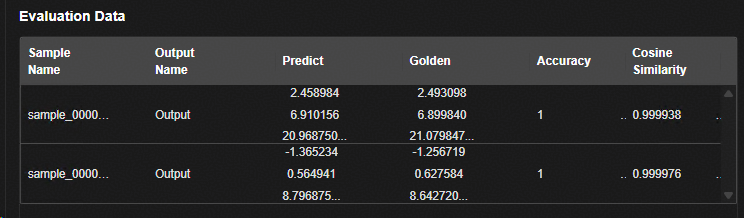
在“Evaluation Data”窗口查看验证集各个样本的验证结果。
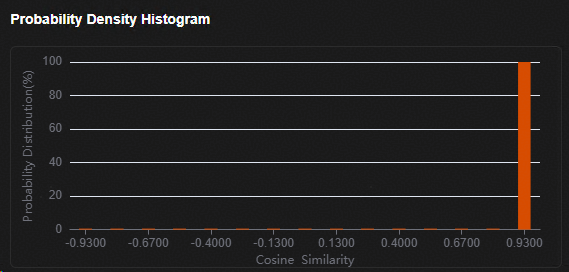
在“Probability Density Histogram”窗口查看验证样本余弦相似度的分布。

注意: 如果端侧推理时间长于预期,请检查单板设置是否正常,如单板日志等级设置。
应用开发
在HiSpark Studio AI中完成模型转换后,将模型导出并使用HiSpark.AI API完成应用开发。具体步骤如下。
常见错误
3322 DebugKits弹窗告警“The board does not respond!”
可能原因,3322单板开启低功耗模式,请关闭低功耗模式后重试。请先手动通过SSCOM下发如下AT命令关闭低功耗模式。
AT^PM=0