前言

概述

本文档详细描述了_图像分析引擎_2开发和_图像分析引擎_1的开发差异。

产品版本

与本文档相对应的产品版本如下。

产品名称

产品版本

SS928

V100

SS927

V100

读者对象

本文档主要适用于以下工程师:

  • 技术支持工程师

  • 软件开发工程师

修订记录

修订记录累积了每次文档更新的说明。最新版本的文档包含以前所有文档版本的更新内容。

文档版本

发布日期

修改说明

00B01

2025-09-15

第1次临时版本发布。

SDK接口差异

风格差异

图像分析引擎1为ACL接口,图像分析引擎2为SVP ACL接口。

为了避免编译时符号冲突,SVP ACL使用linux风格,宏定义和枚举采用SVP_ACL_前缀;ACL使用的驼峰风格,宏定义和枚举采用ACL_前缀。函数、宏定义、枚举以及结构体详细差异参见表1。

表 1 风格差异示例

差异

ACL接口

SVP_ACL接口

函数

aclInit(const char *configPath)
svp_acl_init(const char *config_path)

宏定义

#define ACL_MAX_DIM_CNT          128
#define SVP_ACL_MAX_DIM_CNT          128

枚举

typedef enum aclrtRunMode {
    ACL_DEVICE,
    ACL_HOST,
} aclrtRunMode;
typedef enum svp_acl_rt_run_mode {
    SVP_ACL_DEVICE,
    SVP_ACL_HOST,
} svp_acl_rt_run_mode;

结构体

typedef struct aclmdlIODims {
    char name[ACL_MAX_TENSOR_NAME_LEN];
    size_t dimCount;
    int64_t dims[ACL_MAX_DIM_CNT];
} aclmdlIODims;
typedef struct svp_acl_mdl_io_dims {
    char name[SVP_ACL_MAX_TENSOR_NAME_LEN];
    size_t dim_count;
    int64_t dims[SVP_ACL_MAX_DIM_CNT];
} svp_acl_mdl_io_dims;

使用差异

创建databuffer函数

由于_图像分析引擎_2逻辑在执行的时候,输入输出数据需要传入stride,用于逻辑读/写操作时快速跳到下一行,因此在创建和更新data buffer的时候会增加一个stride入参。

表 1 创建data buffer函数差异

功能

ACL函数

SVP_ACL函数

创建

aclCreateDataBuffer(void *data, size_t size);
svp_acl_data_buffer *svp_acl_create_data_buffer(void *data, size_t size, size_t stride)

更新

aclUpdateDataBuffer(aclDataBuffer *dataBuffer, void *data, size_t size);
svp_acl_update_data_buffer(svp_acl_data_buffer *data_buffer, void *data, size_t size, size_t stride);

由于引入stride,所以SVP ACL接口返回的输入输出size是按照stride对齐后的内存大小,为了方便获取stride,SVP_ACL接口新增了与stride操作相关的函数,增加函数见下表:

表 2 新增stride相关函数

功能

SVP_ACL函数

备注

从data buffer中获取配置的stride

size_t svp_acl_get_data_buffer_stride(const svp_acl_data_buffer *data_buffer);

无。

获取模型输入数据的默认stride

size_t svp_acl_mdl_get_input_default_stride(const svp_acl_mdl_desc *model_desc, size_t index);

stride按照输入维度最后一维对齐。

获取模型输出数据的默认stride

size_t svp_acl_mdl_get_output_default_stride(const svp_acl_mdl_desc *model_desc, size_t index);

stride按照输出维度最后一维对齐。

模型加载函数

SVP_ACL模型加载函数为svp_acl_mdl_load_from_mem(),其实现与ACL对应接口的差异如下。

表 1 模型加载函数差异

说明

函数

差异

ACL模型加载函数

aclError aclmdlLoadFromMem(const void *model,  size_t modelSize, uint32_t *modelId);
  1. 会将model内存中存储的权重参数拷贝到内部开辟的一块内存,因此该接口调用完后,model内存可以被释放。
  2. task_buf和work_buf都是内部管理

SVP_ACL模型加载

svp_acl_error svp_acl_mdl_load_from_mem(const void *model, size_t model_size, uint32_t *model_id)
  1. 不会拷贝model内存中的权重到其他内存,因此在卸载模型之前,model内存不能被释放。
  2. task_buf和work_buf由用户管理。

获取模型输入个数函数

为了使模型独立于device,context以及stream,SVP ACL将task_buf和work_buf独立出来由用户管理,模型执行的时候作为输入传入,在保证task_buf和work_buf正确使用的情况下,使得模型可以同时被同步,异步,多线程或者多device执行,输入变化如图1所示。
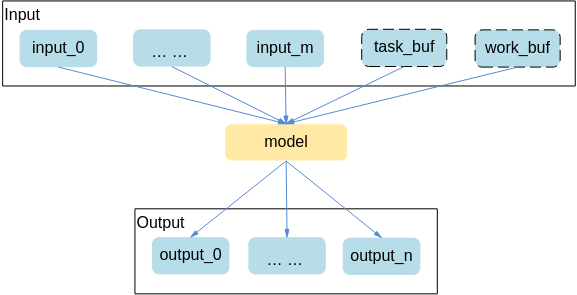
图 1 模型输入/输出数据

因此SVP ACL修改了模型输入接口的特性,差异说明如表1所示。

表 1 获取输入个数接口差异

说明

函数

差异

ACL获取模型输入个数函数

size_t aclmdlGetNumInputs(aclmdlDesc *modelDesc);

获取的是实际模型输入个数M。

SVP_ACL获取模型输入个数函数

size_t svp_acl_mdl_get_num_inputs(const svp_acl_mdl_desc *model_desc)

获取的个数比模型实际输入个数多2个,为M+2。

依据数据类型获取数据大小

SVP ACL为了支持紧密排布的RAW数据,如输入为12bit或14bit紧密排布。这样数据bit长度就不是8bit的整数倍,无法用Byte为单位表示,因此SVP ACL依据数据类型获取数据大小的时候返回值为bit数,而不是Byte数,差异如表1所示。

表 1 获取数据大小接口差异

说明

函数

差异

ACL依据数据类型获取数据size

size_t aclDataTypeSize(aclDataType dataType);

返回值为Byte数

SVP_ACL依据数据类型获取数据size

size_t svp_acl_data_type_size(svp_acl_data_type data_type)

返回值为bit数。

板端环境安装差异

图像分析引擎1需要配置两个环境变量LD_LIBRARY_PATH以及ASCEND_AACPU_KERNEL_PATH,以SS928V100为例,相关库路径为/xxx(客户自定义)/smp/a55_linux/mpp/out/lib/nnn,其他解决方案类似,需要强调的是ASCEND_AACPU_KERNEL_PATH不支持路径拼接,因此在设定时需注意不能使用拼接路径。

图像分析引擎2只需要配置环境变量LD_LIBRARY_PATH,以SS928V100为例,相关库路径为/xxx(客户自定义)/smp/a55_linux/mpp/out/lib/svp_nnn,其他解决方案类似。

Recurrent网络执行

ACL不支持T可变,只支持N可变,也就是输入帧数一定是T的整数倍,SVP ACL支持Recurrent函数T可以变,N只能为1,因此增加接口用于用户配置每次执行中实际的总帧数的接口:

svp_acl_error svp_acl_mdl_set_total_t(uint32_t model_id, svp_acl_mdl_dataset *dataset, uint64_t total_t)

动态batch

SVP ACL支持配置任意batch值,只要不超过目前SDK的约束范围,图像最大batch为256,非图像最大batch是5000。在执行前模型前通过svp_acl_mdl_set_dynamic_batch_size()函数配置本次执行要处理的实际batch数。可以通过svp_acl_mdl_get_dynamic_batch()接口获取模型中配置的batch数(只支持一个档位),注意获取的不是svp_acl_mdl_set_dynamic_batch_size()函数配置的batch数。

获取模型中模式识别cpu任务个数

如果模型中含有_模式识别_CPU算子,模型执行异步推理的时候需要起一个线程调用_模式识别_CPU任务处理函数,为了对外能感知模型中是否函数_模式识别_CPU算子,从而决定是否要起_模式识别_CPU任务处理线程,SVP ACL增加函数来获取模型中_模式识别_CPU任务个数,如果为0,则不需要起线程,反之则要起_模式识别_CPU任务处理线程,新增接口如下。

svp_acl_error svp_acl_ext_get_mdl_aacpu_task_num(uint32_t model_id, uint32_t *num);

数据排布

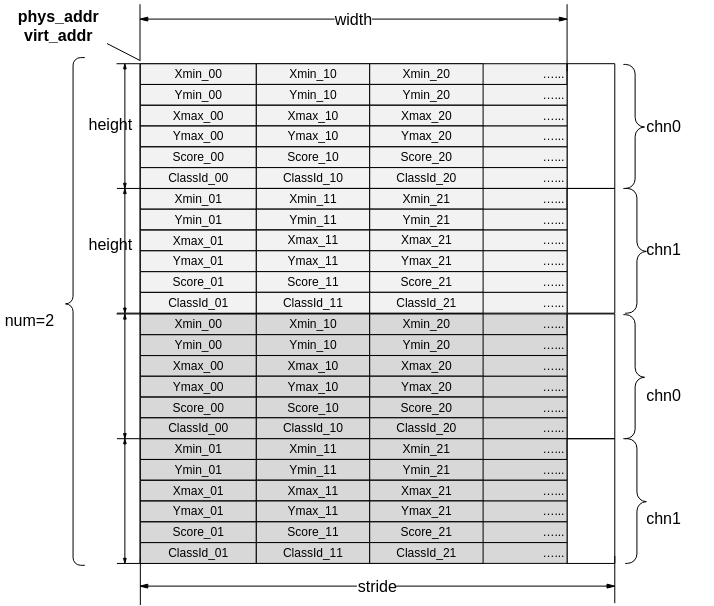
  1. SVP_ACL统一输入输出数据格式如图1所示(YVU420SP/YUV420SP除外)。

    • 如果是RGB_PACKAGE格式,data_xx数据类型为U24,通道数为1。

    • 如果是XRGB_PACKAGE格式,data_xx数据类型为U32,通道数为1。

    图 1 模型输入/输出数据排布(2通道,batch为2示意图)

  2. YVU420SP/YUV420SP数据排布如图2所示。

    图 2 YVU420SP数据排布(2通道,frame为2示意图)

  3. 在SVP ACL为了让使用者软件开发人员不用感知检测网网络类型,将检测网输出框结果排布统一成如图3格式。

    图 3 检测网输出框结果数据排布(2通道,chn为2示意图)

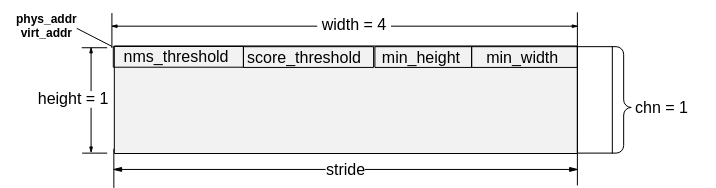
  4. SVP ACL支持检测网阈值通过data层传入,阈值输入固定长度为4,分别nms_threshold,score_threshold,min_height,min_width,排布格式如图4所示。
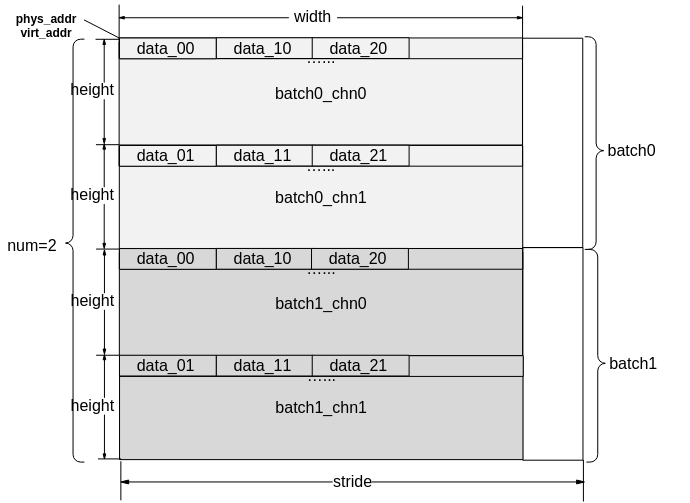
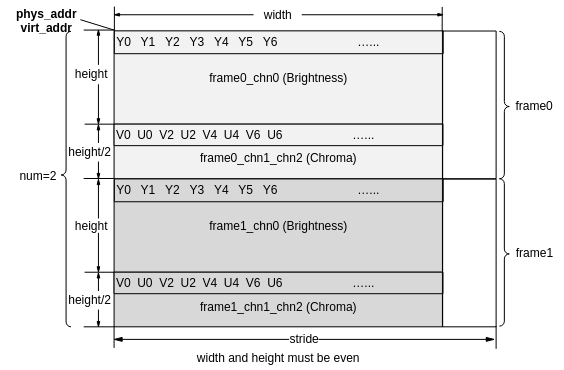
    图 4 阈值输入数据排布

支持的接口

表 1 支持的接口差异

目录

目录或ACL接口或ACL数据类型

目录或ACL接口

SVP_ACL是否有对应接口或数据类型

系统配置

aclInit

-

是

aclFinalize

-

是

aclrtGetVersion

-

否

aclrtGetSocVersion

-

否

aclGetRecentErrMsg

-

否

Device管理

aclrtSetDevice

-

是

aclrtResetDevice

-

是

aclrtGetDevice

-

是

aclrtGetRunMode

-

是

aclrtSetTsDevice

-

否

aclrtGetDeviceCount

-

是

Context管理

aclrtCreateContext

-

是

aclrtDestroyContext

-

是

aclrtSetCurrentContext

-

是

aclrtGetCurrentContext

-

是

算力Group查询与设置

aclrtSetGroup

-

否

aclrtGetGroupCount

-

否

aclrtCreateGroupInfo

-

否

aclrtDestroyGroupInfo

-

否

aclrtGetAllGroupInfo

-

否

aclrtGetGroupInfoDetail

-

否

Stream管理

aclrtCreateStream

-

是

aclrtDestroyStream

-

是

同步等待

aclrtCreateEvent

-

否

aclrtCreateEventWithFlag

-

否

aclrtDestroyEvent

-

否

aclrtRecordEvent

-

否

aclrtResetEvent

-

否

aclrtQueryEvent

-

否

aclrtSynchronizeEvent

-

否

aclrtEventElapsedTime

-

否

aclrtStreamWaitEvent

-

否

aclrtSynchronizeDevice

-

是

aclrtSynchronizeStream

-

是

aclrtSubscribeReport

-

是

aclrtLaunchCallback

-

是

aclrtProcessReport

-

是

aclrtUnSubscribeReport

-

是

aclrtSetExceptionInfoCallback

-

否

aclrtGetTaskIdFromExceptionInfo

-

否

aclrtGetStreamIdFromExceptionInfo

-

否

aclrtGetThreadIdFromExceptionInfo

-

否

aclrtGetDeviceIdFromExceptionInfo

-

否

aclrtSetOpWaitTimeout

-

是

内存管理

aclrtMalloc

-

是

aclrtMallocCached

-

是

aclrtMemFlush

-

是

aclrtMemInvalidate

-

是

aclrtFree

-

是

aclrtMallocHost

-

是

aclrtFreeHost

-

是

aclrtMemset

-

否

aclrtMemsetAsync

-

否

aclrtMemcpy

-

否

aclrtMemcpyAsync

-

否

aclrtGetMemInfo

-

否

aclrtDeviceCanAccessPeer

-

否

aclrtDeviceEnablePeerAccess

-

否

aclrtDeviceDisablePeerAccess

-

否

模型加载与执行

aclmdlLoadFromFile

-

否

aclmdlLoadFromMem

-

是

aclmdlLoadFromFileWithMem

-

否

aclmdlLoadFromMemWithMem

-

否

aclmdlLoadFromFileWithQ

-

否

aclmdlLoadFromMemWithQ

-

否

aclmdlExecute

-

是

aclmdlExecuteAsync

-

是

aclmdlUnload

-

是

aclmdlQuerySize

-

否

aclmdlQuerySizeFromMem

-

否

aclmdlSetDynamicBatchSize

-

是

aclmdlSetDynamicHWSize

-

是

aclmdlSetInputAAPP

-

否

aclmdlGetFirstAappInfo

-

是

aclmdlGetAappType

-

否

aclmdlSetAAPPByInputIndex

-

否

aclmdlSetInputDynamicDims

-

否

aclmdlCreateAndGetOpDesc

-

否

aclmdlInitDump

-

是

aclmdlSetDump

-

是

aclmdlFinalizeDump

-

是

aclmdlSetConfigOpt

-

是

aclmdlLoadWithConfig

-

是

算子编译

aclopRegisterCompileFunc

-

否

aclopUnregisterCompileFunc

-

否

aclopCreateKernel

-

否

aclopSetKernelArgs

-

否

aclopSetKernelWorkspaceSizes

-

否

aclopUpdateParams

-

否

算子加载与执行

aclopSetModelDir

-

否

aclopLoad

-

否

aclopExecute

-

否

aclopExecuteV2

-

否

aclopExecWithHandle

-

否

aclopInferShape

-

否

CBLAS接口

aclblasGemvEx

-

否

aclblasCreateHandleForGemvEx

-

否

aclblasHgemv

-

否

aclblasCreateHandleForHgemv

-

否

aclblasS8gemv

-

否

aclblasCreateHandleForS8gemv

-

否

aclblasGemmEx

-

否

aclblasCreateHandleForGemmEx

-

否

aclblasHgemm

-

否

aclblasCreateHandleForHgemm

-

否

aclblasS8gemm

-

否

aclblasCreateHandleForS8gemm

-

否

aclopCast

-

否

aclopCreateHandleForCast

-

否

媒体数据处理

内存申请与释放

acldvppMalloc

否

acldvppFree

否

通道创建与释放

acldvppCreateChannel

否

acldvppDestroyChannel

否

aclvdecCreateChannel

否

aclvdecDestroyChannel

否

aclvencCreateChannel

否

aclvencDestroyChannel

否

VPC功能

acldvppVpcResizeAsync

否

acldvppVpcCropAsync

否

acldvppVpcBatchCropAsync

否

acldvppVpcCropAndPasteAsync

否

acldvppVpcBatchCropAndPasteAsync

否

acldvppVpcBatchCropAndMakeBorder

否

acldvppVpcConvertColorAsync

否

acldvppVpcPyrDownAsync

否

acldvppVpcEqualizeHistAsync

否

acldvppVpcMakeBorderAsync

否

acldvppVpcCalcHistAsync

否

JPEGD功能

acldvppJpegDecodeAsync

否

acldvppJpegGetImageInfo

否

acldvppJpegGetImageInfoV2

否

acldvppJpegPredictDecSize

否

JPEGE功能

acldvppJpegEncodeAsync

否

acldvppJpegPredictEncSize

否

PNGD功能

acldvppPngDecodeAsync

否

acldvppPngGetImageInfo

否

acldvppPngPredictDecSize

否

VDEC功能

aclvdecSendFrame

否

aclvdecSendSkippedFrame

否

aclvdecCallback

否

VENC功能

aclvencSendFrame

否

aclvencCallback

否

日志管理

aclAppLog

-

否

特征向量检索

aclfvInit

-

否

aclfvRelease

-

否

aclfvRepoAdd

-

否

aclfvRepoDel

-

否

aclfvDel

-

否

aclfvModify

-

否

aclfvSearch

-

否

Profiling配置

aclprofInit

-

是

aclprofStart

-

是

aclprofStop

-

是

aclprofFinalize

-

是

aclprofModelSubscribe

-

是

aclprofModelUnSubscribe

-

是

aclprofGetOpDescSize

-

是

aclprofGetOpNum

-

是

aclprofGetOpTypeLen

-

是

aclprofGetOpType

-

是

aclprofGetOpNameLen

-

是

aclprofGetOpName

-

是

aclprofGetOpStart

-

是

aclprofGetOpEnd

-

是

aclprofGetOpDuration

-

是

aclprofGetModelId

-

是

数据类型转换及获取数据大小

aclDataTypeSize

-

是

aclFloat16ToFloat

-

否

aclFloatToFloat16

-

否

SoC扩展接口

aclextProcessAacpuTask

-

是

数据类型及其操作接口

aclError

-

是

aclDataType

-

是

aclFloat16

-

是

aclFormat

-

是

acldvppPixelFormat

-

否

acldvppStreamFormat

-

否

acldvppJpegFormat

-

否

aclrtContext

-

是

aclrtStream

-

是

aclrtEvent

-

否

aclrtEventStatus

-

否

aclrtRunMode

-

是

aclTransType

-

否

aclComputeType

-

否

aclfvSearchType

-

否

aclAappInputFormat

-

否

aclAappInfo

-

否

aclAappDims

-

否

aclmdlIODims

-

是

aclrtGroupAttr

-

否

aclprofAacoreMetrics

-

否

acldvppBorderType

-

否

aclmdlInputAappType

-

否

aclvencChannelDescParamType

-

否

aclmdlConfigAttr

-

否

aclMemType

-

否

aclmdlAAPP

-

否

-

aclmdlCreateAAPP

否

-

aclmdlSetAAPPCscParams

否

-

aclmdlSetAAPPInputFormat

否

-

aclmdlSetAAPPRbuvSwapSwitch

否

-

aclmdlSetAAPPAxSwapSwitch

否

-

aclmdlSetAAPPSrcImageSize

否

-

aclmdlSetAAPPScfParams

否

-

aclmdlSetAAPPCropParams

否

-

aclmdlSetAAPPPaddingParams

否

-

aclmdlSetAAPPDtcPixelMean

否

-

aclmdlSetAAPPDtcPixelMin

否

-

aclmdlSetAAPPPixelVarReci

否

-

aclmdlDestroyAAPP

否

aclopHandle

aclopCreateHandle

否

aclopDestroyHandle

否

aclDataBuffer

aclCreateDataBuffer

是

aclDestroyDataBuffer

是

aclGetDataBufferAddr

是

aclGetDataBufferSize

是

aclGetDataBufferSizeV2

否

aclUpdateDataBuffer

是

aclmdlDataset

aclmdlCreateDataset

是

aclmdlDestroyDataset

是

aclmdlAddDatasetBuffer

是

aclmdlGetDatasetNumBuffers

是

aclmdlGetDatasetBuffer

是

aclmdlSetDatasetTensorDesc

否

aclmdlDesc

aclmdlCreateDesc

是

aclmdlDestroyDesc

是

aclmdlGetDesc

是

aclmdlGetNumInputs

是

aclmdlGetNumOutputs

是

aclmdlGetInputSizeByIndex

是

aclmdlGetOutputSizeByIndex

是

aclmdlGetInputDims

是

aclmdlGetInputDimsV2

否

aclmdlGetOutputDims

是

aclmdlGetInputNameByIndex

是

aclmdlGetOutputNameByIndex

是

aclmdlGetInputFormat

是

aclmdlGetOutputFormat

是

aclmdlGetInputDataType

是

aclmdlGetOutputDataType

是

aclmdlGetInputIndexByName

是

aclmdlGetOutputIndexByName

是

aclmdlGetDynamicBatch

是

aclmdlGetDynamicHW

是

aclmdlGetCurOutputDims

否

aclmdlGetInputDynamicGearCount

否

aclmdlGetInputDynamicDims

否

aclmdlGetTensorRealName

否

aclTensorDesc

aclCreateTensorDesc

否

aclDestroyTensorDesc

否

aclGetTensorDescType

否

aclGetTensorDescFormat

否

aclGetTensorDescSize

否

aclGetTensorDescElementCount

否

aclGetTensorDescNumDims

否

aclGetTensorDescDim

否

aclGetTensorDescDimV2

否

aclGetTensorDescDimRange

否

aclSetTensorDescName

否

aclGetTensorDescName

否

aclTransTensorDescFormat

否

aclSetTensorStorageShape

否

aclSetTensorStorageFormat

否

aclSetTensorOriginFormat

否

aclSetTensorOriginShape

否

aclSetTensorShape

否

aclSetTensorFormat

否

aclSetTensorShapeRange

否

aclSetTensorDynamicInput

否

aclGetTensorDescByIndex

否

aclGetTensorDescAddress

否

aclSetTensorConst

否

aclSetTensorPlaceMent

否

aclopAttr

aclopCreateAttr

否

aclopDestroyAttr

否

aclopSetAttrBool

否

aclopSetAttrInt

否

clopSetAttrFloat

否

aclopSetAttrString

否

aclopSetAttrListBool

否

aclopSetAttrListInt

否

aclopSetAttrListFloat

否

aclopSetAttrListString

否

aclopSetAttrListListInt

否

acldvppChannelDesc

acldvppCreateChannelDesc

否

acldvppDestroyChannelDesc

否

acldvppGetChannelDescChannelId

否

acldvppSetChannelDescMode

否

acldvppPicDesc

acldvppCreatePicDesc

否

acldvppSetPicDesc系列接口

否

acldvppGetPicDesc系列接口

否

acldvppDestroyPicDesc

否

acldvppRoiConfig

acldvppCreateRoiConfig

否

acldvppSetRoiConfig系列接口

否

acldvppDestroyRoiConfig

否

acldvppResizeConfig

acldvppCreateResizeConfig

否

acldvppSetResizeConfigInterpolation

否

acldvppGetResizeConfigInterpolation

否

acldvppDestroyResizeConfig

否

acldvppJpegeConfig

acldvppCreateJpegeConfig

否

acldvppSetJpegeConfigLevel

否

acldvppGetJpegeConfigLevel

否

acldvppDestroyJpegeConfig

否

aclvdecChannelDesc

aclvdecCreateChannelDesc

否

aclvdecSetChannelDesc系列接口

否

aclvdecGetChannelDesc系列接口

否

aclvdecDestroyChannelDesc

否

acldvppStreamDesc

acldvppCreateStreamDesc

否

acldvppSetStreamDesc系列接口

否

acldvppGetStreamDesc系列接口

否

acldvppDestroyStreamDesc

否

aclvdecFrameConfig

aclvdecCreateFrameConfig

否

aclvdecDestroyFrameConfig

否

acldvppBatchPicDesc

acldvppCreateBatchPicDesc

否

acldvppGetPicDesc

否

acldvppDestroyBatchPicDesc

否

aclvencChannelDesc

aclvencCreateChannelDesc

否

aclvencSetChannelDesc系列接口

否

aclvencGetChannelDesc系列接口

否

aclvencSetChannelDescParam

否

aclvencGetChannelDescParam

否

aclvencDestroyChannelDesc

否

aclvencFrameConfig

aclvencCreateFrameConfig

否

aclvencSetFrameConfig系列接口

否

aclvencGetFrameConfig系列接口

否

aclvencDestroyFrameConfig

否

acldvppLutMap

acldvppCreateLutMap

否

acldvppDestroyLutMap

否

acldvppGetLutMapDims

否

acldvppGetLutMapData

否

acldvppBorderConfig

acldvppCreateBorderConfig

否

acldvppSetBorderConfig系列接口

否

acldvppGetBorderConfig系列接口

否

acldvppDestroyBorderConfig

否

acldvppHist

acldvppCreateHist

否

acldvppDestroyHist

否

acldvppGetHistDims

否

acldvppGetHistData

否

acldvppGetHistRetCode

否

acldvppClearHist

否

aclfvRepoRange

aclfvCreateRepoRange

否

aclfvDestroyRepoRange

否

aclfvFeatureInfo

aclfvCreateFeatureInfo

否

aclfvDestroyFeatureInfo

否

aclfvQueryTable

aclfvCreateQueryTable

否

aclfvDestroyQueryTable

否

aclfvSearchInput

aclfvCreateSearchInput

否

aclfvDestroySearchInput

否

aclfvSearchResult

aclfvCreateSearchResult

否

aclfvDestroySearchResult

否

aclfvInitPara

aclfvCreateInitPara

否

aclfvDestroyInitPara

否

aclfvSet1NTopNum

否

aclfvSetNMTopNum

否

aclprofConfig

aclprofCreateConfig

是

aclprofDestroyConfig

是

aclprofSubscribeConfig

aclprofCreateSubscribeConfig

是

aclprofDestroySubscribeConfig

是

aclmdlConfigHandle

aclmdlCreateConfigHandle

是

aclmdlDestroyConfigHandle

是

小型化工具使用差异

Caffe小型化工具差异

支持量化的算子不同

为了实现更低的带宽成本,_图像分析引擎_2小型化工具除了支持带权重层的量化,还支持对不带权重的层做激活量化。

  • 当前支持的带权重量化层为:全连接层(InnerProduct)、卷积层(Convolution和DepthwiseConv)、反卷积层(Deconvolution)。

  • 当前支持的不带权重的量化层为:PassThrough, Pooling, PSROIPooling, ROIPooling, SPP, Upsample, Eltwise, Slice, Concat, Softmax, ROIAlign, AbsVal, BNLL, CReLU, ELU, Exp, Interp, Log, LRN, Mvm, Nms, Normalize, Power, PReLU, Reduction, ReLU, Sigmoid, Sort, Threshold, Scale, BatchNorm, Bias, Reshape, ShuffleChannel, Crop, Axpy, Flatten, Permute, Tile, Split, ArgMax, Clip, Hswish, MVN, Reorg, TanH, MatMul, RReLU, ReLU6

支持量化的位宽不同

_图像分析引擎_2小型化工具支持更灵活的量化位宽控制。

  • 激活量化在Calibration和Retrain时可以配置8~16之间任意位宽,配置8时最终使用8bit部署,配置大于8时为高精度模式,最终使用16bit部署(一般推荐8或者12)

  • 权重量化在Calibration时可以配置4和8两种位宽量化,在Retrain时可以配置8一种量化位宽

对外接口和功能差异

_图像分析引擎_2小型化工具的接口和功能都和_图像分析引擎_1存在差异:

  • _图像分析引擎_2的Calibration把权重量化和激活量化分离为weights_quantize_model和activation_quantize_model两个接口;

  • _图像分析引擎_2的Calibration支持权重压缩成4bit,并且支持在权重量化后对BN层的参数进行更新;

  • 新增了对推理图的uninplace功能,在Sample中新增中间结果打印脚本,方便中间结果导出和精度比对;

  • _图像分析引擎_2小型化工具不支持auto_nuq和accuracy_based_auto_calibration功能。

量化生成件差异

_图像分析引擎_2小型化工具生成的量化参数单独储存在名为quant_param_record.txt或者quant_param_record.bin的文件中,deploy模型中仅储存不含量化层的INT定点模型。

Pytorch小型化工具差异

支持量化的算子不同

为了实现更低的带宽成本,_图像分析引擎_2小型化工具除了支持带权重层的量化,还支持对不带权重的层做激活量化。

类型

层名

约束

备注

支持权重及数据量化的层

torch.nn.Linear:全连接层

-

复用层(共用weight和bias参数)不支持量化。

torch.nn.Conv2d:卷积层

-

torch.nn.ConvTranspose2d:反卷积层

groups为1

支持数据量化的层

torch.nn.MaxPool2d, torch.nn.functional.max_pool2d

-

-

torch.nn.AdaptiveMaxPool2d,

torch.nn.functional.adaptive_max_pool2d

-

-

torch.nn.AvgPool2d, torch.nn.functional.avg_pool2d

-

-

torch.nn.AdaptiveAvgPool2d, torch.nn.functional.adaptive_avg_pool2d

-

-

+, torch.add

至少有一路输入类型是Tensor

需要手动引入amct_pytorch.custom_op.eltwise.eltwise模块中的EltwiseAdd算子,并将+或者torch.add替换为EltwiseAdd,详细参考《AMCT使用指南(PyTorch)》

*, torch.mul

至少有一路输入类型是Tensor

需要手动引入amct_pytorch.custom_op.eltwise.eltwise模块中的EltwiseMul算子,并将*或者torch.mul替换为EltwiseMul,方法同EltwiseAdd

/, torch.div

至少有一路输入类型是Tensor

需要手动引入amct_pytorch.custom_op.eltwise.eltwise模块中的EltwiseDiv算子,并将/或者torch.div替换为EltwiseDiv,方法同EltwiseAdd

torch.chunk

-

需要手动引入amct_pytorch.custom_op.split.split中的Split算子

torch.view

-

需要手动引入amct_pytorch.custom_op.reshape.reshape中的Reshape算子

torch.transpose

-

需要手动引入amct_pytorch.custom_op.transpose.transpose中的Transpose算子

torch.cat

-

需要手动引入amct_pytorch.custom_op.concat.concat模块中的Concat算子,并将torch.cat替换为Concat,详细参考《AMCT使用指南(PyTorch)》

torch.max(input)

-

需要手动引入hotwheels.amct_pytorch.custom_op.max.max中的Max算子

torch.max(input, other, *, out=None)

-

需要手动引入hotwheels.amct_pytorch.custom_op.max.max中的ReduceMax算子

torch.mean(input)

-

需要手动引入hotwheels.amct_pytorch.custom_op.mean.mean中的Mean算子

torch.mean(input, other, *, out=None)

-

需要手动引入hotwheels.amct_pytorch.custom_op.mean.mean中的ReduceMean算子

支持量化的位宽不同

_图像分析引擎_2小型化工具支持更灵活的量化位宽控制。

  • 激活量化在Calibration和Retrain时可以配置8~16之间任意位宽,配置8时最终使用8bit部署,配置大于8时为高精度模式,最终使用16bit部署(一般推荐8或者12)。

  • 权重量化在Calibration时可以配置4和8两种位宽量化,在Retrain时可以配置4和8两种量化位宽。

对外接口和功能差异

_图像分析引擎_2小型化工具的接口和功能都和_图像分析引擎_1存在差异:

  • _图像分析引擎_2的Calibration支持权重压缩成4bit,并且支持在权重量化后对BN层的参数进行更新;

    4bit量化需要用到更新BN的接口:

    update_bn_status(calibration_model, training=True)

  • _图像分析引擎_2在Calibration场景save_model接口函数原型为:

    save_model(modfied_onnx_file, record_file, save_path, calibration_torch_model)

    _图像分析引擎_1在Calibration场景save_model接口函数原型为:

    save_model(modfied_onnx_file, record_file, save_path)

  • _图像分析引擎_2小型化工具不支持nuq算法和accuracy_based_auto_calibration功能

量化生成件差异

_图像分析引擎_2小型化工具生成的量化参数单独储存在名为quant_param_record.txt的文件中,deploy模型中仅储存不含量化层的INT定点模型。

ATC使用差异

SVP ATC特性差异

表 1 SVP ATC特性差异

差异项

图像分析引擎1(NNN)

图像分析引擎2(SVP_NNN)

开源网络模型

Caffe、Onnx、Tensorflow, --framework

Caffe、Onnx

解析浮点模型

不支持

支持, --weight

支持量化校准

不支持

支持, --image_list

自定义算子

支持

支持

动态AAPP

支持

不支持

静态AAPP

支持改变图像尺寸(Crop/Resize/Padding)、色域转换(转换图像格式)、减均值/乘系数(改变图像像素值)

--insert_op_conf

不支持改变图像尺寸(Crop、Resize、Padding),支持色域转换(转换图像格式)、减均值/乘系数(改变图像像素值)

--insert_op_conf

动态分辨率

支持, --dynamic_image_size

不支持

动态Batch

支持,--dynamic_batch_size

支持, --batch_num

数据排布格式

支持NCHW、NHWC,--input_format

只支持NCHW

权重压缩

支持,--enable_compress_weight

不支持

权重量化位宽

支持8bit

支持4bit、8bit

指定网络节点输出

支持,配置层名,板端ACL接口返回层名,--out_nodes

支持,配置层名,板端ACL接口返回输出名,--out_nodes

算子自动调优

支持,--auto_tune_mode

不支持,离线编译生成*.om时默认性能优先。

Caffe扩展算子

支持

支持,算子类型和参数有差异。

SVP ATC 命令行差异

图像分析引擎1(NNN)

图像分析引擎2(SVP_NNN)

-

batch_num

auto_tune_mode

-

buffer_optimize

-

check_report

check_report

-

compile_mode

compress_weight_conf

-

core_type

-

-

cutoff_layer

-

custom_ops_lib

debug_dir

-

-

detection_out_accuracy

disable_reuse_memory

-

display_model_info

-

-

dump_data

dump_mode

dump_mode

dynamic_batch_size

-

dynamic_dims

-

dynamic_image_size

-

enable_compress_weight

-

enable_scope_fusion_passes

-

enable_single_stream

-

enable_small_channel

-

-

forward_quantization_option

framework

framework

fusion_switch_file

fusion_switch_file

h/help

help

-

generate_anchors_file

-

gfpq_param_file

-

image_data_bits

-

image_dcmp_mode

-

image_height

-

image_list

-

image_report_bit

-

image_report_name

-

image_report_type

-

image_width

input_format

input_format

input_fp16_nodes

-

input_shape

input_shape

input_shape_range

-

-

input_type

insert_op_conf

insert_op_conf

-

internal_stride

is_input_adjust_hw_layout

-

-

is_precheck

is_output_adjust_hw_layout

-

json

json

-

layer_fusion_enable

-

layer_m2m_enable

keep_dtype

-

log

-

-

log_level

-

low_score_threshold

-

max_roi_frame_cnt

mdl_bank_path

-

-

min_height

-

min_width

mode

mode

model

model

modify_mixlist

-

-

net_optimize_enable

-

nms_threshold

-

num_recurrent_sentences

om

om

-

online_model_type

op_bank_path

-

op_compiler_cache_dir

-

op_compiler_cache_mode

-

op_debug_level

-

op_name_map

-

op_precision_mode

-

op_select_implmode

-

optypelist_for_implmode

-

out_nodes

out_nodes

output

output

-

output_shape

output_type

output_type

precision_mode

-

-

recurrent_cont

-

recurrent_max_total_t

-

recurrent_tmax

save_original_model

save_original_model

shape_generalized_build_mode

-

singleop

-

soc_version

soc_version

-

use_class_id

-

version

weight

weight

-

weight_quant_per_channel

SVP ATC支持的算子规格差异

表 1 Caffe扩展算子差异

扩展算子

图像分析引擎1(NNN)

图像分析引擎2(SVP_NNN)

Reverse

支持

不支持

ROIPooling

支持

支持

PSROIPooling

支持

支持

Upsample(Yolo,NEAREST)

支持,可配置scale、stride

支持,可配置scale(等同于stride),默认值为2。

Normalize

支持

支持

Reorg

支持

支持

Proposal

支持

支持,参数有差异,参考RPN自定义算子配置。

ROIAlign

支持

不支持

ShuffleChannel

支持

支持

Yolo(Yolo/Detection/Region)

支持

不支持

PriorBox

支持

不支持

SpatialTransformer

支持

不支持

YoloV3DetectionOutput

支持

支持,层类型为DetectionOutput,参考RPN自定义算子配置。

YoloV2DetectionOutput

支持

支持,层类型为DetectionOutput,参考RPN自定义算子配置。

SSDDetectionOutput

支持

支持,层类型为DetectionOutput,参考RPN自定义算子配置。

FSRDetectionOutput

支持

支持,层类型为DetectionOutput,参考RPN自定义算子配置。

详细见《ATC工具使用指南》的“5 算子规格说明”。

仿真器差异

SVP ACL仿真器说明

在图像分析引擎2 SVP ACL中,提供仿真器Simulator,供用户在非上板的PC/服务器环境执行仿真任务。

仿真器与SVP ACL的SDK共用一套头文件定义,即一套相同的SVP ACL调用实现代码,通过链接仿真库的方法,可在仿真环境中使用编译器编译可执行程序或库,在仿真环境中执行_图像分析引擎_2仿真。

  • Simulator(Function)表示功能仿真,从功能一致性的角度去模拟硬件,速度较快;

  • Simulator(Instruction)表示指令仿真,从指令一致性的角度去模拟硬件,速度较慢。

功能仿真、指令仿真、板端环境三者的推理输出buffer内容保持完全一致。

仿真器的使用,请参考《MindCmd使用指南》“应用工程”章节。