性能╱带宽╱延时╱内存调优指南
前言
概述
本文为产品开发的程序员而写,目的是介绍在单板上进行性能、带宽、内存调优开发的相关配置及使用注意事项等内容。
 说明:
未有特殊说明,Hi3516DV500与Hi3519DV500内容完全一致。
未有特殊说明,Hi3516CV610-10B/00S/20S/00G/20G内容完全一致。
产品版本
与本文档相对应的产品版本如下。
产品名称
|
产品版本
|
|---|
Hi3519D
|
V500
|
Hi3516D
|
V500
|
Hi3516C
|
V608
|
Hi3516C
|
V610
|
Hi3511C
|
V100
|
读者对象
本文档(本指南)主要适用于以下工程师:
修改记录
版本
|
修订日期
|
修订说明
|
|---|
00B01
|
2026-06-30
|
第1次临时版本发布。
|
性能调优
性能优化的通用方法一般有:硬件加速、优化perf热点函数、通过ftrace分析调度阻塞、优化高负载线程。
性能优化的第一步应该是找出需要优化的重点对象:top观测到的大线程、perf火焰图指示的热点函数、ftrace追踪图指示的受阻塞函数、频繁的无效调度、频繁的动态申请资源、碎片化操作过多、多级节点串行处理等。第二步再打开重点对象的内部流程,进行有针对性的优化。
性能优化方法有:硬件加速、绑核分摊负载、线程优先级调整、批处理、并行处理、大量数据CPU读写采用cache、大数据量memcpy DMA化、减少无效调度、动态申请资源改为静态、减少无效打印、关闭冗余功能等。
性能优化分析工具:perf、ftrace、top、proc、bspddrs、仿真器,业务流程需人工分析。
本章节提供了一些SDK系统性能相关的调度策略,客户需要根据业务实际情况进行调节测试。
操作系统调度
操作系统的默认调度策略具有普遍适用性,不建议轻易尝试修改系统的默认调度策略,有性能问题的特定场景可尝试修改调整,调整后的配置只适用于验证过的特定场景,不适用于直接移植到其它未验证过的场景。
中断绑核
系统中的中断默认都没有绑定CPU亲和性,因此中断默认都会报到CPU0上,如果CPU0的中断数量太多影响到了业务性能、帧率等情况,可以尝试调整部分中断号的CPU亲和性,把一部分中断号绑定到其它CPU上,减轻CPU0的中断压力。
查看中断信息:cat /proc/interrupts
查看中断亲和性:cat /proc/irq/中断号/smp_affinity
修改中断亲和性:echo 中断位掩码 > /proc/irq/中断号/smp_affinity
针对中断绑定CPU的操作有如下建议:
- 绑定CPU的操作要在业务运行之前进行,不要在业务运行过程中动态切换绑定;
- 除VICAP之外,一般建议同一个模块的多个核要绑在同一个CPU上;
- 把中断比较多的模块识别出来绑定到其它CPU上,比如网络的中断若比较多,可以把它跟媒体业务分开。
进程绑核
当某个进程需要较高的运行效率时,可以考虑将其绑定到单独的核上运行,以减小由于在不同的核上调度造成的开销。把某个进程/线程绑定到特定的CPU核上后,该进程就会一直在此核上运行,不会再被操作系统调度到其他核上。但绑定的这个核上还是可能会被调度运行其他应用程序的。
进程绑核相关接口:
int sched_setaffinity(pid_t pid, size_t cpusetsize, cpu_set_t *mask);
int sched_getaffinity(pid_t pid, size_t cpusetsize, cpu_set_t *mask);
线程调度和绑核
当系统中某个业务线程的实时性要求较高,出现调度不及时影响帧率等性能问题时,可以尝试调整单个线程的优先级、线程调度策略,或者预留一个CPU给某个线程独享,其它非及时性线程与这个实时性线程分开绑定到不同CPU。
-
线程调度策略:线程有三种调度策略,如下
- SCHED_OTHER:分时调度策略。不支持线程优先级
- SCHED_FIFO:实时调度策略,先到先服务。一旦占用CPU则一直运行,直到有更高优先级任务到达或者自己放弃。支持线程优先级。
- SCHED_RR:实时调度策略,时间片轮转。支持线程优先级。
线程调度策略相关接口:
int pthread_attr_setschedpolicy(pthread_attr_t *attr, int policy);
int pthread_attr_getschedpolicy(const pthread_attr_t *attr, int *policy);
-
线程调度优先级:线程调度优先级支持从1到99,数值越大优先级越高,越先被调度。
线程优先级相关接口:
int pthread_attr_setschedparam(pthread_attr_t *attr, const struct sched_param *param);
int pthread_attr_getschedparam(pthread_attr_t *attr, struct sched_param *param);
int sched_get_priority_max(int policy);
int sched_get_priority_min(int policy);
-
线程绑核:操作系统的默认线程调度机制是没有问题的,线程能被所有核调度到。但是,当某个线程需要较高的运行效率时,就有必要考虑将其绑定到单独的核上运行,以减小由于在不同的核上调度造成的开销。把某个线程绑定到特定的CPU核上后,该线程就会一直在此核上运行,不会再被操作系统调度到其他核上。但绑定的这个核上还是可能会被调度运行其他线程的。
线程绑核相关接口:
int pthread_setaffinity_np(pthread_t thread, size_t cpusetsize, const cpu_set_t *cpuset);
int pthread_getaffinity_np(pthread_t thread, size_t cpusetsize, cpu_set_t *cpuset);
-
线程休眠时间对CPU也有影响,线程休眠时间太短、频繁调度次数过多会导致CPU占用升高,线程数量越多影响越大。因此需要根据业务需要设置合理的休眠时间,建议优先使用wait和wakeup机制,条件满足时才唤醒线程运行。
说明:
- 调试时可以使用chrt命令临时查看或修改线程调度策略和优先级:
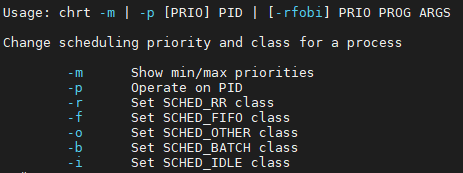
例:
查看线程调度策略和优先级:chrt -p <pid>
修改线程调度策略和优先级:chrt -r -p <priority> <pid>
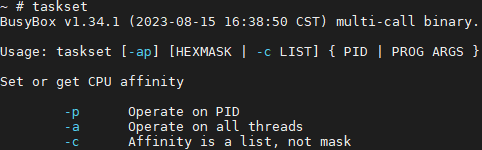
例:
查看线程绑核命令:taskset -p <pid>
修改线程绑核命令:taskset -p <cpu_set> <pid>
<cpu_set>:设置值为1指绑到CPU0上,2指绑到CPU1上,3指同时绑到CPU0和CPU1上随机调度。
线程切换
-
线程切换性能开销:若线程频繁切换会导致系统底噪开销过大,2*A55@1.6GHz性能开销数据如表1所示。
表 1 线程切换性能开销
上下文切换次数
|
单次切换耗时
|
CPU占用(双核)
|
|---|
1
|
17μs
|
NA
|
10000
|
NA
|
8.5%
|
同时由于线程上下文切换还会增大cache miss,进一步影响CPU指令执行效率,实际对性能影响更大。 因此在一些场景出现finish_task_finish成为最大的热点函数,说明线程切换的底噪成为性能瓶颈。
-
线程切换统计工具与方法:可以通过vmstat、pidstat来查看线程上下文切换次数信息,线程主动切换主要是因为线程等待的资源没有满足,而导致线程主动挂起让出CPU,如等待锁、信号量、主动sleep等操作;线程被动切换通常由于更高优先级线程ready后重新调度其他任务运行,当前任务被动让出CPU。过度的主动切换反映了系统的资源竞争激烈,过度的被动切换反映了系统的线程数量过大。
- 减少线程无效切换次数优化思路:线程个数并不能直接反应调度的底噪,重点在于减少不必要的线程切换次数,即尽可能提升线程运行时间与切换时间的比例,建议:
- 优先优化切换次数多的线程
- 合并任务,减少线程(同一进程内存在多个对时间不敏感的任务,可以将其合并成一个任务,定期执行)
- 频繁的轮询模式改成事件驱动,或者事件驱动与查询结合
- 减少锁等待,A线程执行完唤醒B线程执行这类情况可合并线程取消锁
HZ
SDK版本配置的Linux内核HZ默认是100,对应一个jiffies为10ms。当系统需要更高精度的线程、定时器调度要求时,可以把HZ设大,但产生的影响是CPU占用会上升。
方法是修改内核宏CONFIG_HZ的定义值。
大数据量拷贝
大数据量拷贝尽量避免使用CPU,尽量使用DMA代替。如果一定要使用CPU,cache方式比非cache方式拷贝效率高。但要注意,如果存在CPU和其它硬件IP都访问同一块buffer且CPU以cache方式访问,则CPU访问前后必须配合正确的刷cache操作,否则CPU和其它外设访问到的数据有可能是不一致的。
NPU/IVE硬件加速
智能处理中的一些纯软件计算可以使用NPU/IVE硬件加速替换CPU,比如:
- 检测网后处理(Filter/Sort/NMS)可使用NPU的DetectionOutput层硬化加速。
- IVE算子取代部分CPU算子,比如Resize/GMM2/Dilate/Erode/KCF等。
模块替代
- 有缩放能力的模块有VGS/IVE/NPU,媒体缩放建议使用VGS,智能缩放建议使用IVE和NPU。如果某个模块业务压力过大性能不足时,也可考虑使用其它业务压力小的模块代替。
- 有DMA能力的模块有IVE/VGS/TDE,可根据业务压力均衡调度。大数据量拷贝尽量使用DMA代替CPU拷贝。
调整USB中断间隔
USB 协议通过中断间隔参数来控制设备向主机请求数据传输的频率。对于USB设备,合理调整中断间隔能够显著影响传输性能。
- 较小的中断间隔:更频繁的数据请求,降低延迟,提升实时性,但增加CPU开销。
- 较大的中断间隔:减少中断频率,降低CPU占用率,但会增加延迟,降低峰值吞吐量。
在内核USB Device模式下,Hi3511CV100的USB控制器设置USB中断默认间隔为无间隔,此时传输速率最高,但相应增加批量数据传输时的CPU占用率10%~20%。
若无需高速率传输且希望减少CPU占用,可采用以下两种方法之一设置中断间隔。
-
修改内核代码。进入到版本路径下third_party/linux/linux-5.10.y/drivers/usb/hiusbc/hiusbc_core.h文件,修改宏定义:
#define HIUSBC_IMODI_NO_INTERVAL 0
默认值为0,即无中断间隔。单位为250ns,例如值设置为4000,则中断间隔为1ms=4000 * 250ns。
修改完成后重新编译内核。
-
开启内核debugfs。
-
进入内核menuconfig的如下路径,确认以下驱动配置选上。
Kernel hacking --->
    Generic Kernel Debugging Instruments --->
        [*] Debug Filesystem
-
编译内核,编译方法参照:bsp/readme_cn.txt中“单独编译kernel image”步骤流程;
-
启动内核后,执行以下命令。
修改中断间隔,如将中断间隔调整为1ms(4000 * 250ns = 1ms),参考如下命令。(中断间隔默认为0)
mount -t debugfs none /sys/kernel/debug
echo 4000 > /sys/kernel/debug/usb/10500000.usbc/imodi
查看中断间隔,参考如下命令。
cat /sys/kernel/debug/usb/10500000.usbc/imodi
 注意:
- 以上步骤仅适用于Hi3511CV100内核USB Device模式。
- 命令中的"10500000.usbc"对应USB Port0口,USB Port1口对应"10540000.usbc",请根据实际需求调整命令。(以Hi3511CV100 demo板usb3.0_0为例,后缀_0表示Port 0口)
- imodi写入单位为250ns,最大值为4000,即间隔最大为1ms,最小值为0,即无间隔。
媒体驱动调度
媒体驱动内部为了兼顾性能、延时、内存等多方面均衡,会默认给出一个通用的调度策略。但是某些产品可能对某个指标要求比较高(比如低延时、帧率等),其它指标(比如CPU、内存等)受到的影响可以接受,此时可尝试调整媒体驱动开放的调度策略来达到某个指标调优的目的。
VI
说明:
相关接口/参数具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频输入”章节。
Hi3511CV100不支持以下措施。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
设置vi设备的中断亲和性
|
- ss_mpi_vi_set_dev_irq_affinity
- ss_mpi_vi_get_dev_irq_affinity
|
多sensor接入的非拼接场景,把不同的vi设备绑定到不同中断号上,再结合不同中断号绑定到不同CPU核,可以使VI设备中断在不同CPU核上并行处理,提高中断处理及时性。
|
无
|
- 接口参数irq_index只是中断号索引,并不是实际的中断号,实际中断号需要通过cat/proc/interrupts查看。
- 必须结合中断绑核,查看本文“中断绑核”章节
|
vi dev attr2:irq_affinity
|
VENC
说明:
相关接口/参数具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频编码”章节。
Hi3511CV100不支持JPEG编码。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
JPEG批量抠图编码
|
ss_mpi_venc_send_frame_batch_crop
|
智能抓拍人脸场景通常需要从一张大图里抠出多个目标人脸进行jpeg抓图编码,且每个目标人脸分辨率不一致。
- 传统方式每个目标都需要进行stop_chn->set_chn_attr->start_chn->send_frame->get_stream->release_stream操作,帧率m,每帧n个目标总共需要调mxnx6次mpi接口。
- 本接口支持批量抠图编码一次性送入1张大图和多个目标框抠图的功能,帧率m,每帧n个目标总共只需调用mx3次mpi接口。(send_frame_batch_crop->get_stream->release_stream)。
|
无
|
-
|
batch_crop
|
ISP
说明:
Hi3511CV100不支持ISP。
相关接口/参数具体使用方式和注意事项参见《ISP 开发参考》。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
控制中断更新统计信息
|
ss_mpi_isp_set_stats_cfg:update
|
update中相应的bit,可用来关掉中断服务程序中相关统计信息的更新以达到降低CPU占用率
|
不更新统计信息可以降CPU,但会影响对应算法的PQ效果
|
-
|
-
|
控制软件读取统计信息间隔
|
ss_mpi_isp_set_ctrl_param:stat_interval
|
isp读取统计信息更新频率。默认每帧更新
|
增大间隔可以降CPU,但可能会影响PQ效果的收敛速度
|
一般帧率场景不建议调大。
|
module/control param: stat_intvl
|
控制AE算法运行间隔
|
ss_mpi_isp_set_exposure_attr:ae_run_interval
|
AE算法运行间隔,以帧为单位。默认每帧运行
|
增大运行间隔可以降CPU,但会影响AE效果。
|
一般帧率场景不建议调大。
|
Ae_info:ae_inter
|
控制AWB算法运行间隔
|
ss_mpi_isp_set_wb_attr:awb_run_interval
|
AWB算法运行间隔,以帧为单位。默认每2帧运行一次
|
增大运行间隔可以降CPU,但会影响AWB效果。
|
一般帧率场景不建议调大。
|
-
|
关闭ISP各类算法
|
ss_mpi_isp_set_module_ctrl中的各算法bit位。
|
通过关闭算法使能开关,降低系统功耗、CPU占用。
|
算法关闭会影响图像质量指标,部分基础算法关闭可以会出现图像异常。
|
需要经过专业调测来选择可关闭的算法。
|
各算法的使能proc
|
AIISP
说明:
Hi3511CV100不支持AIISP。
相关接口/参数具体使用方式和注意事项参见《AIISP 开发参考》。
Hi3516CV610不支持设置preempted_en = 1。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
aiisp开启被抢占
|
- ss_mpi_aibnr_load_model
- ss_mpi_aidrc_load_model
- ss_mpi_aibnr_load_model
|
加载模型时,设置加载参数preempted_en = 1,则AIISP做推理任务时,允许其他优先级比1高的推理任务打断AIISP的任务。
|
AIISP的推理任务频繁被打断可能会影响性能,导致丢帧。
|
其他推理任务要满足以下几点才能抢占AIISP任务:
- AIISP加载模型时开启被抢占功能;
- 其他推理任务优先级为0或者1
其他推理任务开启抢占功能。
|
aiisp中的preempted_en
|
aiisp线程绑定cpu
|
- ss_mpi_aibnr_set_thread_attr
- ss_mpi_aidrc_set_thread_attr
- ss_mpi_ai3dnr_set_thread_attr
|
设置AIISP内部线程将aiisp线程绑定到指定的CPU核上
|
绑定后,AIISP内部的线程只能在绑定的CPU上运行
|
-
|
-
|
SVP
说明:
Hi3511CV100不支持。
相关接口/参数具体使用方式和注意事项参见智能的《应用开发指南》。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
NPU多Batch
|
svp_acl_mdl_set_dynamic_batch_size
|
一次下发多帧数据,硬件一起处理
|
需要增加多帧内存
|
-
|
-
|
NPU异步推理
|
svp_acl_mdl_execute_async
|
异步推理可以一次下发多帧不阻塞线程,等需要结果的时候再同步获取
|
-
|
-
|
-
|
NPU优先级
|
svp_acl_mdl_set_model_config
|
优先级可以保障高优先级任务的优先执行;优先级抢占可以较高程度保障高优先级实时性
|
优先级抢占对整体NPU性能有微弱的开销
|
-
|
prior:优先级
preempt_en:抢占使能
preempted_en:被抢占使能
|
AUDIO
说明:
Hi3511CV100不支持。
相关接口/参数具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"音频”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
调整TalkVQEV2 AEC模块block_num参数
|
- ss_mpi_ai_set_talk_vqe_v2_attr
- ss_mpi_ai_get_talk_vqe_v2_attr
|
在使用TalkVQEV2 AEC功能的场景下,增大该参数能有效应对更大延迟的回声信号。
|
无
|
会增加CPU和DDR内存开销。
|
ai proc信息中ai chn vqe status的block_num
|
设置AI通道的工作模式。
|
- ss_mpi_ai_set_chn_attr
- ss_mpi_ai_get_chn_attr
|
在没有同时开启AI VQE算法和开启AI-AENC或AI-AO系统绑定的场景下,可以调用该接口将AI通道的工作模式设置为OT_AI_CHN_MODE_FAST,可以关闭ot_ai_get线程,节省线程调度开销。
|
无
|
会节省CPU开销。
|
ai proc信息中ai chn status的mode
|
调整AI设备的采样率和VQE算法的工作采样率
|
- ss_mpi_ai_set_pub_attr
- ss_mpi_ai_get_pub_attr
- ss_mpi_ai_set_talk_vqe_attr
- ss_mpi_ai_get_talk_vqe_attr
- ss_mpi_ai_set_record_vqe_attr
- ss_mpi_ai_get_record_vqe_attr
- ss_mpi_ai_set_talk_vqe_v2_attr
- ss_mpi_ai_get_talk_vqe_v2_attr
|
尽量将AI设备的采样率和VQE算法的工作采样率设置为一样,可以节省算法内部的重采样开销。
|
无
|
会节省CPU开销和DDR内存开销。
|
ai proc信息中ai dev attr的sample_rate,ai proc信息中ai chn vqe status的rate
|
不使能AO设备,关闭VQE的AEC功能模块
|
- ss_mpi_ao_set_pub_attr
- ss_mpi_ao_get_pub_attr
- ss_mpi_ai_set_talk_vqe_attr
- ss_mpi_ai_get_talk_vqe_attr
- ss_mpi_ai_set_talk_vqe_v2_attr
- ss_mpi_ai_get_talk_vqe_v2_attr
|
在单纯拾音的场景下,可以不使能AO设备,以及关闭VQE算法的AEC功能模块,可以节省AO设备开启带来的中断开销和AEC功能带来的开销
|
无
|
会节省CPU和DDR内存开销。
|
ao proc信息中的ao dev attr,ai proc信息中的ai chn vqe status
|
调整VQE开启的功能模块
|
- ss_mpi_ai_set_talk_vqe_attr
- ss_mpi_ai_get_talk_vqe_attr
- ss_mpi_ai_set_record_vqe_attr
- ss_mpi_ai_get_record_vqe_attr
- ss_mpi_ai_set_talk_vqe_v2_attr
- ss_mpi_ai_get_talk_vqe_v2_attr
|
需要根据实际使用场景的需要和实测效果来开启必要的功能模块,模块开启越少,CPU开销越少。
|
无
|
会节省CPU和DDR内存开销。
|
ai proc信息中的ai chn vqe status
|
音频算法建议:
- 纯拾音_高音质_场景:关AEC+开AGC+开ANR+开EQ+开HPF。
- 纯拾音_经济_场景:关AEC+开AGC+开ANR+关EQ+关HPF。
- 对讲_高音质_场景:开AEC+开AGC+开ANR+开EQ+开HPF。
- 对讲_经济_场景:开AEC+开AGC+开ANR+关EQ+关HPF。
说明:AEC场景上只需在对讲通话的时间段内打开即可,纯拾音场景不需要,以上5种算法里AEC占CPU开销最多。
VGS
说明:
相关接口/参数具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频图形子系统”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
使用批处理,即多个task组成1个job。尽量避免1个task组成1个job
|
- ss_mpi_vgs_begin_job
- ss_mpi_vgs_add_xxx_task
- ss_mpi_vgs_end_job
|
不同功能的task支持组成1个job
|
无
|
默认task上限100个,可在load脚本通过VGS的模块参数g_max_vgs_task修改上限,取值范围[20, 400]
|
vgs proc信息中的module param
|
IVE
说明:
Hi3511CV100不支持。
具体使用方式和注意事项参见IVE的《IVE API参考》。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
多Batch
|
- ss_mpi_ive_persp_trans
- ss_mpi_ive_resize
|
一次下发多帧/多ROI数据,硬件一起处理
|
需要增加多帧/多ROI内存
|
-
|
-
|
其它
1.抠图操作
若需要从整图中抠出某个ROI区域给下一级处理,可以不需要把此ROI抠出来,利用以下方法,减小搬运操作。
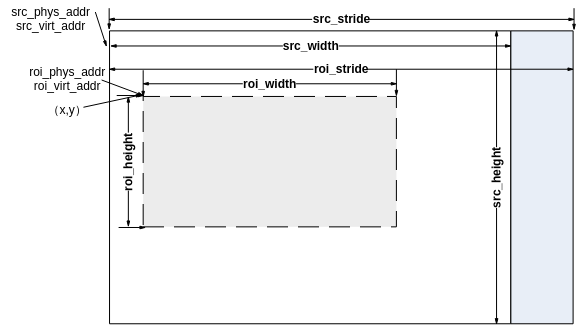
以每个像素占用一字节为例:
roi_phys_addr = src_phys_addr + (y * src_stride) + x
roi_virt_addr = src_virt_addr + (y * src_stride) + x
roi_stride = src_stride
带宽调优
综述
带宽调优主要是降低单位时间内DDR的载入载出数据量和访问DDR的命令次数。主要优化方向有:
- 能用在线模式就不要使用离线模式,在线、离线与场景规格有关。在线模式数据不需要写出DDR,可节省带宽。
- 能用压缩就不要使用非压缩。压缩之后数据量会减少,可节省带宽。
- CPU能用cache方式访问DDR就不要使用非cache方式。相同的数据量读写,CPU使用cache方式访问DDR的命令次数比非cache方式少很多。注意,如果存在CPU和其它硬件IP都访问同一块buffer且CPU以cache方式访问,则CPU访问前后必须配合正确的刷cache操作,否则CPU和其它外设访问到的数据有可能是不一致的
- 所有调优措施都使用之后,如果带宽依然达不到要求,可能就要从产品的系统业务层面做一些取舍,比如降低帧率、降低raw数据位宽、降低图像分辨率、裁剪一些非关键的业务等等。
VI
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》“视频输入”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
pipe设置raw压缩输出
|
ss_mpi_vi_set_pipe_attr:pixel_format和compress_mode
|
压缩比不压缩情况要更节省内存和带宽
|
-
|
是否支持压缩、支持哪种格式压缩与具体功能有关,请参考开发手册。
Hi3511CV100不支持。
|
vi pipe attr1:
compress_mode
|
chn输出设置压缩
|
ss_mpi_vi_set_chn_attr:video_format和compress_mode
|
压缩比不压缩情况要更节省内存和带宽
|
-
|
是否支持压缩、支持哪种格式压缩与具体功能有关,请参考开发手册。如果有vi通道后处理(比如dis、缩放等功能),压缩格式配置错误时vi会自适应改为非压缩。
DIS仅支持tile压缩:video_format配置为OT_VIDEO_FORMAT_TILE_32x4,compress_mode配置OT_COMPRESS_MODE_TILE。
|
- 接口配置的压缩格式vi phys chn attr:
compress_mode
- 实际输出的压缩格式:vi chn out frame info的compress_mode
|
3DNR压缩
|
ss_mpi_vi_set_pipe_3dnr_attr
|
3DNR的参考帧压缩,节省带宽
|
-
|
首先要开启3DNR,压缩格式仅支持OT_COMPRESS_MODE_FRAME。
Hi3511CV100不支持。
|
vi pipe 3dnr attr: enable,nr_type
|
使用FMU的direct模式
或者vi-vpss在线模式
|
ss_mpi_vi_set_chn_fmu_mode
|
FMU的direct模式数据不需要把数据写出DDR,节省带宽和内存
|
-
|
仅Hi3519DV500/Hi3516DV500支持FMU。
有场景使用限制,参见《MPP 媒体处理软件 V6.0 FAQ》的“FMU”章节
|
vi vpss mode & vi aiisp mode & fmu mode:
fmu_mode
|
VPSS
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频处理子系统”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
使用FMU的direct模式
|
ss_mpi_vpss_set_chn_fmu_mode
|
FMU的direct模式数据不需要写出DDR
|
-
|
仅Hi3519DV500/Hi3516DV500支持FMU。
有场景使用限制,参见《MPP 媒体处理软件 V6.0 FAQ》的“FMU“章节
|
vpss chn fmu info: fmu_mode
|
通道输出YUV压缩
|
ss_mpi_vpss_set_chn_attr:compress_mode
|
比不压缩情况要更节省带宽。
|
-
|
Hi3519DV500/Hi3516DV500/Hi3511CV100支持CHN0、CHN1输出YUV压缩。
Hi3516CV610支持CHN0输出YUV压缩。
需要看通道的下一级是否支持压缩
|
vpss chn output status:cmp_mode
|
3DNR压缩
|
ss_mpi_vpss_set_grp_3dnr_attr:compress_mode
|
比不压缩情况要更节省带宽
|
-
|
Hi3516CV610的3DNR功能固定在VI模块。
Hi3511CV100不支持3DNR功能。
首先要开启3DNR,压缩格式仅支持OT_COMPRESS_MODE_FRAME
|
vpss grp 3dnr attr:ref_cmp
|
VENC
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频编码”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
使用normal_p模式或者I帧模式
|
ss_mpi_venc_create_chn:gop_mode
|
normal_p模式只有一个参考帧载入载出,I帧模式无重构帧写出,也无参考帧写入,其它模式有2个参考帧载入载出
|
图像效果不如smart_p和dual_p
|
-
|
venc chn attr 1 : gop_mode
|
码流获取cache方式
|
ss_mpi_venc_set_mod_param:buf_cache
|
以cache方式拷贝码流
|
在中断里有刷cache操作,增加中断时间
|
每帧码流数据量很小时不建议开启,可能刷cache性能会大过copy性能
|
[VENC]:module param:venc_buf_cache
|
REGION
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"区域管理”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
OSD使用CLUT2/CLUT4
|
ss_mpi_rgn_set_attr
ss_mpi_rgn_set_bmp:pixel_format使用OT_PIXEL_FORMAT_ARGB_CLUT2、OT_PIXEL_FORMAT_ARGB_CLUT2_2x2、OT_PIXEL_FORMAT_ARGB_CLUT2_4x4、OT_PIXEL_FORMAT_ARGB_CLUT4、OT_PIXEL_FORMAT_ARGB_CLUT4_2x2、OT_PIXEL_FORMAT_ARGB_CLUT4_4x4
|
CLUT格式是一个颜色查找表,保存颜色格式为ARGB8888。
CLUT2/CLUT4格式位图更省内存和带宽
|
颜色数量有限,CLUT2可以保存4种颜色,CLUT4可以保存16种颜色。
|
Hi3519DV500/Hi3516DV500/Hi3511CV100不支持OT_PIXEL_FORMAT_ARGB_CLUT2_2x2、OT_PIXEL_FORMAT_ARGB_CLUT2_4x4、OT_PIXEL_FORMAT_ARGB_CLUT4_2x2和OT_PIXEL_FORMAT_ARGB_CLUT4_4x4格式。
|
region status of overlay:pixel_format
|
AIISP
说明:
Hi3511CV100不支持AIISP。
具体使用方式和注意事项参见《AIISP开发参考》"AIBNR API参考”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
aibnr关闭blend功能
|
ss_mpi_aibnr_set_attr:blend
|
blend功能开启时,会增加一帧读带宽,能够使效果更自然,切换更平滑。关闭时,可以节省一帧读带宽。
|
影响PQ效果,可能会导致PQ效果不够自然,切换不够平滑。
|
-
|
status:
blend:N 表示关闭
|
SVP
说明:
Hi3511CV100不支持。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
模型做A8W4或A4W4量化
|
AMCT的接口auto_mixed_precision_search
|
在指定压缩率模式下,自动生成混合精度量化策略。
|
- 读写带宽
- workbuf大小
- om模型大小
|
-
|
-
|
调整workbuf行字节对齐数
|
ATC 转换模型配置参数 --internal_stride
|
根据DDR的类型,设置workbuf的读写对齐字节数,可提升DDR的读写效率
|
- 读写带宽
- workbuf大小
|
-
|
-
|
调整网络的输入输出数据类型
|
ATC 转换模型配置参数--input_type /
--output_type
|
可以指定输入输出的数据类型(FP16, FP32, INT16, INT8, S16, S8, U16, U8, UINT16, UINT8)
|
- 输入输出读写带宽
- 输入输出内存大小
|
可能会影响网络的精度
|
-
|
延时调优
媒体通路的延时调优主要围绕“在线、低延时、提前输出”等思路。
VI
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》“视频输入”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
全在线模式
|
ss_mpi_sys_set_vi_vpss_mode:OT_VI_ONLINE_VPSS_ONLINE
|
vicap-viproc-vpss通路使用全在线模式,延时最低
|
-
|
SOC仅单路场景支持全在线模式,且不支持DIS/LDC/RTT/VI通道后处理等功能。
Hi3511CV100通路为vi-vpss。
|
[VI]的vi_vpss_mode
|
VICAP开启LowDelay
|
ss_mpi_vi_set_pipe_low_delay
|
在VICAP的LowDelay中断里把未采集完的图像提前发给VIPROC
|
|
- VICAP和VIPROC之间使用offline模式有效
- 多pipe场景不建议开启,否则会拖慢viproc性能
- Hi3511CV100不支持VICAP开启LowDelay,但可以通过开启Early/Early_end机制降低延时。
|
vi pipe low delay attr:enable
|
VIPROC开启LowDelay
|
ss_mpi_vi_set_chn_low_delay
|
在VIPROC的LowDelay中断里把处理完的图像提前发给下一级
|
- VIPROC中断数翻倍,CPU占用会增多
- 如果下一级不支持低延时功能,则行号不能设置太小,否则容易出现花屏
|
- VICAP和VIPROC之间使用offline模式有效
- Hi3511CV100不支持
|
vi chn low delay attr:enable
|
使用FMU的direct模式
|
ss_mpi_vi_set_chn_fmu_mode
|
FMU的direct模式延时低
|
-
|
仅Hi3519DV500/Hi3516DV500支持FMU。
有场景使用限制,参见《MPP 媒体处理软件 V6.0 FAQ》的“FMU”章节
|
vi vpss mode & vi aiisp mode & fmu mode:
fmu_mode
|
使用3DNR的NORM模式
|
ss_mpi_vi_set_pipe_param
|
3DNR的NORM模式下,图像内容输出无延时,ADVANCE模式下图像内容延时一帧输出
|
ADVANCE模式降噪效果好
|
仅Hi3516CV610生效
|
vi pipe param
nr_effect_mode
|
VPSS
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频处理子系统”章节。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
VPSS在线模式使用的帧中断属性
|
ss_mpi_vpss_set_grp_frame_interrupt_attr
|
- OT_FRAME_INTERRUPT_START模式,VPSS在下一帧帧起始时发送图像
- OT_FRAME_INTERRUPT_EARLY模式,VPSS在延时中断上报时发送图像
- OT_FRAME_INTERRUPT_EARLY_END模式,VPSS在帧完成中断上报时发送图像
|
- EARLY模式稳定性稍差,如果后端接收模块处理速度比VPSS处理要快,可能会出现花屏、解压错误等问题
- EARLY_END模式中断数量增多,CPU占用会增多
|
Hi3511CV100仅支持OT_FRAME_INTERRUPT_START和OT_FRAME_INTERRUPT_EARLY_END
|
frame interrupt attr: int_type
|
ss_mpi_vpss_set_chn_low_delay
|
ss_mpi_vpss_set_chn_low_delay
|
vpss通道低延时
|
- VPSS中断数翻倍,CPU占用会增多
- 如果下一级不支持低延时功能,则行号不能设置太小,否则容易出现花屏
|
-
|
vpss chn low delay attr:enable
|
使用FMU的direct模式
|
ss_mpi_sys_set_vi_chn_fmu_mode
|
FMU的direct模式延时低
|
-
|
仅Hi3519DV500/Hi3516DV500支持FMU。
有场景使用限制,参见《MPP 媒体处理软件 V6.0 FAQ》的“FMU”章节
|
vpss chn fmu info:
fmu_mode
|
VENC
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频编码”章节。
Hi3511CV100不支持JPEG编码。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
关闭重编功能
|
ss_mpi_venc_set_rc_param:max_reencode_times
|
默认2,修改为0则不支持任何重编(超大帧重编、超大码率重编)。
|
可能会出现超大帧、码率超预期等情况
|
-
|
[RC]:max_reencode_times
|
关闭去呼吸效应功能
|
ss_mpi_venc_set_debreath_effect
|
默认关闭
|
可能有呼吸效应问题
|
-
|
rc debreath_effect info的enable
|
关闭质量均衡功能
|
ss_mpi_venc_set_quality_balance
|
默认关闭
|
-
|
-
|
[H264E]或[H265E]:
quality balance info 1的enable
|
H264或H265:slice中断
|
ss_mpi_venc_set_slice_split:slice_output_en
|
slice中断,默认关闭
|
会导致系统中断数增多,CPU压力增大
|
需要划分slice
|
[H264E]或[H265E]:
syntax info1的slice_split_en、split_mode、slice_size、slice_output_en
|
JPEG:ecs中断
|
ss_mpi_venc_set_jpeg_param:mcu_per_ecs和ecs_output_en
|
ecs中断,默认关闭
|
会导致系统中断数增多,CPU压力增大
|
需要划分ecs
|
[JPEGE]:param的mcu_per_ecs、 ecs_output_en
|
VDEC
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频解码”章节。
Hi3516CV610不支持VDEC。
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
帧模式
|
ss_mpi_vdec_create_chn:OT_VDEC_SEND_MODE_FRAME
|
帧模式发送码流
|
必须一次发送完整一帧码流,否则解码会出错
|
-
|
chn comm attr & params:send_mode
|
解码顺序输出
|
ss_mpi_vdec_set_chn_param:OT_VIDEO_OUT_ORDER_DEC
|
解码顺序输出
|
有B帧的码流解码顺序输出会乱序
|
-
|
chn video attr & params:out_order
|
低延时输出
|
ss_mpi_vdec_set_low_delay
|
VDEC把未解码完的图像提前发给下一级
|
- VDEC中断数翻倍,CPU占用会增多
- 如果下一级不支持低延时功能,则行号不能设置太小,否则容易出现花屏
|
仅解码序支持
|
[VDEC]:detail low_delay state:output_enable
|
低延时输入
|
ss_mpi_vdec_set_low_delay
|
VDEC读取到单个slice时提前启动解码
|
多slice码流开启slice低延时解码,如果网络延时超过1s没有发送完一整帧的所有slice,可能引发硬件超时告警
|
不支持多路和流模式;仅视频解码支持
|
[VDEC]:detail low_delay state:input_enable
|
MCF
说明:
具体使用方式和注意事项参见《黑白彩色双路融合开发参考》。
Hi3511CV100/Hi3516CV610不支持MCF
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
低延时
|
ss_mpi_mcf_set_chn_low_delay
|
MCF把未处理完的图像提前发给下一级
|
- MCF中断数翻倍,CPU占用会增多
- 如果下一级不支持低延时功能,则行号不能设置太小,否则容易出现花屏
|
-
|
[MCF]:mcf phys chn other attr:low_delay_en
|
VO
说明:
具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"视频输出”章节。
Hi3511CV100/Hi3516CV610不支持VO
措施
|
相关接口/参数
|
功能描述
|
影响
|
注意
|
proc信息
|
|---|
显示门限值
|
ss_mpi_vo_set_chn_recv_threshold
|
门限值越小,预览延时越小,反之越大。
|
可能会出现丢帧,播放不流畅
|
-
|
vo chn play info 1: threshold
|
设置设备垂直时序中断门限
|
ss_mpi_vo_set_vtth
|
低延时处理中可以调小门限值,减小延时,尽快显示。
|
门限调节不合理可能会出现花屏
|
-
|
vo device vtth and param config: vtth
|
single非直通模式可开启视频层提前显示的功能
|
ss_mpi_vo_set_video_layer_early_display
|
single非直通模式视频层提前显示。需配合设置设备垂直时序中断门限调节使用
|
门限调节不合理可能会出现花屏
|
-
|
vo video layer status 4:early_display_en
|
单通道直通显示
|
内部自适应,条件约束很多
|
具体参见《MPP 媒体处理软件 V6.0 开发参考》"视频输出”章节里"1.2 基本概念"的单画面直通模式
|
-
|
-
|
-
|
DDR内存调优
综述
DDR小型化可以从多个方向入手:uboot、kernel、filesys、SDK、APP都可以在内存使用上做一定程度的优化。本文主要是对SDK和APP的小型化进行简单的说明,uboot、kernel、filesys的小型化请参考《Hi35xxx 系统小型化说明》。
DDR小型化按收益大小,一般建议的分析先后顺序为:
- 优化媒体通路数据流:首先画出整个系统的媒体通路业务数据流,然后逐级分析每个模块前后级之间的连接方式是否内存最优,不是内存最优的重新调整数据流。
- 优化媒体VB个数和VB大小:主要查看VB proc信息的min_free确认VB个数是否设置过多和free_bytes确认VB大小是否设置过大。具体参考“VB”章节。
- 优化媒体模块内存相关配置:一般有压缩/卷绕/buf复用/缓存buf size/队列长度/低延时加速buf轮转/位图格式等,具体参考“各模块内存相关可优化配置”章节。
- 优化OS内存布局:SDK版本默认的DDR内存布局,特别是OS区域的布局可能不是实际产品最优的,往往需要结合产品功能进行二次调整,请参考《内存布局调整指南》。
- 优化size大的buffer:建议使用backtrace函数打印出分配内存的函数调用栈,找出内存较大的buffer展开业务分析是否可以优化,例如是否可透传指针不需要malloc内存和copy、是否可以复用其它buffer、buffer的大小是否可以减小等。backtrace函数Linux和C库都支持,可网上搜索用法。
- 优化产品镜像大小:参考“Flash内存调优”章节。
典型场景业务的MMZ内存占用数据,请参考《Hi35xxVxxx Memory Usage Statistics Report》。此外,客户业务的具体内存占用,需结合具体场景进行分析,下文介绍各模块MMZ内存占用及小型化可优化手段。
主要模块工作占用MMZ情况
一般业务中MMZ的占用往往是内存消耗的很大一部分,本章节主要介绍一般业务场景中几个主要模块工作时占用MMZ的情况。
VI
 须知:
Hi3511CV100不支持bnr、3dnr、卷绕等所有pipe功能,不支持fmu。
VI采集状态下最多会占用三个视频帧VB。一个用于当前帧采集,一个用于准备给下一帧采集,一个在轮转流程中(主要是后级模块占用)。对于Hi3511CV100,如果存在可变附属信息,会占用一到两个可变附属信息VB。
- vi(%d)_model_%d:每路pipe需占用两个一定大小模板MMZ内存,大小与通路宽度相关,宽度小于等于4096时大小为16KB。
- vi(%d)_lmf:每路pipe开启LMF功能时占用MMZ内存,用于存放LMF的系数,固定值4K。
- vi(%d)_bnr_mot:每路pipe开启Bayer NR功能时需要占用的motion buffer内存,大小由处理图像大小的宽高决定,个数由ss_mpi_vi_set_pipe_bnr_buf_num接口配置,默认为2块,仅Hi3519DV500/Hi3516DV500支持。
- vi(%d)_bnr_rnt:每路pipe开启Bayer NR功能时需要占用的rnt内存,大小由处理图像大小的宽高决定;离线时个数由ss_mpi_vi_set_pipe_bnr_buf_num接口设置,默认为2块。
- vi(0)_bnr_tunl:每路pipe开启Bayer NR功能时需要占用的rnt内存,大小固定为4KB。
- vi(0)_bnr_ref%d:每路pipe开启Bayer NR功能时需要占用的时域参考内存,大小由处理图像大小的宽高决定。
- vi(0)_3dnr_para%d:每路pipe开启3DNR 功能时需要占用的模板内存,大小固定为4KB。
- vi(0)_3dnr_ref%d:每路pipe开启3DNR 时域降噪功能时需要占用的参考内存,大小由处理图像大小的宽高决定。
- vi(0)_3dnr_mad%d:每路pipe开启3DNR 时域降噪功能时需要占用的参考内存,大小由处理图像大小的宽高决定。
- fmu0_wrap_buf:VI开启FMU WRAP模式时需要卷绕空间占用的内存,大小由ss_mpi_sys_set_fmu_attr接口page_num决定;使用卷绕空间可节省原本写出需占用的VB内存,仅Hi3519DV500/Hi3516DV500支持。
- fmu0_cmp_head:VI开启FMU WRAP模式时需要占用的压缩头内存,大小由ss_mpi_vi_set_mod_param中最大宽高参数决定;使用卷绕空间可节省原本写出需占用的VB内存,仅Hi3519DV500/Hi3516DV500支持。
- vi(0) wrap pool:每路pipe开启VI卷绕后的卷绕buffer,仅Hi3516CV610支持。
- vi(0)_3dnr_stt%d:每路pipe开启3DNR 功能时需要占用的stt内存,大小由处理图像大小的宽高决定,仅Hi3516CV610支持。
- vi(0)_subsidiary_0:开启随帧信息功能时需要占用的随帧信息内存,大小为ss_mpi_vi_set_chn_subsidiary_attr接口配置的随帧信息的宽乘高。仅Hi3511CV100支持。
VDEC
须知:
Hi3516CV610不支持VDEC。
Hi3511CV100不支持JPEGD。
VDEC MMZ占用分为buffer占用、轮转占用和设备占用。
Buffer占用
- vdec(%d)_stream:解码码流Buffer和用户数据Buffer相关内存,为用户指定大小和驱动内部分配之和。
- vdec(%d)_pts_buf:用于存储码流Buffer管理的相关信息。
- jpegd_down_msg:用于存储Jpeg解码配置的相关信息,Hi3511CV100不涉及此块内存。
设备占用
- vfmw_scd_msg:SCD逻辑工作时需要的内存,固定值为40Kbytes。
- vfmw(%d)_seg_buf:SCD切码流后存放内存,与分辨率相关,与协议无关。
Hi3516DV500/Hi3519DV500:
- vfmw(%d)_vedu_msg:VEDU逻辑工作时需要的内存,与模块参数中设置最大slice个数相关,默认模块参数(slice 600个)时大小为168KBytes。
- vfmw_vedu_ext:VEDU逻辑工作时需要的内存大小100KBytes。
Hi3511CV100:
- vfmw_vdh_msg:VDH逻辑工作时消息池需要的内存,每个大小628KBytes,分配数量和用户在视频解码时模块参数中设置的vdh_msg_num相同,参考《MPP 媒体处理软件 V6.0 开发参考》ot_vdec_video_mod_param章节。
- vfmw_vdh_ext:VDH逻辑工作时需要的片外内存大小1848KBytes。
- vfmw_vdh_bin:VDH逻辑工作时用于存储bin流2368KBytes。
- vfmw(%d)_ais_buf:用于缓存SVAC3.0协议中的语义分割图码流,具体大小由用户设置,用户不使能智能语义分割时不会分配,参考《MPP 媒体处理软件 V6.0 开发参考》ot_vdec_aiseg_param章节。
- vfmw(%d)_priv_buf:用于缓存SVAC3.0协议中的隐私保护码流,驱动程序内部根据码流分辨率分配,非SVAC3.0协议解码时不会分配。
- vfmw(%d)_crr_buf:用于缓存SVAC3.0协议中的CRR分片码流,驱动程序内部根据码流分辨率分配,码流中不存在CRR分片时不会分配。
轮转占用
- vdec(%d)_pic_vb:vb大小和个数都由用户配置。私有vb模式下,大小根据用户配置通道属性中frame_buf_size确定,个数根据用户配置通道属性中frame_buf_cnt确定。
- vdec(%d)_tmv_vb:vb大小和个数都由用户配置。私有vb模式下,大小根据用户配置通道属性中tmv_buf_size确定,个数为 “参考帧+1”,其中参考帧个数根据用户配置通道属性中ref_frame_num确定。
VPSS
- vb_pool:Group占用两块VB (前级模块送来:当前工作VB+Backup 帧),每个使能通道会获取通道大小的VB(通道模式为Auto时,为后端模块获取),硬件处理完成后会发送到后端绑定模块。如果需要做旋转/二级缩放功能,还需申请中间的临时VB(公共VB)。
- vpss(%d)_model:每组需占用一定大小模板MMZ内存。大小与vpss_grp_cfg中的split_node_num和max_out_rgn_num有关。split_node_num和max_out_rgn_num越大,占用内存越大。
- vmallocinfo:每组上下文需占用一定大小OS内存。总大小与组数量相关,组越多占用越大。
Hi3519DV500/Hi3516DV500:
- vpss(%d)_ref:3DNR参考帧,3DNR开启时分配,大小取决于max_width和max_height。
- vpss(%d)_src:表示每组需占用MCF和DRC内存资源,约64K大小。
- vpss(%d)_lmf:每组开启LMF功能时占用MMZ内存,用于存放LMF的系数,固定值4K。
- vpss(%d)_angle_vel:vpss_grp_cfg中的is_dis_gyro_support开启时分配,每组占用约28K,大小固定。
- fmu1_cmp_head:VPSS开启FMU1 WRAP模式时占用的压缩头内存,第一次配置卷绕通道压缩时分配,系统退出时释放。模块参数中的max_out_height越大,占用内存越大。
- fmu1_wrap_buf:VPSS开启FMU1 WRAP模式时占用的内存卷绕空间,与页数有关。页数越大,占用内存越大。
- vpss(%d)_wrap_pool_sup_xx:FMU1卷绕supplement内存VB池,固定8K。
- vpss(%d)_direct_pool_sup_xx:FMU1直通supplement内存VB池,固定8K。
- vpss(%d)_blend_pool:拼接融合VB池,与接口配置的buf_num和overlap_point相关。
Hi3516CV610:
vpss(%d)_wrap_ld_pool_sup_xx:低延时卷绕supplement内存VB池,固定4K。
Hi3511CV100:
vpss(%d)_src:表示每组需占用组亮度和内存资源,约4K大小。
VGS
VGS模块根据job、node、task数目,分配固定的MMZ内存。
- vmallocinfo:根据job、task数目及上下文占用OS内存。数目越多占用越大。
- vgs_node_buf:根据node数目,占用一定大小的MMZ内存。数目越多占用越大。
VENC
须知:
Hi3511CV100不支持JPEG编码、WaterMark编码、质量均衡编码等。
VO
须知:
Hi3516CV610不支持VO。
VO MMZ占用分为系数MMZ占用、获取亮度和MMZ占用以及VB轮转MMZ占用。
-
系数MMZ占用:
vo_coef_buf:gamma配置系数(4KB)的内存占用, 共计4KB。
-
VB轮转MMZ占用:
vo(%d)_disp_buf:vb大小和个数都由用户配置。大小根据用户配置视频层属性img_size确定,个数根据用户配置视频层属性中display_buf_len确定。Single模式下VO会占用3块私有VB用来显示轮转。
Multi模式下,如果前端绑定VPSS为auto模式,VO会占用4块私有VB用来显示轮转;如果前端为User模式,VO可以不分配VB,此时占用前端模块发送过来的VB,显示完后释放。
GFBG
须知:
Hi3516CV610不支持GFBG。
加载ko时,用户指定图形层的显示buf大小。支持的图层均可指定,图层id号与vram id号需保证匹配。
例如:insmod gfbg.ko video="gfbg:vram0_size:32400".
vram0_size: 对应gfbg0图形层内存大小,单位KB,对应mmz name= gfbg_layer0。
AUDIO
AI
- ai(%d)_frm:AI的通道buffer根据bit_width、chn_cnt、frame_num和point_num_per_frame分配。
- ai(%d)_dma:AI的DMA缓冲区根据bit_width、chn_cnt和point_num_per_frame分配。
AO
- ao(%d)_dma&frm:AO的DMA缓冲区和通道buffer根据bit_width、chn_cnt、frame_num和point_num_per_frame分配。
- ao(%d, %d)_cir:音频帧buffer根据bit_width、frame_num和point_num_per_frame分配。
AENC
- aenc(%d)_strm:码流buffer根据buf_size分配。
- aenc(%d)_cir:环形缓冲区根据编码通道数分配。
REGION
区域信息上下文节点
去掉不必要的模块可以减少内存的占用,如:
- 模块加载时分配的区域信息上下文节点,占用os内存4kb。区域信息上下文在创建区域时动态分配。
- 如果是overlay或者是overlayex类型的区域,还会创建乒乓buffer用于存放位图数据。
- rgn_pin_pon_(%d):乒乓buffer的大小由用户设置的width,height,canvas_num和颜色格式决定,占用MMZ内存。
通道管理信息节点
其他模块调用REGION的函数向REGION注册信息时动态分配,占用os内存。
TDE
须知:
Hi3516CV610/Hi3511CV100不支持TDE。
加载ko时,用户可以指定TDE节点的数量,默认为200,最大只支持500。MMZ占用总大小(Byte):g_max_node_num * 64 + g_max_node_num * 96 + g_max_node_num * 8544 + 3 * 8704。
例如:insmod ot_tde.ko g_max_node_num=100
SVP
SVP_NPU
SVP__NPU_内存占用分为MMZ内存和os内存,其中MMZ内存包括任务节点和推理内容内存。
IVE
IVE内存占用分为MMZ内存和os内存,其中MMZ内存包括任务链表和辅助内存。
Hi3519DV500/Hi3516DV500:
Hi3516CV610:
-
任务链表MMZ占用
ive_queue: IVE任务链表的大小,默认为72KB。
-
算子om的MMZ占用
ive_npu_om:IVE算子om的大小,固定值244KB。
-
辅助MMZ内存占用:
- ive_tmp_node: IVE的多算子组合任务需要的临时节点,固定值4KB。
- Md_proc: MDproc信息需要的MMZ内存,固定值8KB。
- ive_resize_param: resize算子计算需要的辅助内存,固定值12KB。
- ive_yuv_to_hsv_table: ive颜色空间转换存放table的辅助内存,固定值2048Byte。
- ive_yuv_to_lab_table: ive颜色空间转换存放table的辅助内存,固定值6656Byte
-
OS内存占用:
ive占用的OS内存主要分为kmalloc开辟的内存和静态全局变量占用内存,OS内存加MMZ内存不超过342KB。
PCIV
须知:
Hi3519DV500/Hi3516CV610不支持PCIV。
PCIV模块MMZ占用与PCIV模块的通道模式和类型有关。大致分为pcie-mcc消息池占用、window占用、DATA传输通道MMZ占用,FRAME传输通道VB轮转占用。
-
pcie-mcc消息池占用:
用于pcie-mcc消息通信,在加载从片pcie驱动时指定位置与大小,大小固定为1M。
-
DATA传输通道MMZ占用:
PCIV模块的每条DATA传输通道,包括发送端和接收端,都会配置用户指定长度的MMZ内存空间,用于存放用户调用接口发送进来的数据。MMZ大小由用户指定,建议为发送数据总长度的平均值的8倍且满足4字节对齐要求。
-
VB轮转占用:
发送端通道接收前端模块送过来的VB,如果传输速率足够(图像小,帧率低),通道可只占用1个VB。如果传输速率不足(图像大,帧率快),通道最多可以占用8个VB。
接收端从VB pool中获取VB,用来存放发送端发送过来的图像以及可能的附属帧信息和可变帧信息。如果传输速率足够(图像小,帧率低),通道可只占用1个图像VB以及可能的附属信息和可变帧信息VB。如果传输速率不足,通道最多可以占用8个图像VB以及可能的8个附属信息和可变帧信息VB。用户队列最大深度为8,最多可以占用8块用户VB,用户可以根据业务需求调增用户队列深度。
GDC
须知:
Hi3516CV610不支持GDC。
GDC模块根据job、node、task数目,分配固定的MMZ内存。
- vmallocinfo:根据job、task数目及上下文占用OS内存。数目越多占用越大。
- gdc_node_buf:根据node数目,占用一定大小的MMZ内存。数目越多占用越大。
- gdc_int_pole_coef:存储插值系数需要的MMZ内存,固定值4KB。
- 读取LUT会占用MMZ内存。
CIPHER
固定大小(驱动内部确定申请的MMZ内存的长度)
Cipher驱动模块初始化:
1、给CCM、GCM、CBC-MAC保存计算中间临时数据,固定值12KB。
2、支持虚拟多通道、多进程场景存储AES-CCM、AES-GCM的aad的物理内存1280KB,最大通道数为32,最大进程数为10。
3、给Cipher节点链表分配内存entry list size(96bytes)。
4、给Hash节点链表分配内存entry list size(288bytes)。
5、给Hash接口申请384KB内存用来存放用户传入的源数据。
非固定大小(由用户层接口传入的MMZ内存申请的长度)。
Cipher加解密:依赖虚拟地址/物理地址加解密接口的参数byte_len。
Cipher驱动模块运行时临时申请的内存,不超过256bytes,使用完后释放。
VDA
须知:
Hi3519DV500/Hi3516DV500/Hi3516CV610不支持VDA。
vda(%d):通道内部计算结果存储相关内存,主要包括SAD结果内存、RGN运动区域信息内存和背景。
ISP
- isp[%d].vreg[%d]:外部虚拟寄存器内存。
- isp[%d].proc:用户态算法proc调试信息。
- isp[%d].trans:dng, dcf, color gamut等信息内存。
- isp[%d].ldci:ldci算法内存。
- isp[%d].clut:clut算法内存。
- be_lut_stt[%d]:be lut信息内存。
- isp[%d].stat:统计信息(FE,BE)内存。
- isp[%d].fe_stat:FE统计信息内存。
- isp[%d].drc:drc算法内存。
- isp[%d].be_cfg:离线通路be config buffer。
- isp[%d].be_stt_on:在线通路be统计信息内存。
- isp[%d].fe_stt:fe统计信息内存。
- isp[%d].be_stt:离线通路be统计信息内存。
- isp[%d].stit_fe:拼接通路fe统计信息内存。
- isp[%d].stit_be:拼接通路be统计信息内存。
AIISP
须知:
Hi3516CV610只支持AIBNR。
-
AIBNR:
- aibnr_model_[%d]_[%d]:模型文件内存。
- work_buf:模型推理使用的工作内存。
- Hi3519DV500/Hi3516DV500开启AIBNR功能参考帧模式需要单独分配1个VB池,用户VB池需要分配7个视频帧VB,无参考帧模式需要分配6个视频帧VB。
- Hi3516CV610开启AIBNR功能,用户VB池需要分配4个视频帧VB。在vi的early_end模式中,如果NPU只处理AIBNR任务且性能充足情况下,分配3个视频帧VB即可。
-
AIDRC:
- aidrc_model_[%d]_[%d]:模型文件内存。
- work_buf:模型推理使用的工作内存。
- 开启AIDRC功能需要单独分配两个用户VB池,输入VB池需要分配3个视频帧VB,输出VB池需要分配3个视频帧VB。
-
AI3DNR:
- ai3dnr_model_[%d]_[%d]:模型文件内存。
- work_buf:模型推理使用的工作内存。
- 开启AI3DNR UV net功能参考帧模式需要单独分配1个用户VB池,用户VB池需要分配3个视频帧VB。
各模块内存相关可优化配置
VB
措施
|
相关模块参数/接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
检查是否有VB池的VB个数设置过多
|
略
|
min_free不为0的pool id里的VB块个数设置过多,可以再减去min_free个。
|
-
|
公共VB池、模块VB池、UserVB池的个数设置参见《MPP 媒体处理软件 V6.0 开发参考》“系统控制”章节的VB相关接口。
PrivateVB池的个数设置需要到相关模块的接口里找到对应的参数。
|
min_free:VB个数的历史最小余量
|
检查是否有VB块size设置过大
|
略
|
free_bytes不为0的VB块size分大了,可以再减去free_bytes。
|
-
|
公共VB池、模块VB池、UserVB池的VB块大小设置参见《MPP 媒体处理软件 V6.0 开发参考》“系统控制”章节的VB相关接口。
PrivateVB池的个数设置需要到相关模块的接口里找到对应的参数。
|
- free_bytes:VB块的实时剩余bytes
- get:获取VB块的模块,通过此信息可以判断具体哪个模块的VB块size分大了
|
SYS
须知:
Hi3519DV500/Hi3516DV500/Hi3516CV610/Hi3511CV100不支持Quick schedule。
措施
|
相关模块参数/接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
设置调度模式为OT_SCHEDULE_QUICK
|
ss_mpi_sys_set_schedule_mode
|
加速vb轮转,可以减少vb分配
|
-
|
具体操作和注意事项请参考《MPP 媒体处理软件 V6.0 FAQ》的“1.8 Quick schedule”注意事项
|
-
|
VI
须知:
Hi3511CV100不支持wdr、bnr、3dnr、卷绕等所有pipe功能,不支持fmu,不支持isp功能,不支持VICAP开启LowDelay。
措施
|
相关接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
开启 Early/Early_end机制
|
ss_mpi_vi_set_pipe_frame_interrupt_attr;
Hi3511CV100使用
ss_mpi_vi_set_chn_frame_interrupt_attr
|
线性或者在线WDR,节省一个VB;离线WDR(2路),节省两个VB;
Hi3511CV100最多可节省一个VB。
|
VI采集响应的中断数翻倍
|
-
|
vi pipe frame interrupt attr:
interrupt_type;
Hi3511CV100参考下面的proc信息:
vi frame interrupt attr:
int_type
|
chn输出设置压缩
|
ss_mpi_vi_set_chn_attr
|
压缩比不压缩情况要更节省内存和带宽
|
-
|
-
|
- vi phys chn attr1:
compress_mode
- 其他:vi phychn attr 2:
compress_mode
|
在线WDR行模式卷绕
|
ss_mpi_vi_set_wdr_fusion_grp_attr
|
默认不卷绕,根据配置的cache_line节省内存
|
cache_line配置过小时可能导致图像分层
|
-
|
vi wdr fusion grp attr:cache_line
|
VICAP开启LowDelay
|
ss_mpi_vi_set_pipe_low_delay
|
在VICAP的LowDelay中断里把图像提前发给VIPROC,加速VB轮转,有可能可以节省一个VB
|
VICAP中断数翻倍,CPU占用会增多
|
- VICAP和VIPROC之间使用offline模式有效
- 多pipe场景不建议开启(会拖慢viproc性能)
|
vi pipe low delay attr:enable
|
pipe设置压缩输出
|
ss_mpi_vi_set_pipe_attr
|
压缩比不压缩情况要更节省内存和带宽
|
-
|
Hi3519DV500的防抖/LCD/Rotate场景只支持配置数据格式为OT_VIDEO_FORMAT_LTILE_32x4,压缩模式为 OT_COMPRESS_MODE_TILE
|
vi pipe attr1:
compress_mode
|
调整VI_VPSS之间的工作模式
|
ss_mpi_sys_set_vi_vpss_mode
|
在线/在离线/离在线通路比全离线通路节省1-2个VB;
|
VI在线只能处理一路,VPSS在线无法在VI_CHN做通道后处理相关功能
|
SOC仅单路场景支持全在线模式,且不支持DIS/LDC/RTT/VI通道后处理等功能
|
vi vpss mode & vi aiisp mode & fmu mode:vi_vpss_mode
|
调整VI FMU模式
|
ss_mpi_sys_set_vi_chn_fmu_mode
|
FMU模式下比普通模式每路pipe可节省两块VB
|
FMU模式下VI_VPSS需绑定在一起,无法在VI_CHN做通道后处理相关功能
|
仅Hi3519DV500/Hi3516DV500支持FMU。
参见《MPP 媒体处理软件 V6.0 FAQ》的“FMU”章节
|
vi vpss mode & vi aiisp mode & fmu mode:
fmu_mode
|
调整BayerNR buf_num个数
|
ss_mpi_vi_set_pipe_bnr_buf_num
|
默认个数为最小2个,AIDRC、AI3DNR场景需要调整至3-4个;
|
bnr_buf_num主要影响AIDRC、AI3DNR效果,需要根据实际AIISP缓存配置个数
|
-
|
vi pipe bnr buf num:
bnr_buf_num
|
手动关闭 ISP BayerNR功能
|
ss_mpi_isp_set_nr_attr
|
关闭BayerNR可节省参考帧等内存和带宽
|
影响效果
|
-
|
bayernr info: enable
|
手动关闭VI 3DNR功能,或设置为空域降噪模式
|
ss_mpi_vi_set_pipe_3dnr_attr
|
关闭3DNR时域参考,可节省参考帧等内存和带宽
|
影响效果
|
-
|
vi pipe 3dnr attr: enable,nr_type
|
调整pipe dump 帧时缓存depth大小
|
ss_mpi_vi_set_pipe_frame_dump_attr
|
depth深度决定buffer缓存深度;捞帧不及时场景下调小depth可节省对应buffer个数
|
需要从pipe获取帧数据时depth至少设为1;不需要时建议不开。
|
-
|
vi pipe frame dump attr:
enable; depth
|
调整chn_attr 缓存深度depth大小
|
ss_mpi_vi_set_chn_attr
|
depth深度决定buffer缓存深度;捞帧不及时场景下调小depth可节省对应buffer个数
|
需要从chn获取帧数据时depth至少设为1;不需要时建议设置为0。
|
-
|
vi phys chn attr2:
depth
Hi3511CV100参考下面的proc信息:
vi chn status:
depth
|
设置VI pipe卷绕
|
ss_mpi_vi_set_pipe_buf_wrap_attr
|
VI离线通路节省1-2个VB
|
开启pipe卷绕后不支持pipe dump 帧,也不支持从pipe送图
|
仅Hi3516CV610支持
|
vi pipe wrap status:
wrap_en; buf_line
|
VDEC
措施
|
相关模块参数/接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
解码码流buffer使用省内存模式分配
|
ss_mpi_vdec_set_mod_param:mini_buf_mode
|
- 可以把码流buffer设置小一些。
- 可以减少vfmw(%d)_seg_buf内存
|
-
|
-
|
module param:mini_buf_mode
|
控制用户数据user data buffer大小
|
ss_mpi_vdec_set_user_data_attr:
|
不申请或者少申请user data buffer
|
-
|
-
|
detail user_data state:
|
控制jpeg解码progressive_buffer
|
ss_mpi_vdec_set_mod_param:
progressive_en
|
不申请progressive_buffer
|
使用JPEGD progressive功能时,设置dynamic_alloc_en为TD_TRUE,可以动态分配progressive_buffer,减少progressive_buffer内存占用
|
Hi3511CV100不支持JPEG解码,无法优化
|
module param:progressive_en
|
按场景设置解码器最大能力集
|
ss_mpi_vdec_set_mod_param:
- video_mod_param
- pic_mod_param
|
可节省部分MMZ和OS内存
|
VEDU/VDH相关的内存分配的内存少了可能会导致解码性能下降,但是不影响功能。JPEGD的相关配置可以节省OS内存。
|
Hi3511CV100不支持JPEG解码,无法优化OS内存
|
module param:
- max_video_width
- max_video_height
- max_slice_num
- vdh_msg_num
- max_pic_width
- max_pic_height
- progressive_en
- dynamic_alloc_en
- capacity_strategy
|
按场景设置解码通道能力集
|
ss_mpi_vdec_set_protocol_param
|
可节省部分OS内存
|
-
|
-
|
chn video attr & params:
- max_vps_num
- max_sps_num
- max_pps_num
- max_slice_segment_num
|
H264解码无B帧码流时可关闭Tmv开关
|
ss_mpi_vdec_create_chn:temporal_mvp_en
|
可节省Tmv buffer
|
-
|
-
|
chn video attr & params:tmv_en
|
解码模块最大支持的通道数
|
g_vdec_max_chn_num
g_vfmw_max_chn_num
|
可节省部分OS内存
|
-
|
-
|
module param:g_vdec_max_chn_num
|
只解码I帧的通道把参考帧设置为0
|
ss_mpi_vdec_create_chn:
ref_frame_num
|
减少pic_vb、tmv_vb分配个数
|
-
|
把通道解码模式设置为I模式,否则logmpp会报错。
|
chn video attr & params:ref_num
|
设置快速释放参考帧模式为自适应模式或者强制模式
|
ss_mpi_vdec_set_chn_param:
quick_mark_mode
|
加速vb轮转,可以减少pic_vb、tmv_vb分配个数
|
-
|
-
|
chn video attr & params:
quick_mark_mode
|
根据实际应用的宽高尽量小的创建通道
|
ss_mpi_vdec_create_chn
|
可以减少vfmw(%d)_seg_buf内存
|
-
|
-
|
chn comm attr & params:
|
VDEC-VPSS快速帧存轮转
|
调用ss_mpi_vdec_set_chn_param设置display_frame_num为0
调用ss_mpi_vpss_disable_backup_frame关闭backup帧
|
针对所有自编码流,实现快速帧存轮转,每个解码通道节省一个VB
|
-
|
影响播放流畅性;Hi3511CV100不支持VDEC-VPSS快速帧存轮转
|
[VDEC]:chn comm attr & params的display_num
[VPSS]:vpss grp attr1:backup
|
设置语义分割解码开关和buffer大小
|
调用ss_mpi_vdec_set_protocol_param关闭智能语义分割开关或者调整语义分割图模式buffer大小
|
不申请或者减少vfmw(%d)_ais_buf大小
|
|
仅Hi3511CV100支持
|
[VDEC]:chn video attr & params aiseg_en aiseg_buf_size
|
说明:
具体参见《MPP 媒体处理软件 V6.0 开发参考》"视频解码”章节。
Hi3516CV610不支持VDEC。
VPSS
措施
|
相关模块参数/接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
关闭backup帧
|
- ss_mpi_vpss_enable_backup_frame
- ss_mpi_vpss_disable_backup_frame
|
每个VPSS GROUP少占用1帧输入源的buffer。
|
VO暂停情况下放大或切换画面时显示设备背景色。
|
Hi3516CV610/Hi3511CV100不支持。
|
vpss grp attr1:backup
|
不同时开启nr、dei功能
|
ss_mpi_vpss_create_grp
|
每个VPSS GROUP少分配两帧buffer(参考帧和重构帧)。
|
影响图像效果。
|
Hi3516CV610/Hi3511CV100不支持。
nr、dei中只要有一个功能开启,都会分配参考帧和重构帧buffer。
|
vpss grp attr:
|
通道输出YUV压缩
|
ss_mpi_vpss_set_chn_attr:compress_mode
|
比不压缩情况要更节省内存和带宽。
|
-
|
Hi3519DV500/Hi3516DV500/Hi3511CV100支持CHN0、CHN1输出YUV压缩。
Hi3516CV610支持CHN0输出YUV压缩。
|
vpss chn output status:cmp_mode
|
开启 Early/Early_end机制
|
ss_mpi_vpss_set_grp_frame_interrupt_attr
|
全在线模式下每个通道节省一帧buffer。
|
-
|
-
|
frame interrupt attr: int_type
|
调整VPSS FMU模式
|
ss_mpi_vpss_set_chn_fmu_mode
|
FMU模式使用公共卷绕空间,不占用VB池中的VB。
FMU模式下比普通模式每路pipe可节省两块VB。
|
FMU模式下VI_VENC需绑定在一起,无法在VPSS_CHN做通道后处理相关功能,其他限制参考视频处理子系统章节
|
仅Hi3519DV500/Hi3516DV500支持FMU。
参见《MPP 媒体处理软件 V6.0 FAQ》的“FMU“章节
|
vpss chn fmu info: fmu_mode
|
减小模块参数max_out_height
|
ss_mpi_vpss_set_mod_param
|
卷绕压缩输出时,降低最大输出高度来减少卷绕压缩输出的压缩头内存占用。
|
-
|
仅Hi3519DV500/Hi3516DV500支持。
默认为支持的最大输出高度
|
vpss module param:
max_out_height
|
关闭旋转输入is_rotation_input_support
|
ss_mpi_vpss_set_grp_cfg:is_rotation_input_support
|
3DNR场景,输入无需旋转时可关闭此参数以节省3DNR参考帧内存。
|
-
|
Hi3516CV610/Hi3511CV100不支持。
默认关闭
|
vpss grp cfg:
is_rotation_input_support
|
关闭陀螺仪防抖is_dis_gyro_support
|
ss_mpi_vpss_set_grp_cfg:is_dis_gyro_support
|
无需使用陀螺仪防抖时可以关闭此参数以节省陀螺仪相关数据内存。
|
关闭时不支持陀螺仪防抖功能
|
Hi3516CV610/Hi3511CV100不支持。
默认关闭
|
vpss grp cfg:
is_dis_gyro_support
|
减小最大分块节点数max_split_num
|
ss_mpi_vpss_set_grp_cfg:max_split_num
|
无需分块时可设置为1,以节省模板内存。
|
Hi3519DV500/Hi3516DV500/Hi3511CV100为1时不支持输入图像超过4096。
Hi3516CV610为1时不支持输入图像超过3200。
|
Hi3519DV500/Hi3516DV500/Hi3511CV100默认为3。
Hi3516CV610默认为1。
|
vpss grp cfg:
max_split_num
|
减小最大输出区域数max_out_rgn_num
|
ss_mpi_vpss_set_grp_cfg:max_out_rgn_num
|
鱼眼多区域输出时,该值不能小于鱼眼区域数;拼接场景时,该值不能小于拼接pipe数;其他场景可设置为1以节省模板内存。
|
配置为1时不支持拼接或鱼眼多区域功能
|
仅Hi3519DV500/Hi3516DV500支持。
默认为1
|
vpss grp cfg:
max_out_rgn_num
|
关闭lut写出
|
ss_mpi_vpss_set_grp_cfg:
lut_cfg
ss_mpi_vpss_query_grp_gdc_pos_dst_to_src
|
使用GDC反向坐标查找接口时时需开启并配置内存大小,其他情况下可关闭以节省lut写出内存。
|
关闭时不支持GDC反向坐标查询
|
仅Hi3519DV500/Hi3516DV500支持。
默认关闭
|
vpss grp cfg:
is_save_out_lut
|
设置VPSS chn卷绕
|
ss_mpi_vpss_set_chn_buf_wrap
|
开启chn卷绕,通路可节省1-2个VB;双目场景也支持,并且双路复用同一个卷绕buffer。
|
不支持VPSS通道后处理功能;绑定的VENC通道不支持重编(超大帧重编、超大码率重编)、不支持QpMap、不支持马赛克、不支持增帧、不支持mpi send venc方式,在线(VI在线VPSS在线)卷绕不支持去呼吸效应;绑定的jpeg通道不支持缩略图
|
仅Hi3516CV610支持。
|
vpss chn wrap attr:
enable; buf_line
|
说明:
具体使用方法及限制参见《MPP 媒体处理软件 V6.0 开发参考》“视频处理子系统”章节。
VGS
措施
|
相关模块参数
|
收益
|
影响
|
注意
|
proc信息
|
|---|
设置VGS支持的最大job数
|
g_max_vgs_job
|
默认值64,按需减小可节省内存
|
job数量过少会限制VGS性能。
|
-
|
module params:g_max_job_num
|
设置VGS支持的最大task数
|
g_max_vgs_task
|
默认值100,按需减小可节省内存
|
task数量过少会限制VGS性能
|
-
|
module params:g_max_task_num
|
设置VGS支持的最大node数
|
g_max_vgs_node
|
默认值100,按需减小可节省内存
|
node数量过少会限制VGS性能
|
-
|
module params:g_max_node_num
|
VGS模块主要是OS内存和node用的mmz。考虑场景的减小最大job数、最大task数和最大node数可以降低些OS占用内存以及node占用的MMZ内存。
说明:
具体使用方法及限制参见《MPP 媒体处理软件 V6.0 开发参考》“视频图形子系统”章节。
VENC
措施
|
相关模块参数/接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
动态切换编码分辨率
|
- ss_mpi_venc_set_chn_attr
- ss_mpi_venc_get_chn_attr
|
切换编码分辨率时不销毁通道,减少内存碎片,如使用NormalP,可比SmartP和DualP减少参考帧/重构帧占用帧存的总大小
|
无
|
切换分辨率后所有参数恢复默认值。
|
-
|
编码码流buffer使用省内存模式分配
|
ss_mpi_venc_set_mod_param:mini_buf_mode
|
可以把码流buffer设置小一些。
|
此模式需要用户保证码流buffer大小设置合理,在码率较高或客户获取码流不及时情况下出现码流buffer不足而不断重编或者丢帧的情况。
|
-
|
h265e/h264e/jpege模块都有module param:mini_buf_mode
|
参考帧重构帧buffer复用
|
ss_mpi_venc_create_chn:rcn_ref_share_buf_en
|
大约可节省(ref_num+1-1.2* ref_num)帧buffer
|
- 超大帧、码率过冲、码流buffer满等异常情况导致的丢帧或者重编,下一帧只能插入I帧;
- 在特定场景(例如噪声很多的场景),可能存在复用之后buffer不够放重构帧数据,下一帧因为缺少参考会存在图像底部刷i块
|
-
|
h265e/h264e模块的ref_param info:rcn_ref_share_buf_en
|
参考帧重构帧buffer比例调节
|
- ss_mpi_venc_set_chn_attr
- ss_mpi_venc_get_chn_attr
frame_buf_ratio
|
若设置为80,则帧buffer为原始大小的80%。
|
- P帧刷I slice可能会出现整帧刷成I块且提前结束刷I slice;
- 去呼吸效应在某些帧上可能会失效;
- QPMAP表不能强制指定skip块,SkipWeight表不能强制指定skip块
- ROI背景低帧率编码可能会出现部分帧的非ROI区域不能编码为p_skip块
- 某些场景指定为p_skip帧的情况下可能会失效,如编码瞬时码率超过阈值时丢帧策略。
- skip倾向性可能会失效
- 在特定场景(例如噪声很多的场景),可能节省buf之后不够放重构帧数据,下一帧因为缺少参考会存在图像底部刷i块
|
-
|
h265e/h264e模块的ref_param info:frame_buf_ratio
|
动态回收参考帧buffer
|
ss_mpi_venc_set_mod_param:frame_buf_recycle
|
当编码切换GOP模式,参考帧由多变少时,可动态释放多出来的参考帧buffer
|
-
|
-
|
venc 模块的module param:frame_buf_recycle
|
编码模块支持的最大通道数
|
模块参数:g_venc_max_chn_num
|
可节省部分OS内存
|
-
|
-
|
venc模块的module param:venc_max_chn_num
|
相同分辨率多通道编码使用UserVB模式节省内存
|
ss_mpi_venc_set_mod_param:vb_src
|
比PrivateVB模式节省更多帧存buffer
|
-
|
仅h265e/h264e支持
|
h265e模块的module param:h265_vb_src;
h264e模块的module param:h264_vb_src
|
编码软件增帧
|
ss_mpi_venc_set_chn_config:duplicate_frame_strategy设置为OT_VENC_DUPLICATE_FRAME_STRATEGY_COPY
|
- 软件增帧支持vpss-venc卷绕,相比离线节省约2个VB(Hi3511CV100不支持)。
- 软件增帧相比硬件增帧节省功耗
|
- 增帧OSD不更新,与上一帧完全一致
- 增帧只能编码P帧
- 增帧H265 slice data与上一帧完全一致,H264是skip帧(整帧十几byte)
|
仅h265e/h264e支持
|
venc模块的venc chn attr 3:
dup_frame_strategy
|
vpss-venc卷绕模式支持QPmap
|
支持在venc和vpss绑定模式下调用接口ss_mpi_venc_send_qpmap单独送qpmap
|
|
-
|
Hi3511CV100不支持
|
venc模块的venc pts state:user_qpmap_pts
|
编码配置动态参数保持内存布局不变
|
ss_mpi_venc_set_chn_capability配置通道能力集合
|
动态改变协议、分辨率等参数时,编码通道内存布局不变不产生内存碎片
|
通道实际运行时,在某些功能不开启情况下,会存在一定的内存浪费
|
-
|
venc模块的venc chn_capability
|
说明:
具体参见《MPP 媒体处理软件 V6.0 开发参考》"视频编码”章节。
VO
措施
|
相关接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
VO水线设置为2
|
ss_mpi_vo_set_chn_recv_threshold
|
减少通道VB的积累
|
可能出现少量丢帧
|
-
|
vo chn play info 1:threshold
|
回放模式显示队列长度设置最小值3
|
ss_mpi_vo_set_video_layer_attr
|
高清设备可节省1帧buffer。
|
影响VO显示流畅性。
|
-
|
vo video layer status 2:disp_buf_len
|
直通模式disp_buf_len可以设置为0
|
ss_mpi_vo_set_video_layer_attr
|
可不用分配Display Buffer
|
-
|
-
|
vo video layer status 2:disp_buf_len
|
单区域模式VO省buffer方案
|
- ss_mpi_vo_set_video_layer_attr
- ss_mpi_vo_set_vtth
- ss_mpi_vo_set_less_buf_attr
|
单区域模式非直通时可设置显示buff最小为2
|
减少了一块用于显示的buffer
|
-
|
- vo video layer status 2:disp_buf_len
- vo interface status:
- vtth less_buf_enable
- less_buf_vtth
|
说明:
具体参见《MPP 媒体处理软件 V6.0 开发参考》"视频输出”章节。
Hi3516CV610不支持VO。
GFBG
须知:
Hi3516CV610/Hi3511CV100不支持GFBG。
加载ko时,叠加图形层的显存大小根据像素格式、分辨率大小、buf模式算出,用户可以根据实际使用场景来得出需要的显存大小。
非压缩:按实际UI大小,像素格式,单双BUF计算分配:
例:1080P argb8888 双buf模式,
buf_size = 1920 * 4 * 1080 * 2 / 1024 = 16200KB
措施
|
相关模块参数/接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
设置合适的图形层物理显存
|
video
|
根据实际分辨率设置合适的图形层物理显存避免内存浪费。
|
无
|
-
|
mem_size
|
AUDIO
措施
|
相关接口/参数
|
收益
|
影响
|
注意
|
proc信息
|
|---|
按场景合理设置通道数量、AI缓存音频帧数量、一帧采样点数。
|
ss_mpi_ai_set_pub_attr:chn_cnt、frame_num、point_num_per_frame
|
可节省部分OS内存
|
需要用户保证buffer大小设置合理,否则可能会出现采集丢帧等异常。
|
-
|
cat /proc/umap/ai
ai dev attr:chn_cnt、frame_num、point_num
|
按场景合理设置AENC缓存音频帧大小
|
ss_mpi_aenc_create_chn:buf_size
|
可节省部分OS内存
|
需要用户保证buffer大小设置合理,否则可能会出现采集丢帧等异常。
|
-
|
cat /proc/umap/aenc
aenc chn attr:buf_size
|
按场景合理设置ADEC缓存音频帧大小
|
ss_mpi_adec_create_chn:buf_size
|
可节省部分OS内存
|
需要用户保证buffer大小设置合理,否则可能会出现采集丢帧等异常。
|
-
|
cat /proc/umap/adec
adec chn attr:buf_size
|
按场景合理设置通道数量、AO缓存音频帧数量,一帧采样点数。
|
ss_mpi_ao_set_pub_attr:chn_cnt、frame_num、point_num_per_frame
|
可节省部分OS内存
|
需要用户保证buffer大小设置合理,否则可能会出现采集丢帧等异常。
|
-
|
cat /proc/umap/ao
ao dev attr:chn_cnt、
frame_num、point_num
|
说明:
具体参见《MPP 媒体处理软件 V6.0 开发参考》“音频”章节。
REGION
- 用户分配乒乓buffer指定的width,height按需要尽可能小。
- 当区域类型为overlay/overlayex格式时,可以设置pixel_format为CLUT2/CLUT4,CLUT2相比ARGB1555可节省7/8的内存,CLUT4相比1555可节省3/4内存。此方法会降低图像质量。
- overlay/overlayex可采用单buff模式,方法为把区域属性中的canvas_num设置为1,当图像需要频繁刷新时可能会出现撕裂效果。
- 参考文档《MPP 媒体处理软件 V6.0 开发参考》“区域管理”章节,proc信息查看命令cat /proc/umap/rgn。
措施
|
相关模块参数/接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
使用ARGB CLUT2 OVERLAY和OVERLAYEX_RGN
|
ss_mpi_rgn_create: pixel_format 设置为OT_PIXEL_FORMAT_ARGB_CLUT2、OT_PIXEL_FORMAT_ARGB_CLUT2_2x2、OT_PIXEL_FORMAT_ARGB_CLUT2_4x4
|
ARGB CLUT2是 ARGB 1555的1/8,是ARGB 8888的 1/16。
ARGB CLUT2_2x2是ARGB CLUT2的1/4;ARGB CLUT2_4x4是ARGB CLUT2的1/16。
|
只能显示4种颜色;ARGB CLUT2_2x2是2bit对应1个2x2像素块,要求区域坐标和宽高2对齐;ARGB CLUT2_4x4是2bit对应1个4x4像素块,要求区域坐标和宽高4对齐。
|
Hi3516CV610不支持OVERLAYEX。
Hi3519DV500/Hi3516DV500/Hi3511CV100不支持ARGB CLUT2_2x2和ARGB CLUT2_4x4。
多个OSD叠加有重叠区域时,Layer层次高的OSD会覆盖Layer层次低的OSD。
|
region status of overlay: pixel_format;
region status of overlayex: pixel_format
|
使用ARGB CLUT4 OVERLAY和OVERLAYEX_RGN
|
ss_mpi_rgn_create: pixel_format 设置为OT_PIXEL_FORMAT_ARGB_CLUT4、OT_PIXEL_FORMAT_ARGB_CLUT4_2x2、OT_PIXEL_FORMAT_ARGB_CLUT4_4x4
|
ARGB CLUT4是 ARGB 1555的1/4,是ARGB 8888的 1/8。
ARGB CLUT4_2x2是ARGB CLUT4的1/4;ARGB CLUT4_4x4是ARGB CLUT4的1/16。
|
只能显示16种颜色;ARGB CLUT4_2x2是4bit对应1个2x2像素块,要求区域坐标和宽高2对齐;ARGB CLUT4_4x4是4bit对应1个4x4像素块,要求区域坐标和宽高4对齐。
|
Hi3516CV610不支持OVERLAYEX。
Hi3519DV500/Hi3516DV500/Hi3511CV100不支持ARGB CLUT4_2x2和ARGB CLUT4_4x4。
多个OSD叠加有重叠区域时,Layer层次高的OSD会覆盖Layer层次低的OSD。
|
region status of overlay: pixel_format;
region status of overlayex: pixel_format
|
SVP
SVP_NNN
措施
|
相关接口/参数
|
收益
|
影响
|
注意
|
proc信息
|
|---|
转换模型时配置参数:ATC --batch_num参数配置1
|
batch_num
|
可以减少输入输出及workbuf的内存占用
|
当推理网络有FC操作时,且一次性推理图片张图不为1时,会影响性能。
|
-
|
-
|
转换模型时配置参数:ATC --online_model_type参数配置为0
|
online_model_type
|
此配置使转换的模型不带调试相关信息,减少模型占用内存
|
当需要调试信息时,无法获取。
|
-
|
-
|
转换模型时配置参数:ATC --save_original_model=false
|
save_original_model
|
生成的om不包含原始模型信息,减少模型占用内存。
|
当需要原始模型信息时,无法获取。
|
-
|
-
|
量化参数配置:AMCT
activation_quant_params - num_bits配置为8
|
activation_quant_params - num_bits
|
减小内存占用
|
该配置参数会影响模型精度。
|
-
|
-
|
量化参数配置:AMCT
weight_quant_params - num_bits配置为4
|
weight_quant_params - num_bits
|
减小内存占用
|
该配置参数会影响模型精度。
|
-
|
-
|
KO模块参数:svp_npu_max_stream_num来更改可用流的个数
|
svp_npu_max_stream_num
|
减小内存占用
|
当流数大于svp_npu_max_stream_num会报错
|
-
|
svp_npu module param:max_stream_num
|
KO模块参数:svp_npu_max_task_node_num来更改任务节点个数
|
svp_npu_max_task_node_num
|
减小内存占用
|
当节点数大于svp_npu_max_task_node_num会报错
|
-
|
svp_npu module param:max_task_node_num
|
KO模块参数:svp_npu_max_event_num来更改Event个数
|
svp_npu_max_event_num
|
减小内存占用
|
当Event数大于svp_npu_max_event_num会报错
|
-
|
svp_npu module param:max_event_num
|
workbuf共享:同一条流上的多个模型之间可以使用同一块workbuf,从而减少MMZ内存占用
|
-
|
减少MMZ内存占用
|
客户必须保证workbuf足够,否则会踩内存
|
-
|
-
|
workbuf与输入输出内存复用。
ATC参数-- inout_mem_reuse_mode/inout_mem_reuse_name
|
-
|
通过复用输入输出内存来减少workbuf需要的大小
|
如果是需要输入/输出连续的内存,则申请内存时需要申请连续内存;如果输入内存复用会破坏输入内存的源数据
|
-
|
-
|
IVE
措施
|
相关接口/参数
|
收益
|
影响
|
注意
|
proc信息
|
|---|
模块参数:max_node_num控制链表节点个数
|
max_node_num
|
默认值128,减小可节省MMZ内存
|
当节点数大于max_node_num会报错
|
-
|
module param
:max_node_num
|
VDA
须知:
Hi3519DV500/Hi3516DV500/Hi3516CV610/Hi3511CV100不支持VDA。
加载vda模块ko时设置模块参数最大通道数g_vda_max_chn_num,省OS内存。
PCIV
参考PCIV章节。
GDC
须知:
具体参见《MPP 媒体处理软件 V6.0 开发参考》“几何畸变矫正子系统”章节。
Hi3516CV610/Hi3511CV100不支持GDC。
措施
|
相关模块参数
|
收益
|
影响
|
注意
|
proc信息
|
|---|
设置GDC支持的最大job数
|
g_max_gdc_job
|
默认值16,按需减小可节省内存
|
job数量过少会限制GDC性能
|
-
|
module params:g_max_job_num
|
设置GDC支持的最大task数
|
g_max_gdc_task
|
默认值50,按需减小可节省内存
|
task数量过少会限制GDC性能
|
-
|
module params:g_max_task_num
|
设置GDC支持的最大node数
|
g_max_gdc_node
|
默认值50,按需减小可节省内存
|
node数量过少会限制GDC性能
|
-
|
module params:g_max_node_num
|
GDC模块主要是OS内存和node用的mmz。考虑场景的减小最大job数、最大task数和最大node数可以减少OS占用内存以及node占用的MMZ内存。
CIPHER
措施
|
相关模块参数
|
收益
|
影响
|
注意
|
proc信息
|
|---|
Hash初始化内部固定内存大小配置
|
HASH_MAX_DEPTH;
- ss_mpi_cipher_hash_updata/in_data_len
- ss_mpi_cipher_hash_final/out_hash_len
|
驱动内部确定申请的MMZ内存的长度节省
|
可减小链表深度来减小链表内存总大小;也可根据实际场景修改HASH消息的长度,减小申请的物理内存。
|
-
|
cat/proc/umap/cipher
|
Cipher驱动模块初始化内部固定内存大小配置
|
SYMC_MAX_LIST_NUM;
CHIP_AES_CCM_GCM_SUPPORT宏关闭
|
驱动内部确定申请的MMZ内存的长度节省
|
可减小链表深度减少链表的内存总大小;可根据实际场景不适用CCM/GCM就删除给CCM/GCM申请的padding buffer
|
-
|
cat/proc/umap/cipher
|
按场景合理设计cipher加解密时内存长度
|
- ss_mpi_cipher_encrypt/byte_len
- ss_mpi_cipher_decrypt/byte_len
|
由用户层接口传入的MMZ内存申请的长度节省
|
由用户层接口根据实际场景传入合适的MMZ内存申请的长度,可节省部分MMZ内存
|
-
|
cat/proc/umap/cipher
|
ISP
措施
|
相关接口/参数
|
收益
|
影响
|
注意
|
proc信息
|
|---|
离线通路时,按场景合理设置be config buffer个数。在线场景默认为0。
|
ss_mpi_isp_set_ctrl_param:be_buf_num
|
可节省部分MMZ内存
|
需要用户保证buffer大小设置合理,否则可能会出现获取be config buffer异常。
Hi3516CV610建议:AIISP场景最小配置5个,无AIISP场景最小配置3个。
|
-
|
cat/proc/umap/isp
module/control param:be_buf_num
|
UVC
措施
|
相关接口
|
收益
|
影响
|
注意
|
proc信息
|
|---|
设置 uvc_host 队列深度
|
ss_mpi_uvc_host_set_chn_attr
|
队列深度即缓存帧队列深度;调小 depth 可节省对应缓存个数。
|
需要在用户空间从通道获取帧时 depth 至少设为1;不需要时建议不设置。
|
仅 Hi3511CV100 支持。
|
cat /proc/umap/uvc_host:depth
|
其它措施
优化镜像size
优化镜像size的方法参见第5章节“flash内存调优”。
限制栈大小
默认的栈大小为8192KB,如果内存较小时,会导致线程创建不成功。根据实际的业务需要的栈空间,修改栈的限制大小为1024KB,如果业务更少则可以改成512KB或者更小。
有两种方法可以修改栈大小:
- 使用 ulimit –s 1024 命令,在应用程序启动之前调用一次;
- 在main函数最开始调用函数 pthread_attr_setstacksize 也可实现对单个应用程序修改栈空间的目的。
优化代码中内存使用
优化代码中内存使用,特别是对栈、堆、常量、全局变量的使用,主要需要注意:
- 避免应用程序代码中申请后不用的变量;
- 不要随意申请大块的内存,够用即可;
- 冗余的内存使用还包含不用的功能模块的初始化。
应用程序中禁用fork、system等进程创建函数
由于主进程的数据段占用内存已经很多,如果fork子进程必定消耗大量内存而且会有大概率失败,那么应用程序中应该禁用fork、system等进程创建函数:如bspmm调用、mkfs.vfat调用等。
CMA相关
在Hi3519DV500项目中,系统默认打开了CMA,Hi3516CV610/Hi3511CV100默认关闭了CMA。打开CMA后,系统会默认保留部分内存。这部分保留的内存可能只会使用其中一部分。因此,为了节省内存,客户可以采取以下两种方法:
-
调整系统保留的内存。
客户可以通过cat /proc/meminfo命令查看当前系统保留的CMA内存和这部分内存的使用情况,其中CmaTotal是当前系统保留的CMA内存,CmaFree是剩余的内存:
CmaTotal: 16384 kB
CmaFree: 16068 kB
客户可以通过修改内核配置调整保留内存的大小:
Device Drivers->Generic Driver Options ->Size in Mega Bytes
修改内核配置后,请重新编译内核。
-
关闭CMA。
如果客户不使用CMA功能,可以通过修改内核配置关闭CMA:
Kernel Features->Contiguous Memory Allocator
修改内核配置后,请重新编译内核和ot_osal.ko以及ot_mmz.ko。
Hi3516CV610典型媒体通路公共VB分配指导
我们作如下假设:
An:FE输出给BE的公共VB,n表示VB序号。
Bn:BE输出给VPSS的公共VB,n表示VB序号。
Cn:VPSS[CH0]输出给VENC的公共VB,n表示VB序号。
Dn:VENC大码流缩小输出给VENC小码流的公共VB,n表示VB序号。
En:VPSS[CH1]输出给智能的公共VB,n表示VB序号。
Fn:VPSS[CH2]输出给智能的公共VB,n表示VB序号。
同理,AAn、BBn、CCn、DDn、EEn、FFn表示第二路的VB序号标记。
单路在线卷绕原分辨率编码场景
图 1 单路在线卷绕原分辨率编码场景
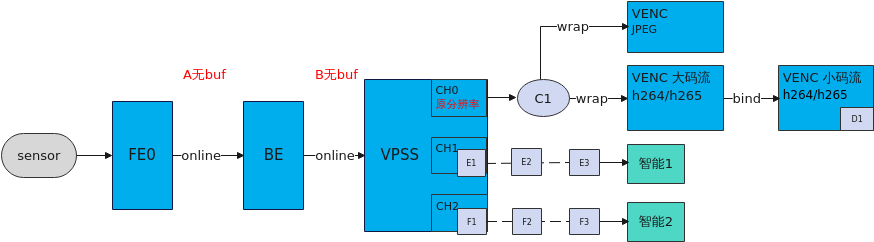
C1是卷绕buffer,其它D1、E1、E2、E3、F1、F2、F3都是完整帧buffer。
单路离线卷绕放大编码场景
图 1 单路离线卷绕放大编码场景
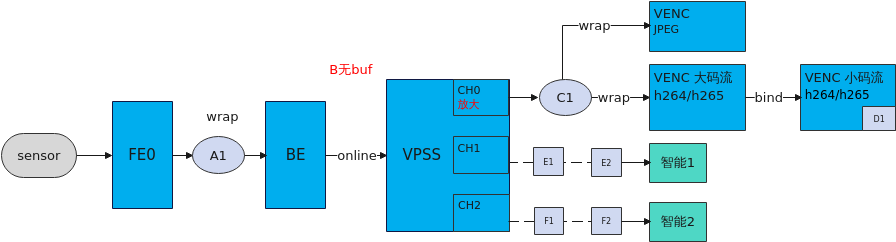
A1和C1是卷绕buffer,其它D1、E1、E2、F1、F2都是完整帧buffer。
双路离线卷绕编码场景
图 1 双路离线卷绕编码场景
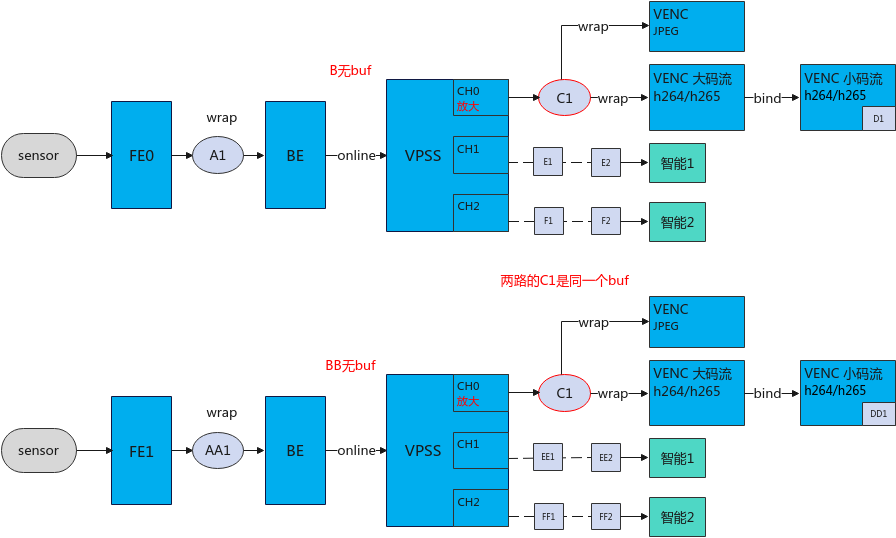
A1、AA1、C1是卷绕buffer,其中两路的C1是同一个buffer。
第一路的D1、E1、E2、F1、F2和第二路的DD1、EE1、EE2、FF1、FF2都是完整帧buffer。
双路离线卷绕场景中,如使用sensor主模式,两路的帧起始信号时间不固定,卷绕获取的内存收益不是最优。
双路离线卷绕场景中,FE和BE之间的VI卷绕,可使用sensor从模式控制双路输入时间差,获取最大的内存收益,具体的步骤如下:
-
在sensor从模式驱动中调用 ss_mpi_isp_set_sns_slave_attr(请见《ISP 开发参考》)接口配置VS/HS信号。
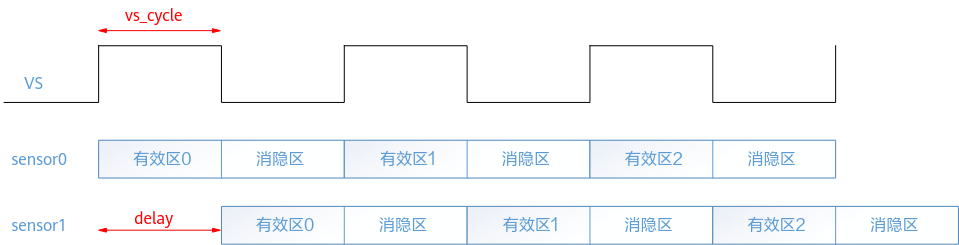
图中:
-
vs_cycle可通过ss_mpi_isp_set_sns_slave_attr配置,该参数作用是配置VS信号的占空比。vs_cycle的计算方法由帧率和双路输入的有效像素共同决定。
假设sensor的时钟是24MHz,sensor0输入为1080P@30fps,sensor1输入为720P@30fps,则vs_cycle的计算结果为:
vs_time = 24000000 / 30;
vs_cycle = vs_time * (1920 * 1080) / (1920 * 1080 + 1280 * 720);
配置好vs_time和vs_cycle即可得到上图的VS时序。
-
sensor0从模式驱动配置为上升沿有效,sensor1从模式驱动设置为下降沿有效。vs_cycle数即为两路帧起始信号时间差delay,只有正确配置delay值后,步骤2获取的卷绕行才能正常卷绕。
- sensor0和sensor1分辨率相同可获得最优的内存收益。
-
调用 ss_mpi_sys_get_vi_wrap_buffer_line(请见《MPP 媒体处理软件 V6.0 开发参考》“系统控制”章节)接口,获取两路卷绕行。sensor从模式的标志是is_slave设置为TD_TRUE。
- 调用 ss_mpi_vi_set_pipe_buf_wrap_attr(请见《MPP 媒体处理软件 V6.0 开发参考》“视频输入”章节)接口设置卷绕行。
Flash内存调优
综述
Flash内存调优主要是减少flash里面存储的文件大小。对应SDK来说,主要是uboot、内核镜像、文件系统、媒体lib和ko。
通过编译优化镜像size
通过代码裁剪编译优化镜像size
为了提升开发效率和降低维护成本,一般是多产品共平台代码,但每个产品都有功能差异,功能代码尽量精细化使用宏隔离,每个产品有独立的功能宏集合配置脚本,即不破坏平台兼容多产品,同时又有利于每款产品的size小型化。
- 客户应用程序代码,需要客户自行分析裁剪。
- Uboot、内核、文件系统的size小型化裁剪请参见《Hi35xxVxxx 系统小型化说明》。
- 媒体Debug日志(/dev/logmpp)也可以做裁剪,使用NOLOG版本的SDK开发包,名称是“Hi3516CV610_SDK_NOLOG_Vx.x.x.x.tgz”。以Hi3516CV610为例,NOLOG版本的驱动size减少约800KB。(注意:NOLOG版本是没有logmpp打印的,不利于问题定位,如果需要使用,建议仅在量产版本使用)
须知:
仅Hi3516CV610支持NOLOG版本。
将ko编进内核镜像
SDK的媒体ko默认是独立加载的,将ko编进内核镜像可以减少启动镜像size和加速启动时间。将ko编进内核镜像的方法参见SDK软件开发包里obj目录下的《readme.md》,以Hi3516CV610为例,obj目录的路径是"smp/a7_linux/source/out/obj"。此方法在Hi3516CV610上size减少约500KB。
自动优化掉不使用的函数
编译选项说明:
-ffunction-sections 编译源文件时,为每个function分配独立的section。
-fdata-sections 编译源文件时,为每个data分配独立的section。
--gc-sections 链接时,以section为最小处理单元,只有当section中有symbol被使用,才将该section链接到output中。
我们在编译选项里面加上 -ffunction-sections -fdata-sections, 然后在链接选项里面加上 -Wl,-gc-sections(注意:一旦使用-Wl,-gc-sections将无法使用gdb调试,也无法使用gprof)
- SDK MPP生成库时,Makefile.param已加入-ffunction-sections -fdata-sections编译选项;客户在链接生成应用程序时加入 -Wl,-gc-sections,能有效减小应用程序大小,剔除掉没有使用到的函数。
- 客户自己开发的应用程序静态库,也需按如上方法配置。
说明:
此方法仅对静态库链接有效。
标准C库/C++库链接裁剪
标准C库/C++库是个大集合,产品程序可能仅使用了标准库中不到一半的函数,此时可考虑标准库的链接裁剪,自动优化掉不使用的函数。
如果产品的可执行程序不多,建议使用标准库的静态库,可执行程序再配合链接选项”-Wl,-gc-sections”优化掉不使用的函数,动态库则不需要安装到产品设备里。
可执行程序使用标准库的静态库方法:CFLAGS += -static
注意:
最终需以实测所有可执行程序使用静态库和动态库的镜像size哪种方式较小为准。
媒体lib和ko依赖关系
对于媒体lib和ko,业务不需要的功能可以不加载相应的lib和ko,减少产品镜像size。媒体lib和ko依赖关系见下表。
表 1 Hi3519DV500/Hi3516DV500的媒体lib和ko依赖关系
功能描述
|
ko
|
配套lib库
|
扩展依赖
|
备注
|
|---|
基础模块
|
sys_config.ko
|
-
|
-
|
基础模块的ko必须加载
|
ot_osal.ko
|
-
|
-
|
ot_mmz.ko
|
libss_mpi_sysmem
|
-
|
ot_base.ko
|
-
|
-
|
ot_vb.ko
|
libss_mpi
|
-
|
ot_vca.ko
|
-
|
-
|
ot_sys.ko
|
libss_mpi
libss_mpi_sysbind
|
-
|
ot_pm.ko
|
-
|
-
|
-
|
libsecurec
|
华为安全函数库
|
视频采集
|
ot_mipi_rx.ko
|
-
|
-
|
-
|
ot_vi.ko
|
libss_mpi
|
通道后处理coverex/overlayex依赖ot_vpp.ko、ot_vgs.ko、ot_rgn.ko
|
无通道后处理功能可以裁剪扩展依赖的ko
|
sensor
|
-
|
libsns_xxx
|
- I2C协议的sensor依赖ot_sensor_i2c.ko
- SPI协议的sensor依赖ot_sensor_spi.ko
|
每款型号的sensor对应一个独立的sensor库
|
ISP
|
ot_isp.ko
|
libacs
libbnr
libcalcflicker
libdehaze
libdrc
libextend_stats
libir_auto
libldci
libss_mpi_ae
libss_mpi_awb
libss_mpi_isp
libss_mpi_thermo
|
- 控制P光圈依赖ot_piris.ko
- 控制DC光圈依赖ot_pwm.ko
- 在中断里注册同步任务获取统计信息的示例:ot_sample_ist.ko
|
1、BT1120/BT656时序可以不加载ot_isp.ko
2、扩展依赖的ko可以按需加载
|
AIISP
|
ot_aiisp.ko
同时依赖ot_vi.ko、ot_isp.ko、ot_svp_npu.ko
|
libhi_mpi_aibnr
libhi_mpi_ai3dnr
libhi_mpi_aidrc
|
-
|
-
|
黑白彩色双路融合
|
ot_mcf.ko
同时依赖ot_vi.ko、ot_vpss.ko、ot_vgs.ko
|
libss_mpi_mcf
|
通道后处理功能
coverex/overlayex/lineex/corner_rectex/mosaicex/cover/corner_rect/mosaic
依赖ot_vpp.ko、ot_rgn.ko
|
无通道后处理功能可以裁剪扩展依赖的ko
|
视频防抖
|
ot_dis.ko
同时依赖ot_vi.ko、ot_vpp.ko、ot_vpss.ko、ot_gdc.ko
|
libss_mpi
|
-
|
-
|
ot_motionfusion.ko
|
-
|
外设驱动依赖ot_spi.ko、motionsensor_chip.ko、motionsensor_mng.ko,可根据单板外设替换
|
无陀螺仪防抖可以不加载ot_motionfusion.ko和ot_gyrodis.ko
|
ot_gyrodis.ko
|
-
|
视频矫正
|
ot_gdc.ko
同时依赖ot_vpss.ko、ot_vpp.ko
|
libss_mpi
|
-
|
-
|
视频处理
|
ot_vpss.ko
|
libss_mpi
|
- 通道后处理coverex/overlayex/lineex/corner_rectex/mosaicex/cover/corner_rect/mosaic时依赖ot_vpp.ko、ot_rgn.ko、ot_vgs.ko
- VGS组依赖ot_vgs.ko
- 视频拼接依赖ot_vgs.ko
- 缩放超过16倍依赖ot_vgs.ko
|
-
|
ot_vgs.ko
|
libss_mpi
|
-
|
-
|
视频编码
|
ot_venc.ko
|
libss_mpi
|
- 编码缩小依赖ot_vgs.ko
- 非linear格式YUV输入依赖ot_vgs.ko
- osd依赖ot_rgn.ko
|
- 无缩放且linear格式输入可以不加载ot_vgs.ko
- 无osd可以不加载ot_rgn.ko
|
ot_chnl.ko
|
-
|
-
|
ot_rc.ko
|
-
|
码率控制算法模块
|
ot_h265e.ko
|
-
|
无H265编码可以不加载ot_h265e.ko
|
ot_h264e.ko
|
-
|
无H264编码可以不加载ot_h264e.ko
|
ot_jpege.ko
|
-
|
无JPEGE编码可以不加载ot_jpege.ko
|
视频解码
|
ot_vdec.ko
|
libss_mpi
|
- 旋转依赖ot_vgs.ko
- 内核态调整线程优先级依赖ot_user.ko
|
无解码旋转功能可以不加载ot_vgs.ko
|
ot_vfmw.ko
|
-
|
无H264/H265视频解码可以不加载ot_vfmw.ko
|
ot_chnl.ko
|
-
|
无JPEG解码可以不加载ot_jpegd.ko
|
ot_jpegd.ko
|
-
|
显示
|
ot_vo.ko
同时依赖ot_vgs.ko
|
libss_mpi
|
cover/overlay依赖ot_rgn.ko和ot_vgs.ko
|
-
|
ot_vo_dev.ko
|
-
|
-
|
gfbg.ko
|
-
|
-
|
无图形显示功能可以不加载gfbg.ko
|
ot_tde.ko
|
libot_tde
|
-
|
无图形显示功能可以不加载gfbg.ko
|
ot_mipi_tx.ko
|
-
|
-
|
没有mipi输出可以不加载ot_mipi_tx.ko
|
音频
|
ot_acodec.ko
|
libss_mpi_audio
libaac_comm
libaac_dec
libaac_enc
libaac_sbr_dec
libaac_sbr_enc
libdnvqe
libmp3_dec
libopus
libss_mpi_audio_adp
libupvqe
libvoice_engine
libvqe_aec
libvqe_agc
libvqe_anr
libvqe_eq
libvqe_hpf
libvqe_record
libvqe_res
libvqe_talkv2
libvqe_common(动态库的公共库,静态库不涉及)
libmp3_enc.so(只支持动态库)
libmp3_lame.so(只支持动态库)
|
-
|
-
|
ot_ai.ko
|
-
|
-
|
ot_aio.ko
|
-
|
-
|
ot_ao.ko
|
-
|
-
|
ot_aenc.ko
|
-
|
-
|
ot_adec.ko
|
-
|
-
|
智能
|
ot_svp_npu.ko
|
libsvp_acl
libsvp_acl_sec
libsvp_aicpu
libprotobuf-c
|
AI模型保护依赖ot_smmz_agent.ko、ot_cipher.ko、libss_mpi_km.ko,依赖OPTEE相关库
|
aicpu仅有动态库,没有aicpu任务可以裁剪
|
ot_ive.ko
|
libot_ivs_md
libss_mpi_ive
|
-
|
-
|
ot_dpu_rect.ko
|
libss_mpi_dpu_rect
|
-
|
不使用DPU做图形矫正功能可以不加载ot_dpu_rect.ko
|
ot_dpu_match.ko
|
libss_mpi_dpu_match
|
-
|
不使用DPU做图形匹配功能可以不加载ot_dpu_match.ko
|
安全
|
-
|
libbsptee.a
libdl.a
libmbedtls.a
libsecurec.a
libsvp_npu_ta.a
libutee.a
libutils.a
|
-
|
OPTEE在TEE侧的库,在独立的目录a55_optee/lib里。
|
-
|
libteec.a
libteec.so.1
|
-
|
OPTEE在REE侧的库
|
-
|
libmbedtls_harden_adapt.a
libmbedtls_crypto.a
|
-
|
密码算法开源标准库
|
ot_cipher.ko
|
libss_mpi_cipher
|
依赖ot_km.ko
|
密码算法硬件加速模块
|
ot_km.ko
|
libss_mpi_km
|
-
|
秘钥管理模块
|
ot_otp.ko
|
libss_mpi_otp
|
-
|
kernel环境无OTP烧写功能可以不加载ot_otp.ko
|
ot_hardware_cryptodev.ko
|
-
|
依赖ot_cipher.ko、ot_km.ko、ot_otp.ko
|
linux crypto硬化加速模块
|
UVC
|
ot_uvc.ko
|
libss_mpi_uvc
|
-
|
-
|
热感去条纹
|
依赖ot_svp_npu.ko
|
libss_mpi_aidestrip
|
-
|
-
|
SNAP
|
依赖ot_vi.ko
|
libss_mpi_snap
|
-
|
-
|
HEIF编解码
|
-
|
libheif
libfileformat
|
-
|
-
|
看门狗
|
ot_wdt.ko
|
-
|
-
|
没有看门狗业务可以不加载ot_wdt.ko
|
AD转换
|
ot_adc.ko
|
-
|
-
|
没有相关AD外设可以不加载ot_adc.ko
|
内核态事件回调机制
|
ot_user.ko
|
-
|
-
|
vdec/vo/ao等模块的内核态实时事件回调机制,解码线程优先级等
|
表 2 Hi3516CV610的媒体lib和ko依赖关系
功能描述
|
ko
|
配套lib库
|
扩展依赖
|
备注
|
|---|
基础模块
|
sys_config.ko
|
-
|
-
|
基础模块的ko必须加载
|
ot_osal.ko
|
-
|
-
|
ot_mmz.ko
|
libss_mpi_sysmem
|
-
|
ot_base.ko
|
-
|
-
|
ot_vb.ko
|
libss_mpi
|
-
|
ot_vca.ko
|
-
|
-
|
ot_sys.ko
|
libss_mpi
libss_mpi_sysbind
|
-
|
ot_pm.ko
|
-
|
-
|
-
|
libsecurec
|
华为安全函数库
|
视频采集
|
ot_mipi_rx.ko
|
-
|
-
|
-
|
ot_vi.ko
|
libss_mpi
|
通道后处理coverex依赖ot_vpp.ko、ot_vgs.ko、ot_rgn.ko
|
无通道后处理功能可以裁剪扩展依赖的ko
|
sensor
|
-
|
libsns_xxx
|
- I2C协议的sensor依赖ot_sensor_i2c.ko
- SPI协议的sensor依赖ot_sensor_spi.ko
|
每款型号的sensor对应一个独立的sensor库
|
ISP
|
ot_isp.ko
|
libacs
libbnr
libcalcflicker
libdehaze
libdrc
libextend_stats
libir_auto
libldci
libss_mpi_ae
libss_mpi_awb
libss_mpi_isp
|
- 控制P光圈依赖ot_piris.ko
- 控制DC光圈依赖ot_pwm.ko
- 在中断里注册同步任务获取统计信息的示例:ot_sample_ist.ko
|
1、BT1120/BT656时序可以不加载ot_isp.ko
2、扩展依赖的ko可以按需加载
|
ot_aiisp.ko
|
libaiisp
libss_mpi_aibnr
|
除依赖基础模块外,智能处理依赖ot_svp_npu.ko和libsvp_acl,ISP处理依赖libss_mpi_isp
|
-
|
视频处理
|
ot_vpss.ko
|
libss_mpi
|
- 通道后处理coverex/lineex/corner_rectex/cover/corner_rect时依赖ot_vpp.ko、ot_rgn.ko、ot_vgs.ko
|
-
|
ot_vpp.ko
|
-
|
ot_rgn.ko、ot_vgs.ko
|
-
|
ot_vgs.ko
|
libss_mpi
|
-
|
-
|
视频编码
|
ot_venc.ko
|
libss_mpi
|
- 编码缩小依赖ot_vgs.ko
- osd依赖ot_rgn.ko
|
- 无缩放且linear格式输入可以不加载ot_vgs.ko
- 无osd可以不加载ot_rgn.ko
|
ot_chnl.ko
|
-
|
-
|
ot_rc.ko
|
-
|
码率控制算法模块
|
ot_h265e.ko
|
-
|
无H265编码可以不加载ot_h265e.ko
|
ot_h264e.ko
|
-
|
无H264编码可以不加载ot_h264e.ko
|
ot_svac3e.ko
|
-
|
无SVAC3.0编码可以不加载ot_svac3e.ko
|
ot_jpege.ko
|
-
|
无JPEGE编码可以不加载ot_jpege.ko
|
音频
|
ot_acodec.ko
|
libss_mpi_audio
libaac_comm
libaac_dec
libaac_enc
libaac_sbr_dec
libaac_sbr_enc
libdnvqe
libmp3_dec
libopus
libss_mpi_audio_adp
libupvqe
libvoice_engine
libvqe_aec
libvqe_agc
libvqe_anr
libvqe_eq
libvqe_hpf
libvqe_record
libvqe_res
libvqe_talkv2
libvqe_common(动态库的公共库,静态库不涉及)
libmp3_enc.so(只支持动态库)
libmp3_lame.so(只支持动态库)
|
-
|
-
|
ot_ai.ko
|
-
|
-
|
ot_aio.ko
|
-
|
-
|
ot_ao.ko
|
-
|
-
|
ot_aenc.ko
|
-
|
-
|
ot_adec.ko
|
-
|
-
|
智能
|
ot_svp_npu.ko
|
libsvp_acl
libsvp_aicpu
libprotobuf-c
|
依赖基础模块驱动ot_osal.ko、ot_mmz.ko、ot_base.ko、ot_sys.ko和库libss_mpi_sysmem、libsecurec
|
aicpu仅有动态库,没有aicpu任务可以裁剪
|
ot_ive.ko
|
libot_ivs_md
libss_mpi_ive
|
- 依赖基础模块驱动ot_osal.ko、ot_mmz.ko、ot_base.ko、ot_sys.ko和库libss_mpi_sysmem、libsecurec
- 依赖ot_svp_npu.ko和对应的lib库
|
-
|
安全
|
-
|
libmbedtls_harden_adapt.a
|
-
|
密码算法开源标准库
|
ot_cipher.ko
|
libss_mpi_cipher
|
依赖ot_km.ko
|
密码算法硬件加速模块
|
ot_km.ko
|
libss_mpi_km
|
-
|
秘钥管理模块
|
ot_otp.ko
|
libss_mpi_otp
|
-
|
kernel环境无OTP烧写功能可以不加载ot_otp.ko
|
ot_hardware_cryptodev.ko
|
-
|
依赖ot_cipher.ko、ot_km.ko、ot_otp.ko
|
linux crypto硬化加速模块
|
UVC
|
ot_uvc.ko
|
libss_mpi_uvc
|
-
|
-
|
看门狗
|
ot_wdt.ko
|
-
|
-
|
没有看门狗业务可以不加载ot_wdt.ko
|
AD转换
|
ot_adc.ko
|
-
|
-
|
没有相关AD外设可以不加载ot_adc.ko
|
内核态事件回调机制
|
ot_user.ko
|
-
|
-
|
ao等模块的内核态实时事件回调机制等
|
表 3 Hi3511CV100的媒体lib和ko依赖关系
功能描述
|
ko
|
配套lib库
|
扩展依赖
|
备注
|
|---|
基础模块
|
sys_config.ko
|
-
|
-
|
基础模块的ko必须加载
|
ot_osal.ko
|
-
|
-
|
ot_mmz.ko
|
libss_mpi_sysmem
|
-
|
ot_base.ko
|
-
|
-
|
ot_vb.ko
|
libss_mpi
|
-
|
ot_vca.ko
|
-
|
-
|
ot_sys.ko
|
libss_mpi
libss_mpi_sysbind
|
-
|
-
|
libsecurec
|
华为安全函数库
|
多片互联传输
|
ot_vsips.ko
(Hi3511CV100作从片)
|
libss_mpi_vsips(多片级联,主片侧有该库)
|
|
多片互联场景必须加载
|
视频采集
|
ot_mipi_rx.ko
|
-
|
-
|
非mipi互联场景,可以裁剪mipi vi相关驱动与库。
|
ot_vi.ko
|
libss_mpi
|
通道后处理:
|
无通道后处理功能可以裁剪扩展依赖的ko
|
视频处理
|
ot_vpss.ko
|
libss_mpi
|
- 组上luma功能依赖ot_vgs.ko
- 组上Overlay/Mosaic/Cover/Corner_rect功能,通道Mosaic/Cover/Corner_rect功能依赖ot_rgn.ko
- 通道缩小超过16倍时依赖ot_vgs.ko
- 通道后处理固定角度旋转/Luma功能依赖ot_vpp.ko、ot_vgs.ko
- 通道后处理CoverEx/MosaicEx/LineEx/Corner_rectEx/OverlayEx功能依赖ot_vpp.ko、ot_rgn.ko、ot_vgs.ko
- 扩展通道依赖ot_vpp.ko、ot_vgs.ko
- 附属信息依赖ot_vsips.ko
|
-
|
ot_vpp.ko
|
-
|
ot_rgn.ko、ot_vgs.ko
|
-
|
ot_vgs.ko
|
libss_mpi
|
-
|
-
|
视频编码
|
ot_venc.ko
|
libss_mpi
|
- 编码缩小依赖ot_vgs.ko
- osd依赖ot_rgn.ko
|
- 无缩放且linear格式输入可以不加载ot_vgs.ko
- 无osd可以不加载ot_rgn.ko
|
ot_chnl.ko
|
-
|
-
|
ot_rc.ko
|
-
|
码率控制算法模块
|
ot_h265e.ko
|
-
|
无H265编码可以不加载ot_h265e.ko
|
ot_h264e.ko
|
-
|
无H264编码可以不加载ot_h264e.ko
|
ot_svac3e.ko
|
-
|
无SVAC3.0编码可以不加载ot_svac3e.ko
|
视频解码
|
ot_vdec.ko
|
libss_mpi
|
旋转依赖ot_vgs.ko
|
无解码旋转功能可以不加载ot_vgs.ko
无视频解码可以不加载ot_vfmw.ko ot_vdec.ko
|
ot_vfmw.ko
|
|
-
|
区域管理
|
ot_rgn.ko
|
libss_mpi
|
-
|
快速拷贝在未加载ot_vgs.ko时使用实现
|
安全
|
-
|
libmbedtls_harden_adapt.a
|
-
|
密码算法开源标准库
|
ot_cipher.ko
|
libss_mpi_cipher
|
依赖ot_km.ko
|
密码算法硬件加速模块
|
ot_km.ko
|
libss_mpi_km
|
-
|
秘钥管理模块
|
ot_otp.ko
|
libss_mpi_otp
|
-
|
kernel环境无OTP烧写功能可以不加载ot_otp.ko
|
ot_hardware_cryptodev.ko
|
-
|
依赖ot_cipher.ko、ot_km.ko、ot_otp.ko
|
linux crypto硬化加速模块
|
UVC
|
ot_uvc_host.ko
|
libss_mpi_uvc_host
|
附属信息依赖ot_vsips.ko
|
非UVC场景可以裁剪掉uvc_host,如仅使用虚拟网络可以参考《多片互联传输开发指南》章节“
通过 USB 虚拟网络传输数据”。
|
PCIV Host
|
pcie/vendor_dev_host.ko
|
-
|
-
|
PCIV host侧,非PCIV互联场景可裁剪
|
pcie/irq_map_host.ko
|
-
|
-
|
pcie/mcc_drv_host.ko
|
-
|
-
|
pcie/mcc_usrdev_host.ko
|
-
|
-
|
pcie/pcit_dma_host.ko
|
-
|
-
|
ot_pciv.ko
|
libss_mpi_pciv
|
附属信息依赖ot_vsips.ko,vpss绑定依赖ot_vpss.ko
|
PCIV Slave
|
pcie/vendor_dev_slv.ko
|
-
|
-
|
PCIV slave侧,非PCIV互联场景可裁剪
|
pcie/irq_map_slv.ko
|
-
|
-
|
pcie/mcc_drv_slv.ko
|
-
|
-
|
pcie/mcc_usrdev_slv.ko
|
-
|
-
|
pcie/pcit_dma_slv.ko
|
-
|
-
|
ot_pciv.ko
|
libss_mpi_pciv
|
附属信息依赖ot_vsips.ko,vpss绑定依赖ot_vpss.ko
|
看门狗
|
ot_wdt.ko
|
-
|
-
|
没有看门狗业务可以不加载ot_wdt.ko
|
AD转换
|
ot_adc.ko
|
-
|
-
|
没有相关AD外设可以不加载ot_adc.ko
|
内核态事件回调机制
|
ot_user.ko
|
-
|
-
|
ao等模块的内核态实时事件回调机制等
|
devstat
|
ot_devstat.ko
|
libss_mpi_devstat
|
-
|
按需手动加载
|
音频库裁剪说明
说明:
相关接口/参数具体使用方式和注意事项参见《MPP 媒体处理软件 V6.0 开发参考》"音频”章节。
表 1 Hi3519DV500/Hi3516DV500、Hi3516CV610音频库裁剪方案
音频库
|
涉及功能
|
是否可裁剪
|
可裁剪的情况
|
|---|
libaac_comm.a(.so)
|
AAC编解码
|
是
|
AAC编码功能和解码功能都不使用时。
|
libaac_dec.a(.so)
|
AAC解码
|
是
|
不使用AAC解码功能时。
|
libaac_enc.a(.so)
|
AAC编码
|
是
|
不使用AAC编码功能时。
|
libaac_sbr_dec.a(.so)
|
AAC SBR解码
|
是
|
1、不使用AAC解码功能。
2、不使用EAAC、EAACPLUS、AACELD类型解码时。
|
libaac_sbr_enc.a(.so)
|
AAC SBR编码
|
是
|
1、不使用AAC编码功能。
2、不使用EAAC、EAACPLUS、AACELD类型编码时。
|
libdnvqe.a(.so)
|
AO下行通路VQE
|
否
|
无
|
libmp3_enc.so
|
MP3编码
|
是
|
不使用MP3编码功能时。
|
libmp3_lame.so
|
MP3编码
|
是
|
不使用MP3编码功能时。
|
libmp3_dec.a(.so)
|
MP3解码
|
是
|
不使用MP3解码功能时。
|
libopus.a(.so)
|
OPUS编解码
|
是
|
OPUS编码功能和解码功能都不使用时。
|
libot_bcd.a(.so)
|
哭声检测
|
是
|
不使用哭声检测功能时。
|
libss_mpi_audio_adp.a(.so)
|
AAC、MP3、OPUS编解码
|
是
|
AAC,MP3和OPUS编解码功能都不使用时。
|
libupvqe.a(.so)
|
AI上行通路VQE
|
否
|
无
|
libvoice_engine.a(.so)
|
G711、G726、ADPCM编解码
|
否
|
无
|
libvqe_common.so
|
TalkVQE 公共功能
|
是
|
不使用TalkVQE的AEC、AGC、ANR、EQ功能模块时
|
libvqe_aec.a(.so)
|
TalkVQE 回声抵消
|
是
|
AI上行通路不使用TalkVQE回声抵消功能时。
|
libvqe_agc.a(.so)
|
TalkVQE 自动增益控制
|
是
|
AI上行通路和AO下行通路都不使用TalkVQE自动增益控制功能时。
|
libvqe_anr.a(.so)
|
TalkVQE 语音降噪
|
是
|
AI上行通路和AO下行通路都不使用TalkVQE语音降噪功能时。
|
libvqe_eq.a(.so)
|
TalkVQE 均衡处理器
|
是
|
AI上行通路和AO下行通路都不使用TalkVQE均衡处理器功能时。
|
libvqe_hpf.a(.so)
|
TalkVQE 高通滤波
|
是
|
AI上行通路和AO下行通路都不使用TalkVQE高通滤波功能时。
|
libvqe_record.a(.so)
|
RecordVQE
|
是
|
AI上行通路不使用RecordVQE功能时。
|
libvqe_res.a(.so)
|
重采样
|
是
|
AI和AO通道不使能重采样,且AI和AO设置的采样率与VQE工作采样率一致时。
|
libvqe_talkv2.a(.so)
|
TalkVQEV2
|
是
|
AI上行通路不使用TalkVQEV2功能时。
|
libss_mpi_audio.a(.so)
|
音频基础库
|
否
|
无
|